作者 | 朱世耘
编辑 | 邱锴俊
「目前为止,我没有听到任何一家做到了(原教旨定义下的)端到端。没有任何一家,包括特斯拉。 」
一位国内一线智驾车企的工程师如是说。
但与此同时,特斯拉、华为、小鹏作为行业公认的第一战队,都已上车或即将量产端到端智驾系统。小米汽车推送了端到端的泊车系统,蔚来也要在主动安全领域应用端到端方法。
供应商中,地平线的端到端感知系统 Sparse4D 将在明年亮相,商汤绝影的端到端智驾方案 Uni AD 也计划将在明年量产落地。
显然,「黑盒」的不仅是端到端技术本身。 《电动汽车观察家》访问多位工程师、企业研发负责人和投资人,试图了解端到端产业落地的部分真相和进展。
端到端,高端的「端」
尽管「端到端「已经成为智驾用户群中」高端「的代名词,但到底什么是端到端?
去年年底,特斯拉创始人马斯克在 FSD V12 演示中有段端到端的「原教旨」描述:V12 消除了 30 万行 C++代码,V12 中是纯粹的神经网络, 实现了输入光子、输出控制命令的完全端到端(Photon to Control)。
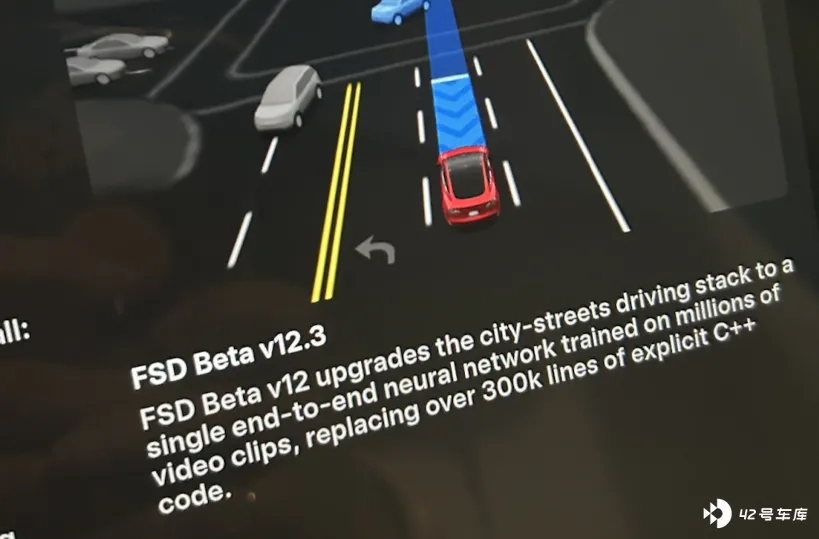
具体而言, 智能/自动驾驶的「端到端」是指系统从传感器输入到控制信号输出所有步骤完全可导的系统。
在」原教旨「定义中,端到端可以是一个大模型(one model),也可以是多个小模型构成。
更重要的是智能/自动驾驶系统能够作为一个整体,面向最终任务——「开车」进行数据训练和迭代优化,用户感知 的驾驶决策轨迹,是完全由模型系统做出的 。
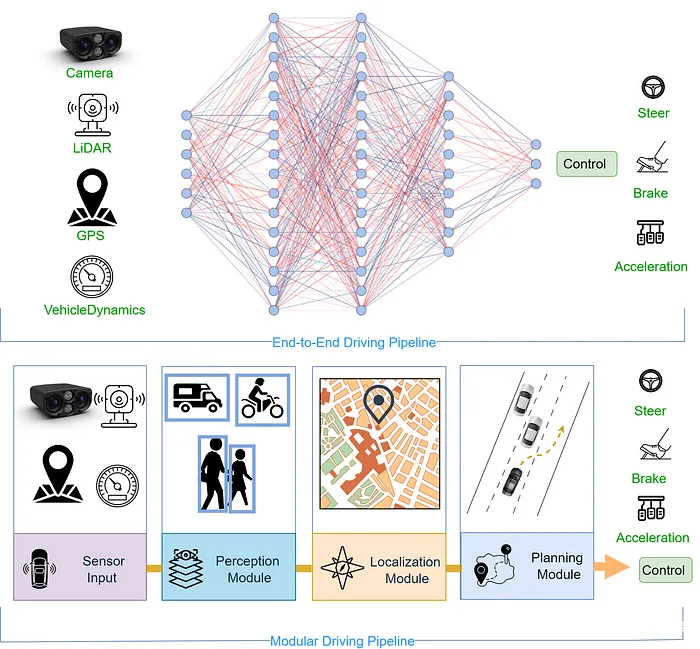
端到端之前的混合架构由模块化模型+后处理+规则构成 ,将「开车」这一复杂综合任务拆解为一系列子任务,由三四十个模块协同完成。而这些模块包括神经网络、手写规则和数学方法等多种类型。
相比混合架构,端到端具有信息无损、全局优化和极大提升效率的优势。
在信息无损和全局优化的数据驱动之下,端到端相较于混合架构的迭代效率极大提升。
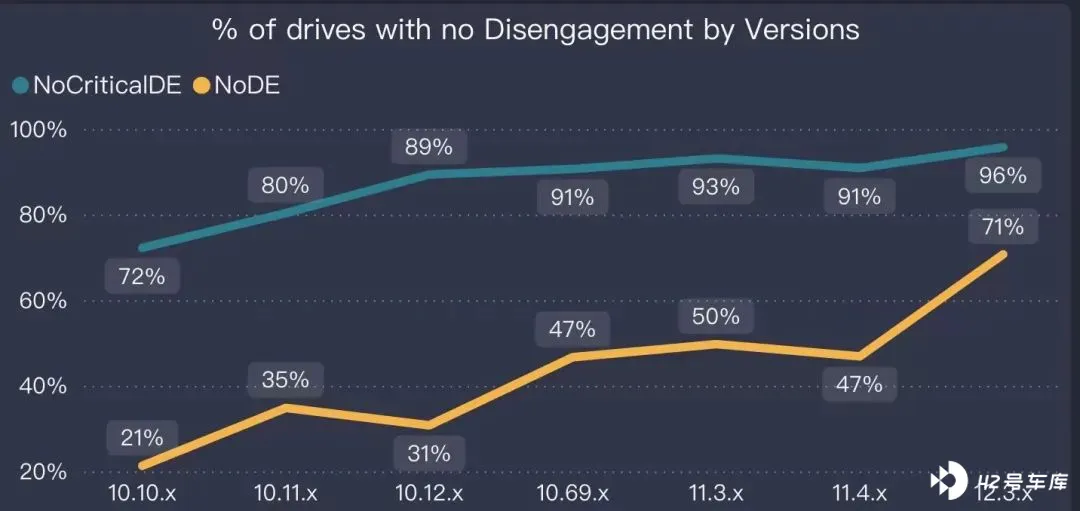
以特斯拉为例,FSDV12.3 版城市每次关键接管前行驶里程已上升至 240 公里,无关键接管率也达到空前的 71%。 在向全美特斯拉车主推送免费试用一个月之后 , 4 月的一次或无接管率达到 90%,无接管率为 73%, 5 月和 6 月,这一数字略有回落为 87%/68%,87%/70%。
在非端到端版本前,这一数据的历史最好值为去年 8 月的 87%/65%。
但从《电动汽车观察家》了解到的信息来看, 目前业内尚无人做到马斯克所表述的「原教旨主义」端到端,包括特斯拉自己。
有代码的端到端
「他们说没有必要不用规则。红绿灯等都是人类现成的规则,没必要通过看别人红灯刹车,才学会刹车。」
一位接近特斯拉北美 FSD 团队的业内人士表示:「 所以 V12 应该是一个大的神经网络,从头到脚。只有底下重新做了一个兜底的东西。出现极端情况,或者没必要(用神经网络学习)的,就用这套东西去兜底了。 」
另一个论据是 FSD V12 的车端算力使用情况。
特斯拉工程师现场估算,70Tops(HW3.0)中有一些固定的道路、红绿灯、兜底规则的算力消耗,约 20Tops 左右。 实际自动驾驶系统的算力在 50Tops 左右。「所以反推出它的自动驾驶模型也不大,可以说是一个小模型。 」上述业内人士表示。
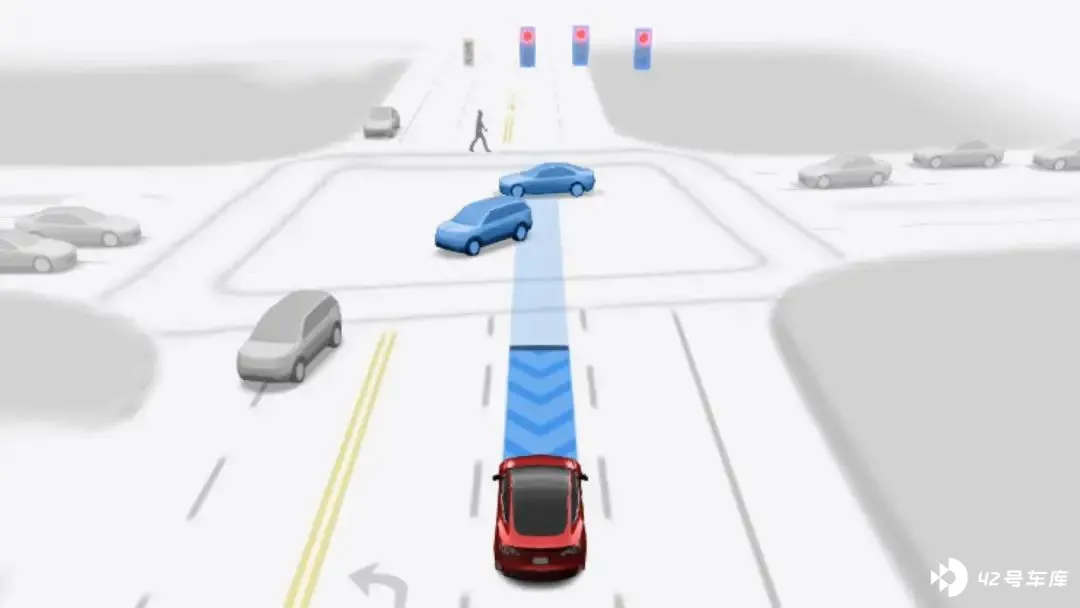
前述工程师也认为, 特斯拉的规划使用深度学习是为了加速树搜索 (人工智能问题中做出最优决策的方法,一般是在组合博弈中的行动规划形式),「 而不是直接端到端黑箱出轨迹。因为出了问题短时间根本修不好,也没人知道要多少数据可以修好。 」
但另一位工程师另有看法。他认为,特斯拉 FSD 在 V10.9 时,已经完成了感知的纯数据驱动。 如今 V12 的架构和 V11 没有很大的差别,最大区别在于换掉了整个决策规划模块 。
基于 AI DAY 的信息,特斯拉规控部分在 2021、22 年就已经是一个混合模型,在当中使用了数据驱动的方法与规则融合。「 显然,没有办法通过这种方法(模型+规则)来达到 V12 的效果。 」
目前国内极少数实践一段式端到端自动驾驶系统的商汤绝影,也表示其系统目前仍需要有安全兜底规则。
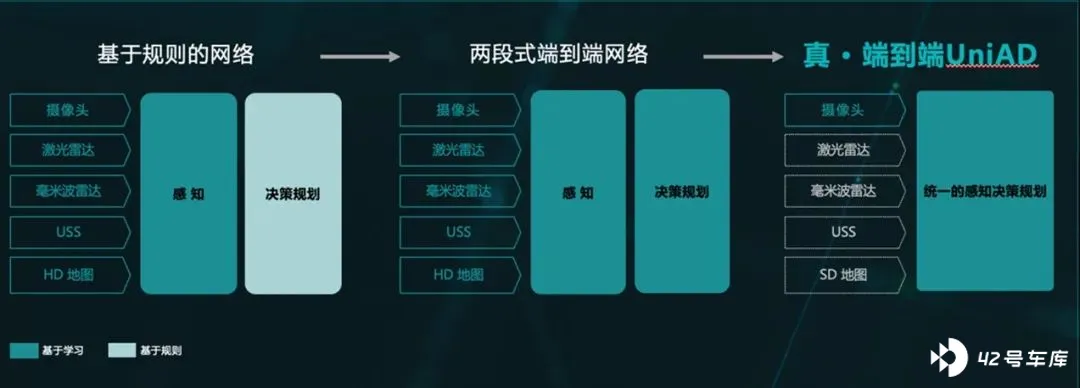
商汤绝影推出的端到端自动驾驶系统 UniAD,通过感知端的模型和特征提取器,得到周围环境、目标,以及目标未来行为预测的一系列特征,并以此进行之后的规划轨迹输出。 整个架构内都由神经网络构成,模块间的交互也都是通过特征来传递。
「 实际上,我们在(系统)中间有加入之前传统模块间的一些监督,但整体目标还是希望学到最优的最终路径。对于最后的路径规划,我们会通过传统的方法进行安全性的检查和确认,确保环境中最底线的安全保障 。」
商汤绝影智能汽车事业群智能驾驶副总裁石建萍表示:「 现阶段的端到端,首先是从感知到规控是一个完整的数据驱动方案,通过灵活的数据积累和 scaling laws 使系统更快迭代到更加智能的状态。但在一些安全性问题上,还是要跟规则一起做一些相互确认 。
这是我们认为端到端可能较为合理的方案。」
小鹏汽车创始人何小鹏也在此前的采访中说过: 目前没有一家企业敢说自己的端到端是完全没有代码的。
对于国内头部玩家来说,感知部分的模型化程度已经很高,切换端到端的主要难度在于之前几乎完全由规则组成的规控制部分。
上述规控工程师表示, 据其了解,目前国内头部玩家的规控大部分仍是混合架构。
具体而言,模型给出若干轨迹参考后,用传统方法全部进行优化。 工程师会写一些规则和评价函数,对每个优化完的结果打分,之后选出分最高的轨迹落地。 其中,评价函数也可能会部分结合神经网络。
所谓传统的方法,并非简单的 if else( If else 是 C 语言中的条件语句。if 后面加一个条件,如果条件成立,则执行 if 语句里面的内容,如果不成立,则执行 else 语句内的内容 ),而是众多数学方法。包括马尔科夫决策过程、博弈论、utility theory、优化理论等。
2023 年 4 月,还担任小鹏智驾负责人的吴新宙就曾表示, 在穷尽数学方法的可能性之前,不会在决策部分大规模渗透神经网络。
在上述规控工程师看来,完全依靠深度学习达到高安全性的智能/自动驾驶系统,成本要比使用科学方法高得多。更合理的方法是打造一个科学的决策规划理论和计算架构,其中能够兼容机器学习。 一方面表征了规控结果的合理性和基本正确性,另一方面依靠机器学习,实现系统的智能和灵活性 。
「 深度学习可以作为工具处理子问题,但不应当认为有了深度学习端到端就可以再也不用把理论做对了,那样只会 garbage in, garbage out(垃圾进,垃圾出) 。」
但仍有工程师对非「原教旨」的端到端心存怀疑:
「 总而言之,无论是感知后处理代码,还是规划的候选轨迹打分,甚至是安全兜底策略。一旦引入了规则的代码,有了 if else 的分支,整个系统的梯度传递就会被截断,这也就损失了端到端系统通过训练获得全局优化的最大优势 。」
「黑盒」中的端到端
「 一堆数据、一个算法、一个目标,如何把三者连起来形成闭环?这种能力既花钱又花人 。」上述接近特斯拉的业内人士表示:「到底怎么做?大家都不知道,特斯拉也不讲了,只能慢慢去摸索。」
即使是仍存在代码的端到端系统,如何训练和验证, 也已是横亘在工程们眼前的难题。
「如果是开环训练,无论多少数据我理解都很难达到目前(特斯拉 FSD V12.3)这种效果。大家推测,之前训练的基础设施(自动标注、已训练好的各类模型、回归参数等),对特斯拉实现端到端是最关键的。
Andrej Karpathy(原特斯拉 FSD 技术负责人)也说是把车端一些决策、判断的内容迁移到了云端。但到底是怎么结合?怎么验证?
端到端并不是新概念,一直没落地也是因为当中存在很多的技术卡点 。」前述工程师表示。
早到英伟达,近到 comma.ai 、Wayve 都推出了端到端 L2 级自动驾驶系统的 Demo 和开源项目。 但此前行业和学术届对端到端自动驾驶系统的探索都是开环训练和开环测试。
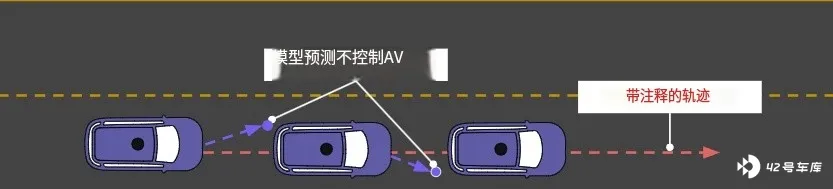
所谓「开环」, 是让模型在采集到的现实数据上,进行模仿学习,「有样学样」。开环评测主要考量系统与人类驾驶员轨迹的偏离程度,以及碰撞概率。
目前业内普遍认为开环训练/验证的系统,无法直接应用在现实场景中。
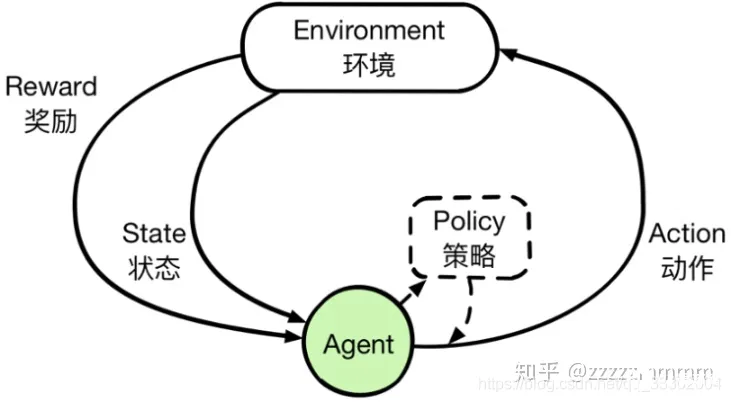
因为开环无法闭环—— 环境对系统的行驶轨迹给出真实的反馈(例如:自轨迹规划对前方车辆进行加速绕行,环境根据情况给出绕行成功或剐蹭的结果反馈),系统在与环境的交互试错中学习优化指定目标(开车) 。
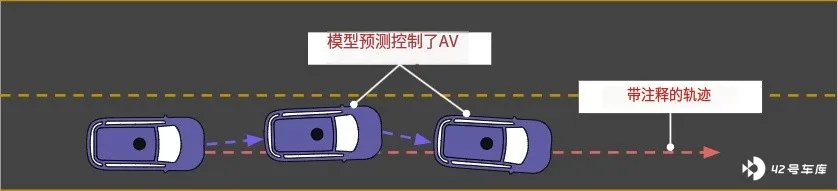
闭环训练作为强化学习的方法,其效果在大语言模型(LLM)的性能提升中得到了验证, 但自动驾驶系统不是「聊天对象」,其闭环所需的数据和验证方式,都更为复杂和困难。
环境构建困难外,闭环的数据获取也更困难。
开环模式可以直接获取数据,从大量的人类驾驶数据中精选出「五星司机」数据,让系统模仿,进行开发的训练和验证。
闭环训练则需要提供能够与系统进行交互的场景数据。这就不仅需要采集数据,还需要构建出基于物理,甚至人类行为学的互动仿真环境。
目前业内有 CARLA(开源仿真器,用于模拟自动驾驶车辆在不同场景下的行为和决策)等仿真器,或是其它游戏引擎来提供这样的环境。但实践认为,仿真器中训练出的系统,无法直接迁移到真实环境中。
Wayve、comme.ai 则会基于一些仿真引擎和真实数据重建场景。尽管更加拟真,但当系统生成的驾驶决策与采集到的差异太大时,系统训练后的拟人性会急速下降。
闭环验证则更为困难。
一方面,仿真环境的真实性和丰富性始终存在上限;另一方面,随着端到端系统性能提升,接管率不断下降之后,实车测试的难度也随之增大。 此外,当端到端性能达到一定程度后,如何评估也成为新的问题。
此前,UniAD 在论文阶段采用开环模式。石建萍表示, 商汤绝影在量产 UniAD 的过程中,已经意识到开环的不完全性,」我们自己内部大量的研发其实都是去打通实车的闭环单链路和仿真的闭环单链路,双管齐下去做。 「
但如果要做到特斯拉的水平呢?
今年股东大会上,马斯克表示目前 FSD 的制约因素是两次干涉之间的行驶距离太长了。「要想确定哪个版本效果更好,需要花费相当长的时间,因为它们都不需要什么干预。如果干预间隔里程达到数千英里,或者一万英里(1.6 万公里)(怎么办?) 」
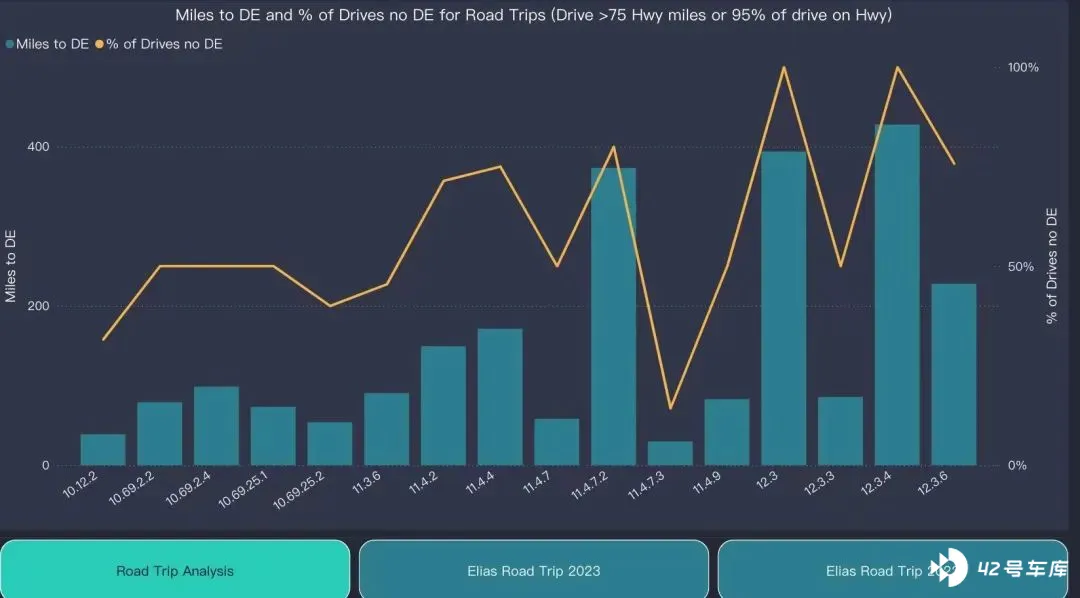
接管率外,端到端还需要新的评估体系。「 如果一个版本有 5 次干预,另一个有 7 次。7 次就必定比 5 次的差吗?人类干预的发生有很强的主观性,所以需要大规模,甚至全美的统计数据才能建立起客观的评价体系 。」一位工程师表示。
目前,特斯拉通过影子模式在其车队中对人类驾驶和新版 FSD 进行比较分析,「 通过大规模车队在很短时间内形式的数十亿英里来进行评估。」「事实上,如果没有数以百万计的车辆在路上行驶,就不可能解决自动驾驶问题 。」马斯克表示。
迭代背后的资源战争
「 把完全端到端模型闭环地使用起来,其实是最重要的 。」
石建萍表示,「 我们现在尽快使用起来且快速迭代,这事其实是比较重要的。绝影现在车上持续在部署优化的模式 。
每个月的版本模型都会有一些微调。比如如何连接、中间需要哪些特征、特征如何训练等,随着数据增长和我们对模型效果的认识,持续迭代进化。」
在算力储备方面,商汤绝影是国内智能汽车行业领先的, 商汤目前已经拥有 4.5 万张 GPU ,运营总算力规模达到 12,000 PFLOPS,预计年底可增至 18,000PFLOPS。
同时,在仿真基础上,建立自己了采集车队以及合作项目量产车队中获取数据。「 我们现在的资源匹配目前的量产进度是比较宽裕的,未来追求更高的泛化性,肯定需要进一步扩张资源 。」
按照目前的迭代进度, 商汤绝影的 UniAD 端到端系统预计在 2025 年,达到目前国内头部玩家用混合架构实现的城市领航能力水平。
此前,海量训练算力和数据被认为是端到端落地的核心瓶颈。但从实践来看,算力和数据的资源战背后,是迭代速度的战争。
特斯拉 FSD V12 车端模型算力需求为 50TOPS。按照云端模型大小一般是端侧的十倍来看,其云端模型也绝非 GPT 一类千亿甚至万亿级参数的大模型,而是一个相对小的模型。
但为这个「小模型」,特斯拉在 2023 年年底建立了 5.6 万张英伟达 A100 的算力中心,在今年又买进 3.5 万张英伟达 H100,并计划至年底将 H100 的规模扩大到 8.5 万张。
今年 3 月,马斯克发文称特斯拉的人工智能训练「不再受算力限制」。6 月,英伟达内部曝出马斯克将特斯拉预定的 H100 转移到了社交媒体 X 和人工智能公司 XAI 使用。
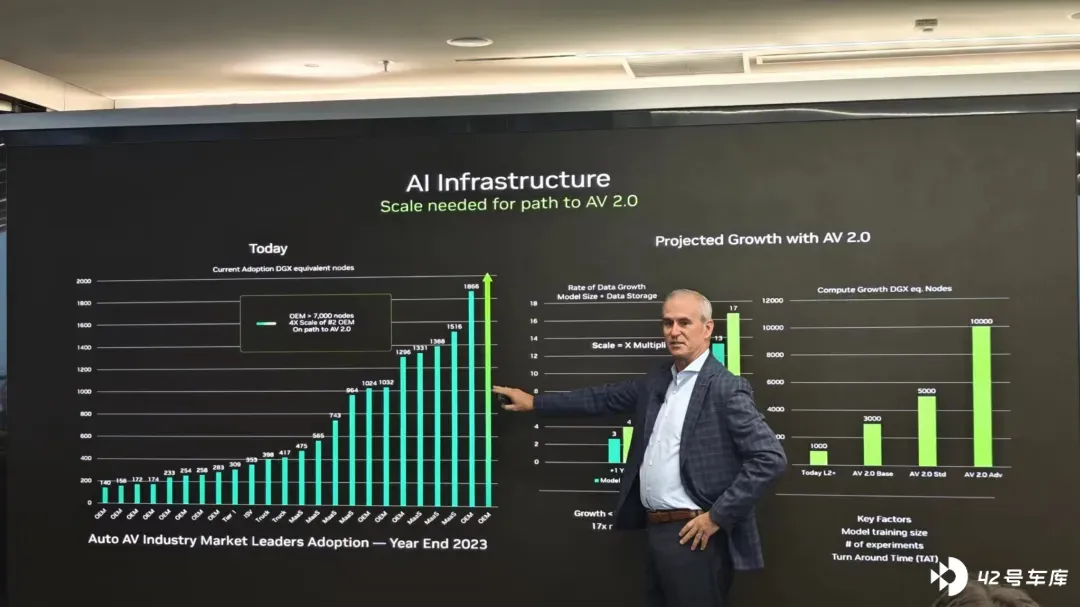
「 特斯拉这么高的算力主备主要是为了追求训练频次。因为模型不大,为了出效果,所以把训练频次拉得很高,不断的反复训练。有些数据使用类使用率很高,所以他必须要那么多卡。
现在它的训练可能基本完成,不需要那么大训练量了,所以说算力不是瓶颈了。 」上述业内人士表示:
「 但其他玩家这关(训练迭代)还是要过。后面来看算力只是一个好解决的瓶颈,将来主要的难度还是工程和科学上 。」
「 大语言模型可能需要 1000 张卡跑一个月才能跑出一个实验。但自动驾驶的端到端大部分可能是 100 多张卡一周左右的工作量。
卡的数据量增多,就可以把迭代效率从周级压缩到天的级别。同时,更多的卡意味着可以并行去做多种尝试,从而更快收敛技术方案。」石建萍表示:
「 迭代效率的差距会在一两年后显示出显著的差距,而更多的资源甚至可能涌现出新的,下一代的技术方向。 」
目前,国内大部分自动驾驶公司的算力建设在千卡级别,但头部玩家开始加大投注。
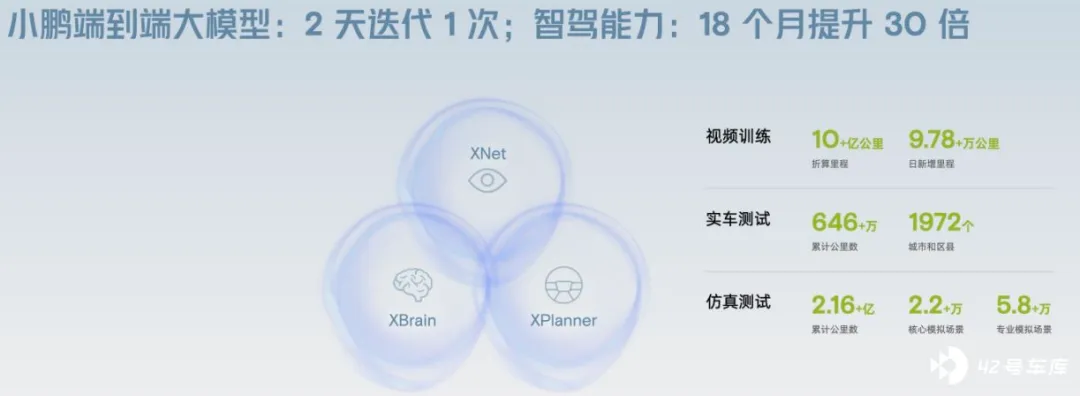
小鹏汽车在 2023 年的算力储备约为 600PFLOPS ,约 3 万张 A100。 随着 5 月份发布端到端的 XNGP,迭代速度已经达到 2 天一次 。 小鹏汽车宣布今年将投入 1 亿美元用于扩大云端算力储备,而未来的投入将「更多」。
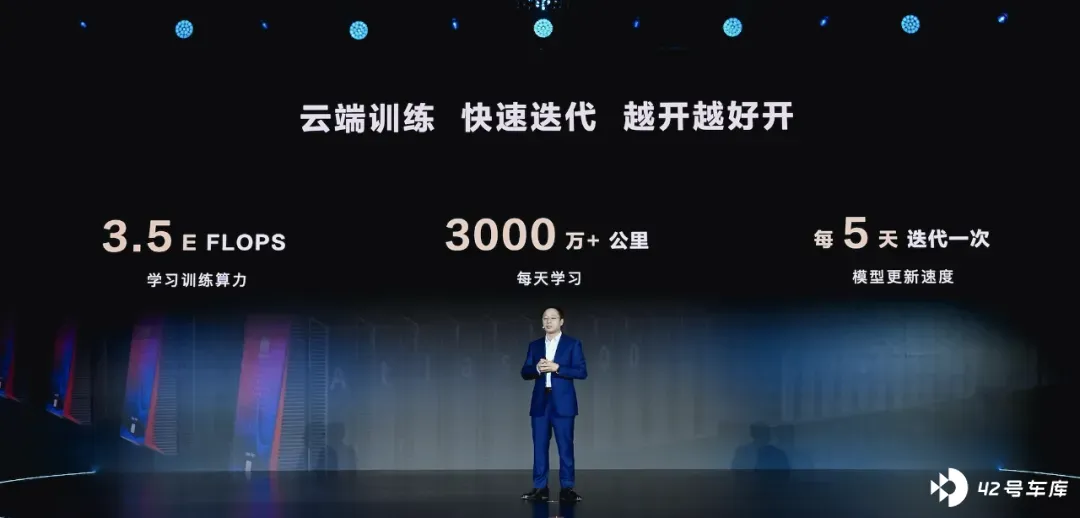
华为在 4 月的乾崑发布会宣布,云端训练算力已达到 3.5EFLOPS,迭代效率达到 5 天一次。
数据的量和质,则是迭代竞速中的另一项资源。
「端到端之后更加依赖数据喂养,采集能力和处理能力都要到位。」一位国内头部自动驾驶玩家的工程师表示:数据采集一方面是厂家自己生产,另一方面则需要有足够的用户数量,才能有足够的数据来喂养模型。
根据特斯拉的说法,其端到端模型的数量数据约为几万小时的真实路况,是从超过 20 亿公里(截至 5 月)的 FSD 历程数据中挖掘而来。
目前规模最大的公开数据集包含大约 1200 小时数据。
石建萍表示,商汤绝影在实践中发现,其几十台采样车一个月能够产生千万量级 clips 的有效数据,满足在端到端打通链路和跑起来的初期所需。
「 更重要的工作是如何从大量数据中筛选出价值更高的数据。有意义的数据分布、干净的数据当中,包含大量的经验积累。 」
仍是强者恒强
端到端是否会像大语言模型一样,让 OpenAI 这种新公司一夜之间站在谷歌、meta 前面,重写游戏排名? 从实践来看,在端到端自动驾驶系统的赛道中,仍是强者恒强的未来。
因为之前的工作和努力不会白费。
从模型本身来看,端到端仍遵循 Andrej Karpathy 提出的软件 2.0(神经网络)吞噬软件 1.0(手写代码)的过程。
以特斯拉为例,在 V10.9 版本上,FSD 已经去掉了感知的后处理部分,即感知中的代码。V12 版本重点更换了决策规划的模块;同时,V12 中一开始有 V11 绝大部分可视化的内容,但之后如锥桶、目标车道等被去掉了。
「 这说明在端到端落地的过程中,特斯拉也是逐渐实验,将不需要的分支模型内化到整体之中,而不是完全重头再来。只要保证之前的模型和新加入的模型中不适用规则串联,是端到端可导的即可 。」上述感知工程师表示。
石建萍也表示, 商汤绝影在实践中发现,之前感知模块中的各种输出也是端到端中间的一些监督信号,而此前积累的训练方案、模型整合方案都是端到端系统能够直接继承的;规控的部分此前更偏数学推导和逻辑设定,端到端阶段虽然更强调对模型的理解,但「实际上代码好、数学好的同学是通吃的 。」
上述规控工程师也表达了类似的观点。在他看来,无论是端到端模型本身,还是云端训练部分,需要对模型给出的规划结果进行打分和优化时, 其过程与传统规控工作内容非常接近。「所以说他们 (规控工程师) 其实知识结构上并没有很大的变化。」
这意味着,在混合架构中软件 2.0 程度越高者,规控部分能力越强者,在端到端落地过程中,越具有先发优势。
但技术之外,还有组织和决策的挑战。
开发的组织架构是服务于技术架构的。混合架构以模块化架构为主,团队也分为感知、规划、控制等模块,其中还包括模型、后处理、地图定位等细分项目团队。
以模型为主端到端,对数据和训练,甚至分布式计算的要求更重时,如何推动现有团队转型,建立新的组织架构,成为落地端到端看不见的隐性课题。
要下决心则更难。
4 月,马斯克在 X 上表示:「要实现通用的自动驾驶,难度之大令人咋舌,需要上面描述的所有条件,甚至更多。今年,(特斯拉)在训练计算、庞大的数据管道和海量视频存储方面的累计投资将远远超过 100 亿美元。」
投资 700 亿元,甚至更多押注在目前尚未有明确商业落地的技术上?这对很多企业来说都是颇为困难的决策。
《电动汽车观察家》在采访中了解到 ,国内大部分玩家目前对完全押注投入端到端,仍存疑虑,大多仍是初期投入或预研阶段。
一方面,端到端系统作为高上限、低起步的技术路线,初期必然出现系统性能回退的情况。在混合架构已取得较好性能,成为市场卖点之一时,转型端到端的性价比不高;
另一方面。特斯拉尚未彻底验证端到端的性能如何。在接管率明显降低之后,端到端将面临和大模型一样的瓶颈:不可预知性——到底能走多远?是否值得国内玩家在淘汰赛中全面转型?
不过,端到端显然已经不只是给客户高端感的「宣传」。资本市场已经开始给出估值。
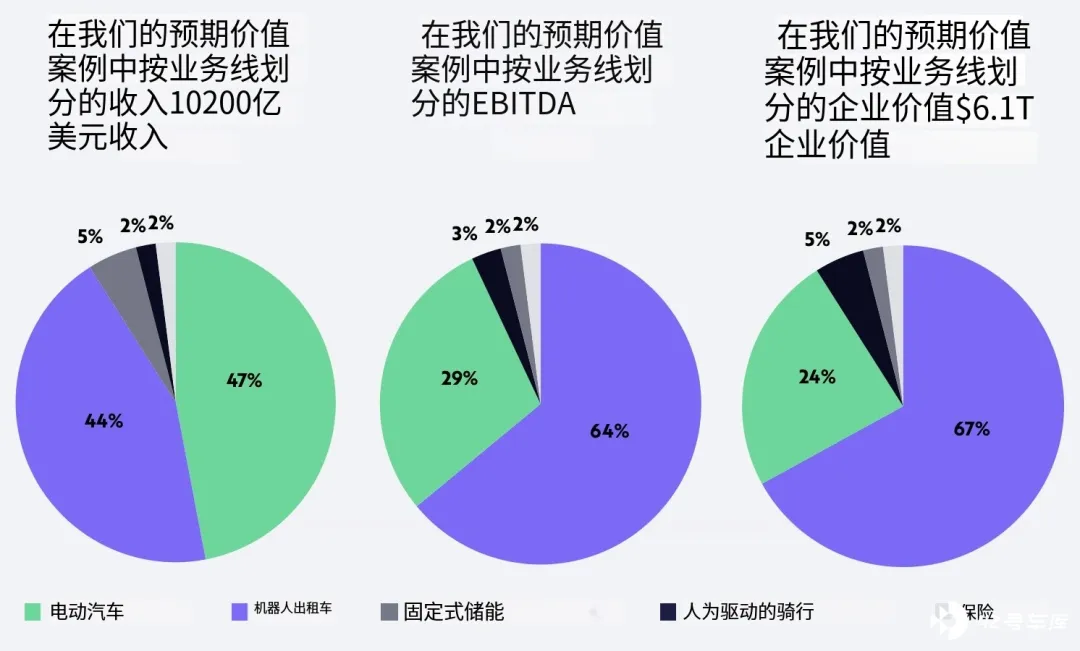
6 月,著名科技投资人「木头姐」凯茜·伍德的方舟投资公司(ARK Invest)公布了最新的特斯拉目标价及研报,预计 2029 年特斯拉每股预期价格为 2600 美元,其近 90%的市值和盈利将归功于 robotaxi 业务。电动汽车可能只占特斯拉总销售额的四分之一,贡献 10%的盈利。
但负责落地的工程师们意见分歧仍很大。
「 等明年特斯拉不吹端到端了,国内也就不跟着吹了。不信你可以等着看 。」反对者这么说。
「 在我们看来,端到端是一定要做的,必然会整体提升表现的事情。但当这个结果不真正展现在大家面前时,很多人是将信将疑的。 」支持者如是说。
参考资料
https://www.zhihu.com/question/645496992/answer/3488300774
https://blog.csdn.net/muye_IT/article/details/123525536