作者 | 李林可
编辑 | 邱锴俊
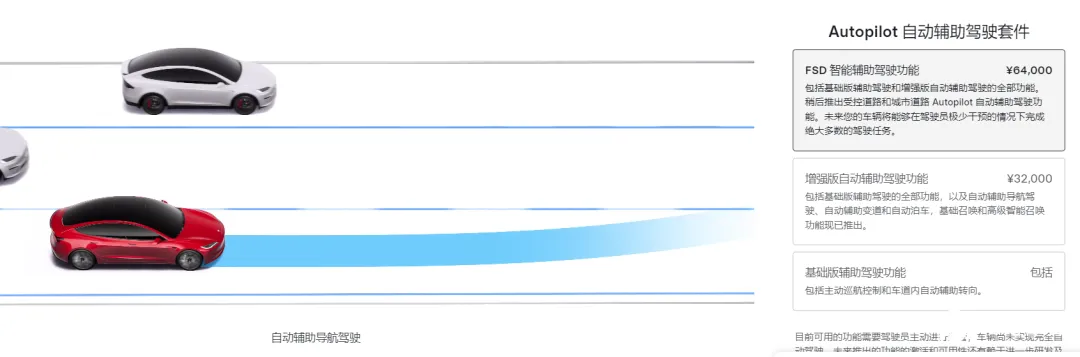
闯红灯、走自行车道、掉头车道直行……特斯拉 FSD 在中国市场推送之后,成为「高阶违章智驾」。
但是,很多专业人士,以及《电动汽车观察家》的体会是: 特斯拉 FSD 的基础能力非常强,如果这些「水土不服」的问题解决,它将是中国市场最好的智驾之一,甚至可能争夺第一。
尤其是,当智驾研发走向端到端大模型阶段之后,数据+算力的进化速度是惊人的。
眼跟前的例子是,理想汽车在特斯拉 FSD V12 首个采用端到端大模型之后,也采用了这一新技术方案,如今理想汽车的智驾,至少已经可以和华为、小鹏一较高下。
所以, 比起特斯拉 FSD 入华后的初期表现更重要的问题是:FSD 在中国为什么会这样?它会很快变强吗?
这是和中国智驾企业生死攸关的问题。
走错道,是无意,还是故意?
大家在使用特斯拉 FSD 的过程中,发现了很多共性的问题。
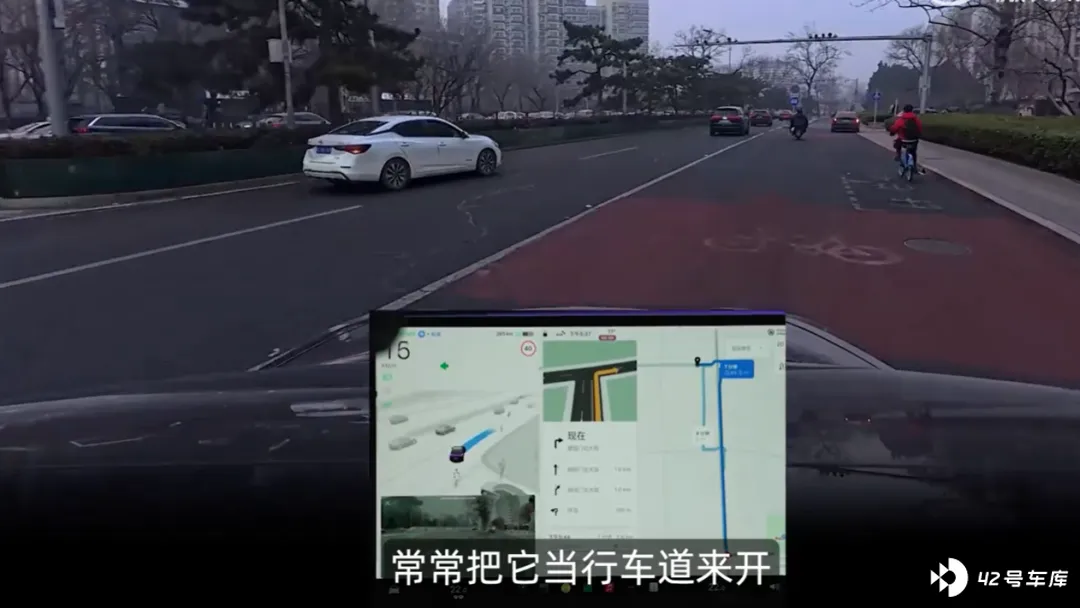
比如对于异形红绿灯识别不清,会闯红灯;主辅路识别不清;经常走自行车道、公交车道、压实线……
这导致开特斯拉 FSD 虽然可以不接管或者少接管,但是会大量违章。知名车评人陈震在测试 FSD 的过程中,就收到了 7 张违章罚单。
特斯拉为什么会犯这些低级错误呢?
这涉及地图数据、自身定位和模型的决策。
首先一个略意外的信息是——特斯拉采用了百度的轻图。
轻图是介于高精地图和导航地图之间的地图。在车企对高精地图的更新速度、成本表示不满之后,百度等图商推出了这一产品。
百度的轻图(LD),和高精地图(HD)相比,信息要少。轻图没有定位层信息,车道层也只有拓扑信息,而不一定有详细道路边界。
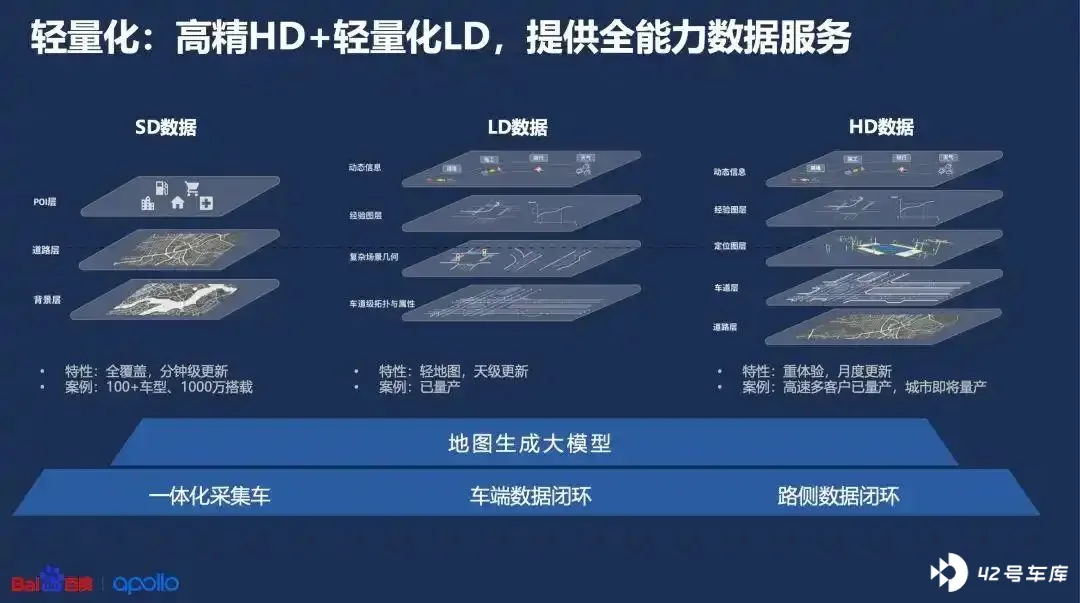
轻图的好处在于,它是以天为单位更新的,另外成本要小得多。
目前, 国内主流智驾方案,都实现了无图——无高精地图,但是也有一部分用了轻图。相对来说,有了轻图加持,智驾方案要容易一些。
这样的话, 为什么特斯拉还会出现走错车道、压实线、走自行车道等问题呢?
一位车企的智驾技术负责人表示,特斯拉的这些问题,很多是导航和定位的问题,「FSD 的定位芯片太烂了。」
另外,在中国有很多特殊工况,比如可变车道,限时公交车道,文字指引的直行待行区等等。这些即便是轻图,也是无法解决的。
不过, 一位智驾地图公司的负责人则表示,特斯拉 FSD 这些错误可能有三种原因,其一,是地图数据有问题;其二,地图数据没有问题,但是 FSD 在定位时存在问题,问题不一定是定位芯片,也可能是模型的感知问题;其三,地图数据和定位都没有问题,但是模型认为,有的车道,走了也没有关系,像自行车道、实线、公交车道,它对于行驶边界的认知还没有本地化。
可以肯定的是,特斯拉确实没有像华为、小鹏、理想那样,有那么多的本地数据,来进行大模型的训练。
由于中国对汽车数据的监管,汽车数据只能本地化存储,未经批准不得向境外传输。
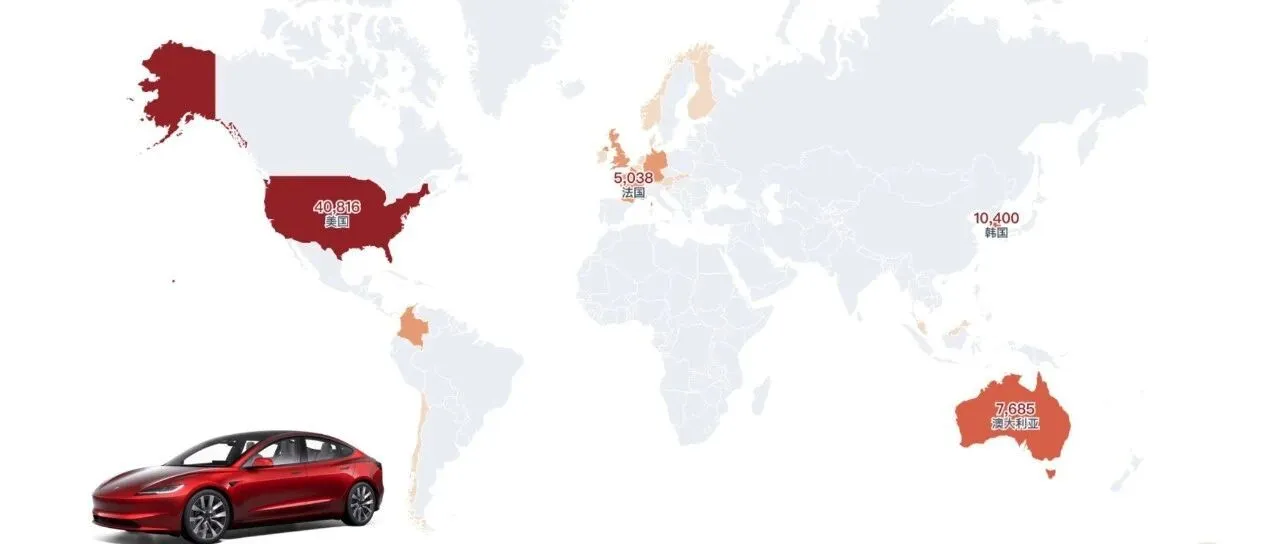
马斯克曾经表示, 特斯拉只能从互联网上寻找中国道路的视频片段来训练。此外,业内人士广泛推测,特斯拉还用了中国台湾地区和韩国的数据来训练。
关于公交车道,马斯克曾经表示,中国公交车道有时限行,有时又不限行,非常复杂。
特斯拉智驾的负责人也曾提及,关于实线,美国只是建议不能越过,但中国是禁止的。
总体来说,特斯拉 FSD 就像是「加州老司机」,还没有好好学习中国路况和交规,就在中国开车了。所以,它在常规驾驶中,展现出成熟、老道的一面,但是在处理和美国不同的路况、交通标识时,就暴露出所谓「水土不服」的问题。
数据和算力「碰不到一起」
但是,无论如何,都不能轻视特斯拉 FSD 的学习能力。
按端到端大模型的开发策略,针对特斯拉 FSD 目前遇到的问题,中国智驾企业的方案是对症下药—— 右转不好,就「喂」给模型大量右转的视频片段,让它强化右转能力;红绿灯识别不清楚,就「喂」红绿灯的视频片段,强化红绿灯识别能力。
那么,特斯拉能不能这么做呢?
特斯拉是行业第一个大规模建设数据、算力,用来训练智驾大模型的企业。到 2024 年 10 月,特斯拉的超算中心 Dojo,总算力将达到惊人的 100EFlops。然而,Dojo 部署在美国。
而中国的驾驶数据,只能存储在中国。根据中国《汽车数据安全管理若干规定(征求意见稿)》(下称《汽车数据规定》),个人信息或者重要数据应当依法在境内存储,确需向境外提供的,应当通过国家网信部门组织的数据出境安全评估。
2021 年 5 月, 特斯拉也曾经透露,已经在中国建立数据中心,将所有中国市场销售车辆所产生的数据都将存储在境内。
除了存储、外传的限制,采集数据,也有限制。个人信息需要车主授权,而且必须脱敏使用之外, 高于国家公开发布地图精度的地理、位置信息,可能会被视为测绘行为——这需要国家测绘局颁发的测绘资质企业,才能采集。
国内智驾企业当前正在大量收集车主的驾驶信息。 上述车企智驾负责人就表示,该数据需要有甲级测绘资质的企业来采集存储,并且需要定期报审。
除此之外,中国智驾行业已经开始了数据的共享和交易。
恺望数据就是一家专注自动驾驶数据服务的公司,业务包含了智驾数据共享和交易。恺望数据创始人、CEO 于旭表示,「大家(智驾企业)都需要就是更适配场景的真实数据,来帮助它(模型)能达到更准确的程度。」像特斯拉所采用的互联网上的视频数据,作为通用数据,是无法满足垂类大模型的训练需求的。
于旭介绍,在智驾开发走上 AI 模式之后,各企业都面临数据不足的情况。但与此同时,各企业又都通过测试车、采集车等方式收集了很多数据,「只是这些数据分布在不同的一些地方」另外和场景的适配度、算法模型的匹配度需要加工处理。「我们就是要让这些数据共享和交易起来。」
在今年两会上,全国人大代表、长安汽车董事长朱华荣就有提案说,智能网联汽车行业可供利用的有效数据增多,数据的共享、共建成为获得海量数据的高效途径,因此应当建立相应的安全法规,推动智能网联汽车数据共享。
以此推导, 特斯拉同样也可以用以上这些方法来获取大量的驾驶行为数据。
不过,「FSD 的困境不在于数据的获取,而是自我的纠结——数据不能出境,但马斯克又不想把模型放到中国训。」上述智驾负责人表示。
「数据和算力碰不到一起。」上述智驾地图负责人也说。
会给特斯拉「开后门」吗?
如果无法通过大量采集数据并训练模型来解决 FSD 本地化问题,特斯拉有别的招吗?
很多业内朋友笑谈:就看主管部门会不会给特斯拉「开后门」了。
不过, 上述智驾负责人表示,FSD 不一定需要中国数据的方式来解决问题。比如,交通标牌标识可以构造仿真数据来训练。
此外, 作为智驾大模型,也可以类似于 ChatGPT、DeepSeek,通过提供更多提示词,「即使不改变模型,也能有办法提高识别率。」
另外,FSD 还需要进一步提升,让车端也具有实时识别和理解文字的能力,用以解决中国文字提示的公交车道限行时间、左转待转线、潮汐车道问题。
数据的采集和使用,也可能会有政策口子。
于旭提到,「国家现在也非常鼓励跨境数据的合作。」
她介绍,以上海临港为例,作为国家指定的离岸港,在这里做数据加工和处理和出境是合规的。特斯拉也是注册在临港,「从数据交易、数据共享的角度上,是否能有一些政策性的打开,我觉得是有可探讨的可能性。」
总体来说, 作为 AI 的智驾大模型,大量的数据和强大的算力依旧是「大力出奇迹」的法宝。上述车企智驾负责人说,如果特斯拉 FSD「解决数据来源和训练问题,提升会很快。」