

作者 | 咖啡鱼
一、概述
术语就像宝石,串起来就是一门技术或者学科的发展史。
按顺序看无图自动驾驶的技术术语,即是了解技术发展史,又是掌握核心概念。
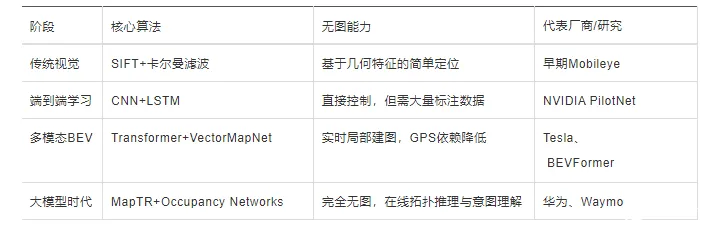
无图技术的本质是 从 「 记忆地图 」 转向 「 实时认知 」 ,其发展脉络与 AI 算法从规则驱动到数据驱动的演进高度同步。
大致可以分为 5 个阶段:
1. 早期阶段:基于传统计算机视觉( 2016 年前)
核心技术是特征提取( SIFT/SURF )、卡尔曼滤波、粒子滤波
主要依赖规则化编程和传感器融合(摄像头 + 毫米波雷达),无高精地图时通过几何特征匹配定位,但动态环境适应性差。
2. 深度学习崛起:端到端模型( 2016-2020 )
核心技术是 CNN (卷积神经网络)、 RNN/LSTM 、端到端学习( End-to-End )技术突破:
NVIDIA 的 PilotNet ( 2016 )首次用 CNN 直接输出转向控制,摆脱对高精地图的依赖,但可解释性差。
局限性是黑箱模型导致长尾场景(如极端天气)失效风险高。
3. 多模态融合与轻量化地图( 2020-2022 )
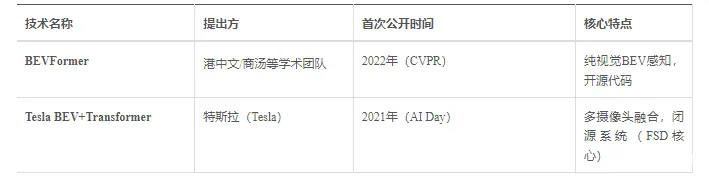
核心技术是 BEV (鸟瞰图)感知、 Transformer 、 VectorMapNet 关键技术: BEV+Transformer ( 2021 ):特斯拉提出 BEVFormer ,将多摄像头输入统一为鸟瞰视角,实现无图空间推理。
VectorMapNet ( 2022 ):用矢量编码替代高精地图,仅需 GPS 粗略定位即可生成局部道路拓扑。
4. 大模型时代:无图 NOA 爆发( 2023- 至今)
核心技术是 Occupancy Networks 、 VLA (视觉 - 语言 - 动作模型)、 MapTR 系列
当前进展: MapTR ( 2023 ):华为提出基于分层查询的矢量化地图实时构建算法,支持无图城市 NOA (自动辅助导航)。
Occupancy Networks :通过 3D 体素占据栅格模拟环境,彻底摆脱对地图先验的依赖。
竞争焦点是从 「 有图 vs 无图 」 转向在线建图效率与动态障碍物意图预测(如行人手势识别,是阻止还是给车让路)。
5 、未来方向是 XAI (可解释 AI ): 解决无图系统的决策透明度问题(如 SHAP 值分析) 。和世界模型:通过扩散模型预测复杂交通场景的演变。
技术演进对比表
而且无图并不是一下子无图,很多无图方案会保留地图作为实时建图的对比,以增强安全性。在自动驾驶技术演进过程中, 「 无图 」 方案是通过动态重构地图使用方式实现渐进式变革。当前主流无图方案普遍采用 「 轻图 + 实时感知 」 的混合架构,保留精简版地图(通常仅含车道拓扑、交通标志等关键信息)作为先验知识参考。这种设计下,车辆通过多传感器(摄像头、激光雷达等)实时构建局部高精地图,同时与车载基准地图进行交叉验证,形成双重安全保障机制。例如理想汽车采用的清华技术方案,在路口等复杂场景会将实时感知的路沿特征与地图基准线比对,当偏差超过阈值时触发人工接管。
比如百度 Apollo 的 「 三图层 」 方案则更系统化:经验图层(历史数据)、安全图层(法规要求)、实时图层(传感器数据)形成递进式校验链条。这种 「 地图为锚,感知为实 」 的架构,既规避了传统高精地图的更新成本问题,又通过冗余设计将定位误差控制在 15 厘米内,实测显示该方案可使漏检率降低 40% 以上。
二、术语解释
1 、首先最自然的问题,无图是无的什么图?
主要是以下三类
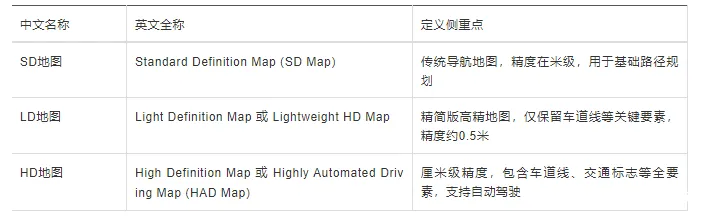
更重要的,高精度地图( HD Map )和轻高精地图( LD Map )与标准导航地图( SD Map )的核心差异不仅体现在数据精度上,更在于其底层数据结构和应用场景的本质区别。从技术实现来看, HD 和 LD 地图普遍采用矢量数据格式,通过几何要素(如点、线、面)的数学描述来精确表达车道线、路缘石等道路特征,这种结构使得地图要素能够保持拓扑连接关系,支持自动驾驶系统的实时路径规划。而传统 SD 地图多采用栅格化表达,以像素矩阵存储道路网概略信息,主要用于人类驾驶员的宏观导航。在数据维度上, HD 地图包含厘米级精度的车道几何参数、曲率坡度等动力学特征, LD 地图则侧重保留车道拓扑连接等关键矢量关系,二者均可通过矢量运算直接服务于自动驾驶决策系统。相比之下, SD 地图 5-10 米精度的栅格数据难以满足机器对道路微观结构的解析需求,这种根本差异导致 HD/LD 地图必须采用支持几何计算的矢量存储方案,这也是特斯拉等企业构建纯矢量地图数据库的技术动因。
2、 以下分时代来介绍核心技术
2.1 传统视觉阶段: SIFT + 卡尔曼滤波
SIFT (尺度不变特征变换, Scale-Invariant Feature Transform ): SIFT 是一种计算机视觉领域的特征提取算法,由 David Lowe 在 1999 年提出。它的核心思想是寻找图像中具有尺度不变性、旋转不变性和光照不变性的关键点,并为每个关键点生成描述。通过检测不同尺度空间下的极值点,确定关键点的位置和尺度,再计算关键点的主方向,进而生成 128 维的特征向量描述。在自动驾驶中, SIFT 常用于提取道路、交通标志等物体的特征,用于图像匹配和目标识别,帮助车辆识别周围环境中的固定物体。
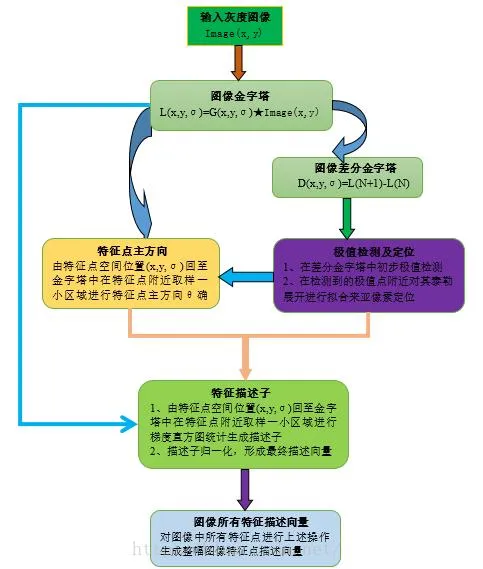
卡尔曼滤波( Kalman Filter ): 卡尔曼滤波是一种利用线性系统状态方程,通过系统输入输出观测数据,对系统状态进行最优估计的算法。它基于最小均方误差准则,采用递归的方式对系统状态进行预测和更新。在自动驾驶场景中,卡尔曼滤波常用于跟踪目标物体的运动轨迹。例如,车辆通过摄像头检测到前方车辆后,利用卡尔曼滤波可以根据该车辆之前的位置、速度等信息,预测其未来的位置,为车辆的决策和控制提供依据。
基于几何特征的简单定位: 此方法通过提取图像中的几何特征(如直线、角点等),结合已知的地图信息或通过多帧图像的特征匹配,计算车辆在环境中的相对位置。早期 Mobileye 使用这种方法,通过对道路标线、车道边界等几何特征的识别和分析,实现车辆的车道偏离预警、前方碰撞预警等功能,为自动驾驶提供基础的环境感知和定位信息。
2.2 端到端学习阶段: CNN+LSTM
CNN (卷积神经网络, Convolutional Neural Network ): CNN 是一种专门为处理具有网格结构数据(如图像、音频)而设计的深度学习模型。它通过卷积层、池化层和全连接层等组件,自动提取图像的特征。卷积层利用卷积核在图像上滑动进行卷积操作,提取图像的局部特征;池化层对卷积层的输出进行下采样,减少数据量并提高模型的鲁棒性;全连接层将提取到的特征进行分类或回归。在 NVIDIA PilotNet 中, CNN 用于对输入的车辆前方图像进行特征提取,识别道路、车辆、行人等物体。
LSTM (长短期记忆网络, Long Short-Term Memory ): LSTM 是一种特殊的循环神经网络( RNN ),能够有效解决传统 RNN 中存在的梯度消失和梯度爆炸问题,从而更好地处理长序列数据。它通过引入记忆单元和门控机制,选择性地保留和更新信息。在自动驾驶中, LSTM 可以处理连续的图像序列或传感器数据序列,学习数据中的时间依赖关系,例如根据车辆之前一段时间的行驶状态和环境信息,预测未来的行驶方向和速度,实现车辆的直接控制。由于 LSTM 是有选择地记忆和遗忘,可以归为某种广义的注意力机制。
2.3 多模态 BEV 阶段: Transformer+VectorMapNet
Transformer : Transformer 是一种基于注意力机制的深度学习架构,最初用于自然语言处理领域,后来在计算机视觉等领域也得到广泛应用。它摒弃了传统的循环神经网络结构,通过多头注意力机制,能够并行处理输入序列,捕捉不同位置之间的依赖关系。在自动驾驶的多模态 BEV (鸟瞰图, Bird「s-Eye View )技术中, Transformer 可以对多个摄像头采集的图像数据进行特征提取和融合,将不同视角的信息转换为鸟瞰图视角的特征表示,实现对车辆周围环境的全局感知 。
VectorMapNet : VectorMapNet 是一种用于处理地图信息的网络结构,它将地图表示为矢量形式,能够更高效地处理地图中的道路、车道线等几何信息。在自动驾驶中,结合 Transformer 生成的 BEV 特征, VectorMapNet 可以进行实时局部建图,将地图信息与感知到的环境信息进行融合,为车辆提供更准确的导航和决策依据。同时,这种方法降低了对 GPS 的依赖,即使在 GPS 信号不佳的情况下,也能通过地图和视觉信息实现可靠的定位和路径规划。
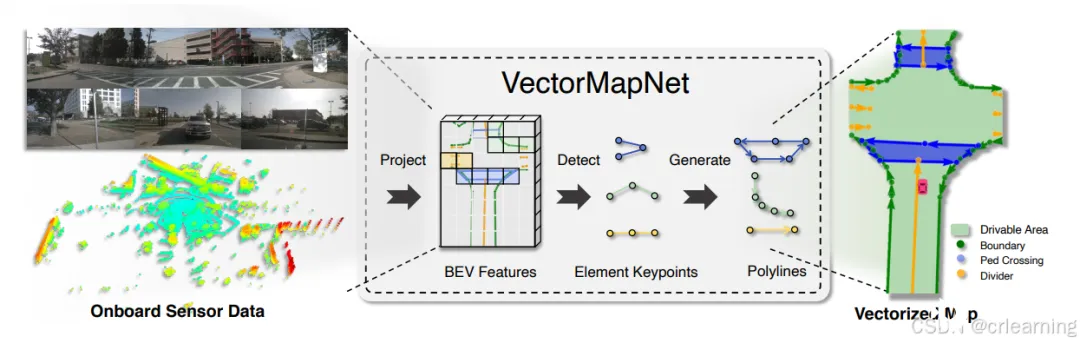
BEV feature 鸟瞰图特征也是经常出现的术语。用概念解释它并不清晰,容易出现概念解释概念的情况。本文用它表现为什么来说明它,一般是栅格和矢量。
BEV 特征以栅格和矢量形式表现时,具体如下:
栅格形式体素栅格: 将三维空间划分为一个个小的体素,每个体素可以包含点云密度、反射强度等信息,或者是通过卷积神经网络提取到的特征向量。例如在基于激光雷达的 BEV 感知中,可将激光雷达扫描到的点云数据划分到不同的体素中,然后对每个体素内的点云进行特征计算,如计算体素内点的数量、平均高度、反射率的均值和方差等,以此作为该体素的特征表示。
平面栅格: 把 BEV 平面划分成规则的网格,每个网格单元对应一个特征向量。例如在一些基于视觉的 BEV 感知方法中,将图像投影到 BEV 平面后,把该平面划分为若干个小方格,每个方格内的图像特征通过卷积神经网络提取出来,形成一个特征向量,用于表示该方格内的场景信息,如物体存在的概率、类别信息等。
矢量形式:
几何矢量: 用点、线、多边形等几何元素来表示 BEV 特征。例如,用点来表示车辆、行人等目标的位置;用线来表示道路边界、车道线等;用多边形来表示建筑物、障碍物等区域的轮廓。这些几何元素的坐标和属性信息(如车辆的速度、行人的类别等)构成了 BEV 特征的矢量表示。
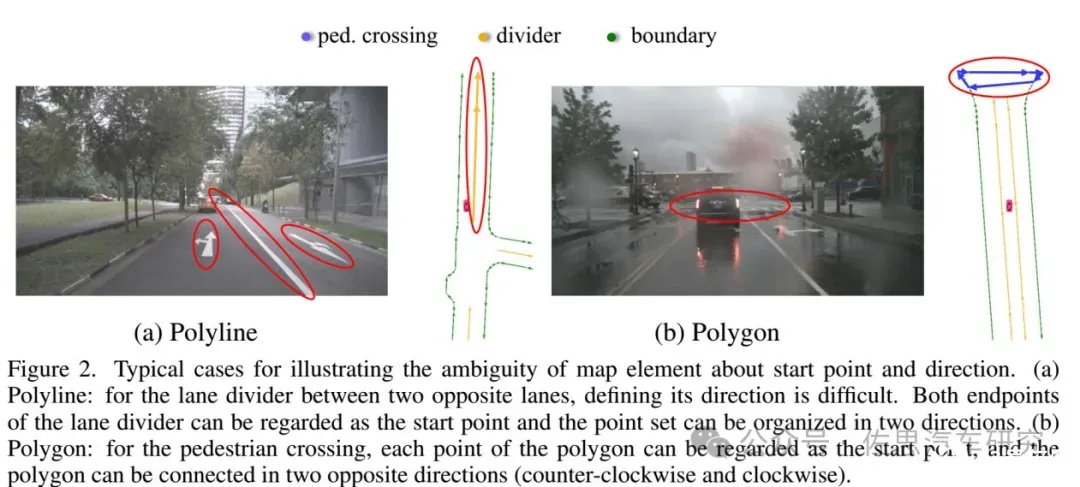
特征矢量: 将 BEV 空间中的每个位置或物体用一个特征向量来表示,这个特征向量可以包含多种语义信息,如物体的类别、位置、方向、速度等。在深度学习模型中,通过对输入数据(如点云或图像)进行编码,生成一个高维的特征矢量,用于后续的目标检测、跟踪和场景理解等任务。例如,在基于 Transformer 的 BEV 感知模型中,通过自注意力机制学习到每个位置的特征矢量,从而捕捉场景中的长距离依赖关系和语义信息。
栅格形式的 BEV 特征在表示连续的场景信息和进行卷积等操作时较为方便,能够有效地利用图像或点云的空间信息;而矢量形式的 BEV 特征则更适合表示具有明确几何形状和语义信息的物体,在目标检测、跟踪和路径规划等任务中具有较高的准确性和效率。在实际应用中,也常常将两者结合起来,以充分发挥它们的优势。
实时局部建图是指车辆在行驶过程中,根据传感器实时采集的数据(如摄像头图像、激光雷达点云等),结合地图信息,快速构建车辆周围局部环境的地图模型。在多模态 BEV 技术中,利用 Transformer 和 VectorMapNet 等网络结构,能够实现高效的实时局部建图,帮助车辆更好地理解周围环境,规划行驶路径。
2.4 大模型时代: MapTR+Occupancy Networks
MapTR : MapTR ( Map Transformer )是一种基于 Transformer 的地图表示和推理模型。它能够将地图信息编码为适合深度学习模型处理的特征表示,通过 Transformer 的注意力机制,实现对地图拓扑结构和语义信息的建模。在自动驾驶中, MapTR 可以进行在线拓扑推理,根据实时感知到的环境信息,动态更新地图的拓扑结构,理解道路之间的连接关系、路口的转向规则等,为车辆的路径规划提供更准确的地图信息。
Occupancy Networks : Occupancy Networks (占用网络)是一种用于表示三维空间中物体占用情况的神经网络模型。它将空间划分为多个体素,通过网络预测每个体素被物体占用的概率,从而构建出环境的三维占用表示。在自动驾驶领域, Occupancy Networks 可以结合 MapTR ,实现完全无图的环境感知和理解。车辆无需依赖预先构建的地图,通过对周围环境的实时感知和占用网络的预测,能够理解道路上其他车辆、行人、障碍物等的位置和形状,以及可行驶区域,同时还能进行意图理解,预测其他交通参与者的行为,为车辆的决策和控制提供全面的信息支持 。
在大模型时代,利用 MapTR 和 Occupancy Networks 等技术,自动驾驶车辆能够摆脱对高精度地图的依赖,通过实时的传感器数据和深度学习模型,在线推理地图的拓扑结构,并理解其他交通参与者的意图。这种方法提高了自动驾驶系统的通用性和适应性,使其能够在没有预先地图的区域或地图信息不准确的情况下,依然实现安全、可靠的自动驾驶。
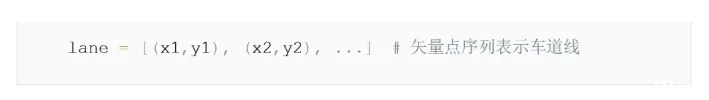
MapTR ( Map Transformer )基于 DETR ( TR 就是 transformer )框架 的在线地图感知模型,其核心设计是 直接预测矢量化地图元素 (如车道线、路沿、人行横道等),而非传统的栅格化分割结果 。
输入 : 多视角摄像头或 LiDAR 数据。
输出 : 结构化矢量元素(点序列 + 类别标签),例如(参考前面的几何矢量):
Occupancy Networks 通过 3D 体素网格 表示空间占用概率(如车辆、行人等动态物体),而 MapTR 的矢量化地图提供 静态场景结构 (如道路几何)。两者结合可以动静结合提供更好的实时建图服务。
三、典型方案举例
1 、 NVIDIA PilotNet
NVIDIA PilotNet 是英伟达开发的一种基于深度学习的端到端神经网络系统,用于自动驾驶汽车的路径预测和车辆控制。
技术原理: 通常以安装在车辆上的前置摄像头采集的图像作为主要输入,一般为 FP32 平面帧图像,建议图像宽高比为 8:5 ,最小分辨率为 960x604 像素。此外,根据网络设计,可能还会将车辆的速度、姿态等信息作为辅助输入。
网络结构 :由九个 layers 组成,包括五个卷积层,用于提取图像中的特征,构成卷积神经网络( CNN ),在计算机视觉任务中,对于利用图像作为输入来训练特征起着重要作用;三个全连接的密集层;以及一个输出层,用于输出车辆的控制指令,如方向盘的转角等。
训练方式: 通过收集大量人类驾驶时的图像数据以及对应的驾驶操作数据(如方向盘转动角度、油门刹车踏板位置等),将图像和驾驶动作的记录进行配对,使用这些数据对神经网络进行训练,让网络学习从图像到驾驶操作的映射关系。
功能特点: 路径预测:能够预测车辆在各种驾驶场景下的最佳行驶路径,如在保持车道、变道、岔路、转弯等操作时的轨迹,预测结果以世界坐标系表示。
可视化: 网络还会输出一个可视化掩码,用于突出显示输入图像中对网络决策有重要影响的区域。研究人员通过这种可视化方法发现, PilotNet 在驾驶时关注的位置和人类驾驶者相似,包括路标、道路边缘和其他车辆等。
应用场景: 主要应用于自动驾驶领域,作为自动驾驶汽车软件堆栈的一部分,它可以根据摄像头采集到的路面图像信息,实时调整方向盘的角度,控制车辆沿着正确的路径行驶。
局限性: 目前 PilotNet DNN 存在一定局限性,它仅适用于具有明确车道边界的高速公路和局部道路,在居民区等环境中性能可能会下降,在极端弯曲的道路上性能也会有所降低。
CNN 卷积神经网络是比较常见的概念,本文暂不赘述。
PilotNet 本身并没有使用长短周期记忆 LSTM ,但 LSTM 由于可以处理序列数据,所以常用于处理连续帧的视频,更加关注重要的帧。
2 、 BEVFormer
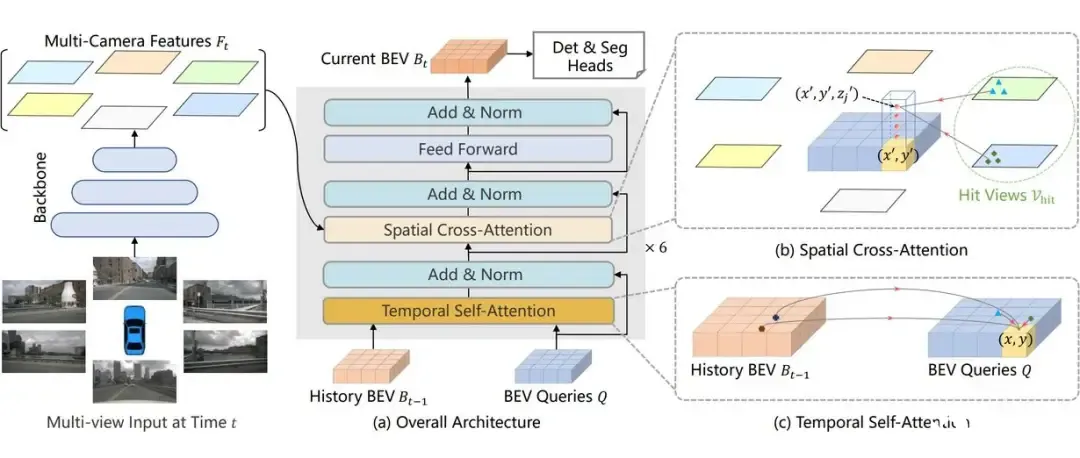
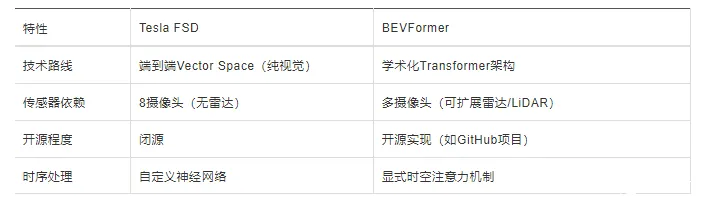
BEVFormer ( Bird」s Eye View Transformer )是一种基于 Transformer 的纯视觉感知算法,用于将多视角摄像头输入的 2D 图像转换为鸟瞰图( BEV )视角下的 3D 环境表示。其核心目标是解决自动驾驶中多视角融合和时空特征聚合的问题。 BEVFormer 是学术界对 Tesla BEV 技术的延伸和创新,通过 Transformer 实现了更灵活的时空建模,其核心思想与 Tesla 的 Vector Space 一脉相承。两者的差异主要体现在实现细节和开源生态上,共同推动了纯视觉自动驾驶的发展。
公开时间表如下:
其核心模块与原理本文罗列如下:
( 1 )输入与特征提取
输入来源是环视摄像头(如 6 个视角)的 2D 图像。输入数据是一个 6 维张量: (bs, queue, cam, C, H, W) 。其中, bs 表示 batch size 大小, queue 表示连续帧的数量, cam 表示摄像头的数量, C 表示通道数, H 和 W 分别表示图像的高度和宽度。
特征提取:通过 CNN 骨干网络(如 ResNet )生成多视角的 2D 特征图。
( 2 ) BEV 空间构建
BEV 查询( BEV Queries ):预定义一组网格状 BEV 查询(如 200×200 网格),每个查询对应 BEV 空间中的一个 3D 位置。
空间交叉注意力( Spatial Cross-Attention, SCA ):采样点生成:对每个 BEV 查询,在垂直方向( Z 轴)采样 4 个参考点,投影到多视角 2D 特征图中。
特征聚合:通过 Transformer 交叉注意力机制,将多视角 2D 特征与 BEV 查询关联,生成 BEV 特征。
( 3 )时序特征融合
时序自注意力( Temporal Self-Attention, TSA ):引入历史 BEV 特征(如前 1 秒的数据),通过自注意力机制融合当前帧与历史帧的 BEV 特征,增强动态物体(如车辆、行人)的轨迹预测能力。
( 4 )模块结构
BEVFormer 的 Encoder 由 6 层相同的 Transformer 层组成,每层包含:
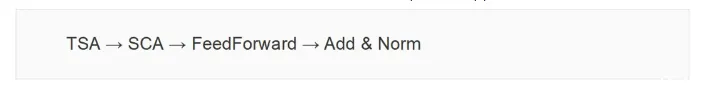
BEVFormer 通过 Transformer 实现了多视角视觉数据到 BEV 空间的端到端映射,其核心创新在于空间交叉注意力和时序自注意力的协同设计。该技术为纯视觉自动驾驶感知提供了新范式,但需进一步优化计算效率以适应量产需求。
直观上, 可以把 BEVFormer 想象成一个 「 智能拼图大师 」 :
1、输入 : 多个摄像头拍的零碎画面(就像一堆拼图碎片)。
2、处理 : 用 Transformer 的注意力机制,把碎片拼成一张完整的 俯视地图 ( BEV )。
3、优化 :结合过去几秒的地图,预测未来变化(比如车往哪开)。
4、输出 :自动驾驶车辆就能像玩 「 上帝视角 」 游戏一样安全行驶。
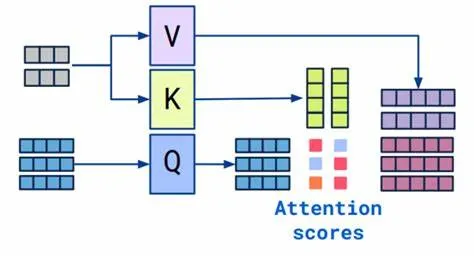
其中所谓交叉注意力( Cross-Attention )是注意力机制的一种变体,用于处理两个不同序列之间的交互关系。其核心思想是通过一个序列(查询序列, Query )动态关注另一个序列(键值序列, Key-Value ),从而提取跨序列的语义关联。
其输入结构如下:
查询序列( Q ):来自序列 A (如解码器的当前状态)。
键值序列( K, V ):来自序列 B (如编码器的输出)。
通过计算 Q 与 K 的相似度,生成注意力权重,再加权聚合 V 的信息。
BEVFormer 与 Tesla 方案的对比
四、 总结
无图技术的核心并非完全放弃地图,而是通过算法升级和算力提升,将传统依赖静态高精地图的 「 长周期记忆 」 模式,转变为基于实时感知的 「 动态认知 」 模式。这一转变的关键在于:车载传感器(如摄像头、激光雷达)与 AI 算法的深度协同 —— 通过 BEV (鸟瞰图)感知架构和 Transformer 时序建模,车辆能实时构建厘米级精度的 「 局部在线高精地图 」 ,并动态更新道路拓扑、障碍物位置等信息。
例如,华为 ADS 2.0 的 GOD 网络可实现 99.9% 的通用障碍物识别率,而理想的云端车端协同系统已支持 87 万台车实时验证无图 NOA (导航辅助驾驶)。这种技术路径既保留了高精地图的冗余安全价值(如应对极端天气),又通过算法弥补了传统地图更新滞后、覆盖不足的缺陷。本质上,无图技术是让车辆像人类司机一样,结合 「 实时观察 」 与 「 经验记忆 」 ,在动态环境中实现更灵活的驾驶决策。
而这一技术进步过程中,术语热词的先后变迁,为从业者在纷繁复杂的概念丛林绘制了一张简易路线图。






