作者:陶烟烟
在智能汽车、机器人和通用人工智能加速融合的背景下,特斯拉也开始聚焦 AI 芯片,从「硬件支撑」跃迁为决定产品能力上限的核心要素。
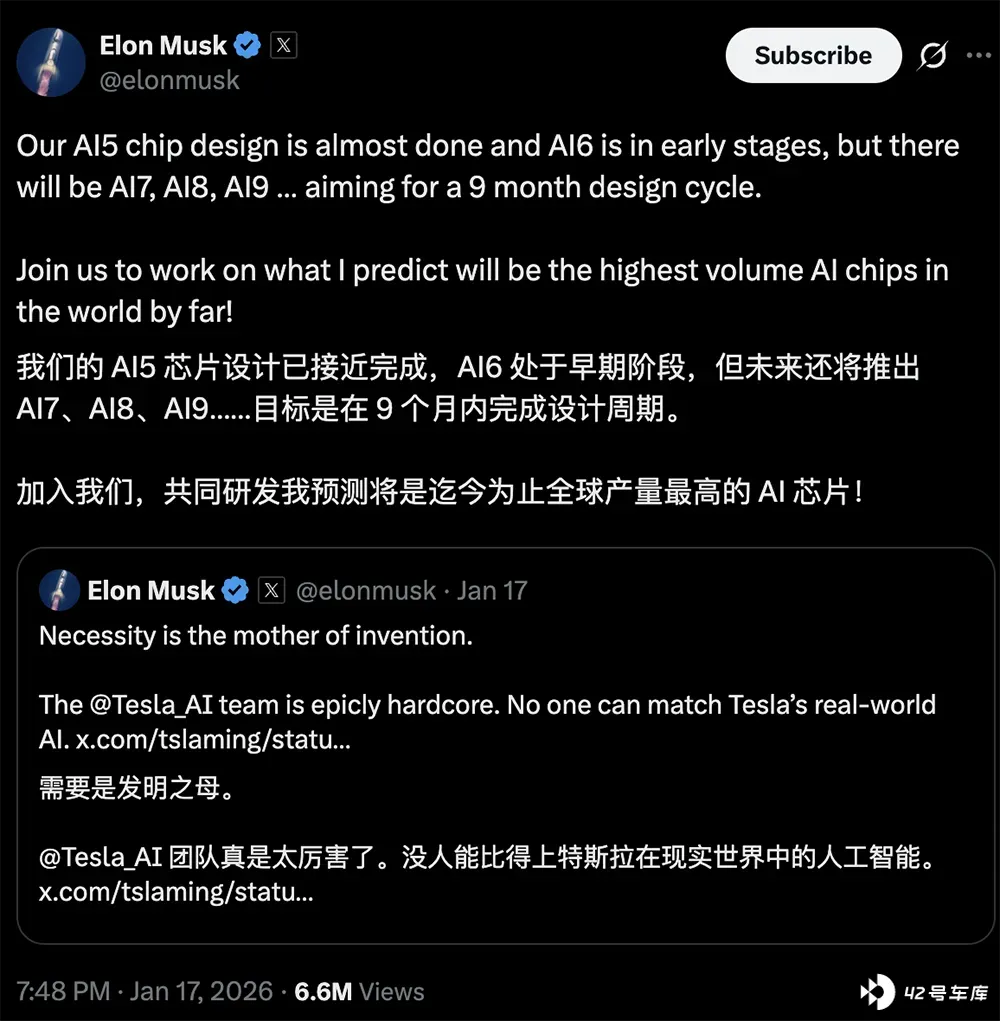
马斯克在社交平台上披露了特斯拉最新的 AI 芯片路线图: AI5 设计接近完成,AI6 处于早期阶段,未来还将持续推进 AI7、AI8、AI9 等多代产品,并将芯片设计周期压缩至 9 个月一代。
这个设计和更新的节奏,让我们看到了之前特斯拉一贯的作风,在重要和能够改变战局的领域投入重要的资源。
从 HW3/AI3、HW4/AI4 到即将到来的 AI5,特斯拉车端芯片的目标围绕两点展开:
◎ 为 FSD 提供更高算力和更大内存空间
◎ 为未来更复杂的端到端大模型留出冗余
HW4/AI4 时代,特斯拉芯片的制程约为 7nm,算力约 216TOPS 支持当下 FSD V12 的端到端推理。这仍远不足以支撑完全自动驾驶和具身智能的长期目标。
AI5 被寄予厚望,在制程上同时采用三星 2nm 和台积电 3nm 两个先进节点,马斯克讲的「50 倍性能提升」,综合了原始算力约 10 倍提升、运行内存容量提升至 AI4 的 9 倍等多重因素。
如果我们推测,AI5 单颗芯片的有效推理能力可能突破 2000TOPS 级别。
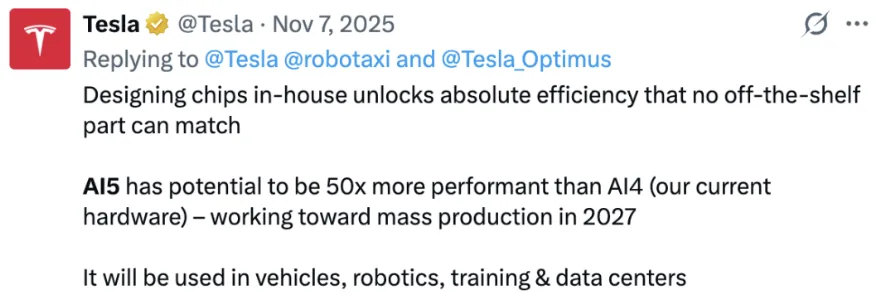
AI5 面向特斯拉的两大核心业务:FSD 和 Optimus 人形机器人 ,未来特斯拉的汽车和机器人将共享同一套算法体系和硬件平台,统一的「感知-决策-执行」技术栈,使得特斯拉在具身智能领域具备独特优势。
特斯拉通过芯片与算法的复用,将智能车视为「移动机器人」,把机器人视为「会走路的汽车」,从底层架构上实现协同进化。
在 AI5 之后, AI6 的定位进一步扩展到「训推一体」, 即同时支持端侧推理和云端训练,特斯拉采用 HW 系列芯片部署在车端,而 Dojo 系列芯片用于数据中心训练,两条技术路线并行推进。
但马斯克在去年 8 月宣布解散 Dojo 团队,理由是「同时设计两种不同芯片分散资源,没有意义」,短短几个月后,马斯克又宣布重启 Dojo 项目,并将其重新命名为 AI7,且用途从地面数据中心扩展到太空算力,这路走宽了,特斯拉芯片路线从「汽车专用」走向「跨场景通用 AI 算力平台」。
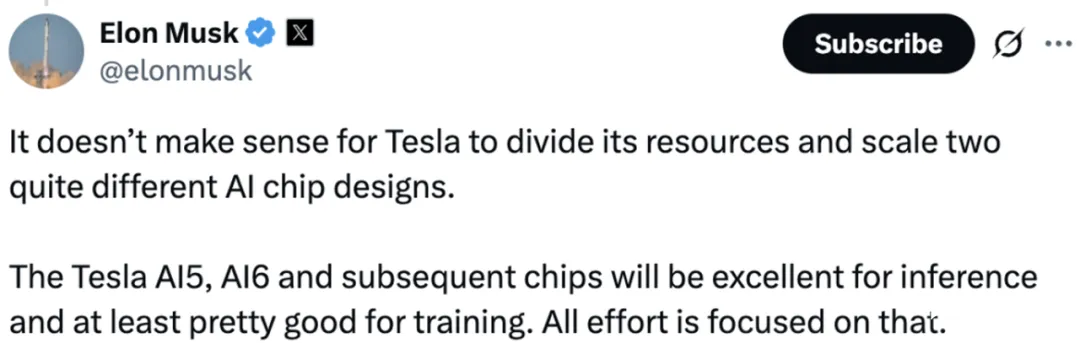
Dojo 最初的目标,是为特斯拉的自动驾驶训练提供定制化高效算力基础设施。
首代 D1 芯片基于 7nm 工艺,在 2021 年 AI Day 上亮相时,被视为对英伟达 GPU 的一种「垂直整合替代方案」,随着 AI 模型规模快速膨胀,以及特斯拉业务线同时覆盖汽车、机器人、能源和航天,单一用途的训练芯片逐渐显得灵活性不足。
AI6 和 AI7 被设想为既能支持端侧推理,又能服务数据中心训练,甚至适应太空环境的通用 AI 算力芯片。
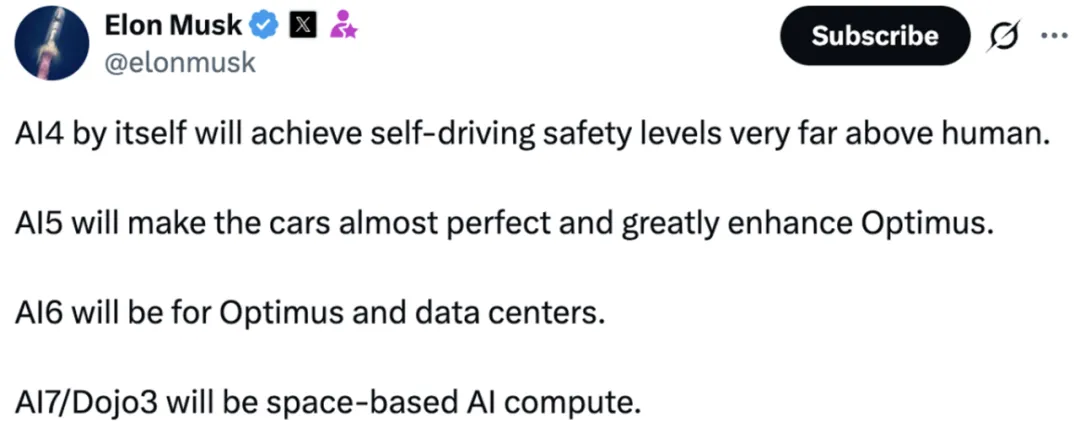
太空算力成为 AI7 的重要应用场景,也有一个暗线,特斯拉与 SpaceX 之间的深度协同,将高性能计算系统送入轨道,利用太空环境在延迟、覆盖和基础设施成本上的潜在优势。
SpaceX 具备成熟的发射能力,而特斯拉掌握 AI 芯片和算法设计,两者结合为构建「太空数据中心」提供了独特条件。
相比地面数据中心,太空算力需要应对辐射、散热和能耗等极端环境挑战,这对芯片的可靠性、功耗控制和系统架构提出了更高要求。
在路线图的后半段,马斯克还提到了 AI8 和 AI9,并给出了一个极具冲击力的目标:芯片设计周期缩短至 9 个月一代。
如果这一节奏得以实现,传统汽车平台的生命周期通常在 3-5 年,电子电气架构和算力升级节奏明显滞后于 AI 算法的发展速度。特斯拉试图通过更快的芯片演进节奏,将算力升级与软件能力提升深度绑定,使硬件始终为算法留出空间。
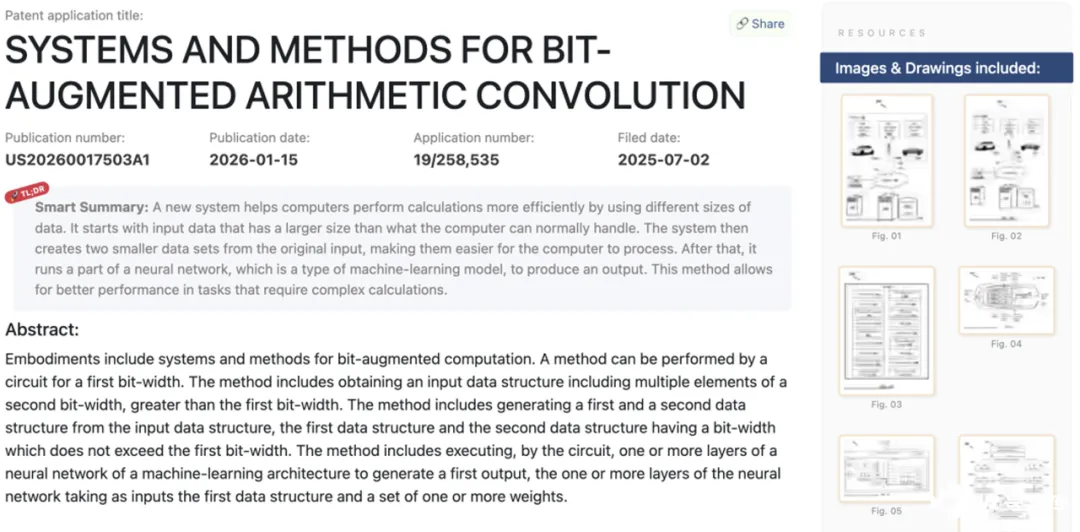
特斯拉提出了一种工程化补救方案,特斯拉通过在输入端对数据进行分块,让 8 位低精度芯片处理 16 位数据,并在输出端重建高精度结果,从而在一定程度上延长老款 AI3 芯片的「可用寿命」,以系统工程方式延缓硬件淘汰的思路,特斯拉在用户规模和长期产品生命周期之间的平衡策略。
小结
特斯拉的 AI 芯片路线图,算力增长极为激进,从 AI4 到 AI5 的 50 倍性能提升,远超行业平均节奏;应用场景不断扩展,从车端推理到机器人、数据中心,再到太空算力,迭代周期大幅压缩,试图用 9 个月一代的速度匹配 AI 模型的快速演进。