撰文 | 青竹
编辑|周长贤
缩量、出海和监管,是 2026 年车业的主旋律。有形的手和无形的手,都在上强度。
事已至此,与其胡乱出招,一些品牌索性回归基本动作,按部就班做自己。例如做品牌、做个性、做 AI 。
自研 AI 是何小鹏的执念,而且自研和 AI 一个都不能少。他坚信自研 AI 的车企会在未来的某个奇点,呈现出与友商截然不同的质感。
于是我们看到, 2026 年过了 8 个月,小鹏的智能辅助驾驶迭代了两次。
第一次是年初,小鹏第二代 VLA 面向用户量产推送,在 「 安心丝滑、全场景能力、高效率 」 三个维度全面升级。
第二次,是 8 月份,第二代 VLA 大模型迎来首次重大升级,让 AI 开始真正理解时间。
2026 年 8 月 27 日,广州,小鹏物理 AI 分享会,主题: 「TIME 时间 」 。
距离年初第二代 VLA 首发,过去了不到八个月。距离何小鹏和智驾负责人刘先明著名的赌约 ——2026 年 8 月 30 日,小鹏 VLA 在国内的体验要赶上特斯拉 FSD 在硅谷的水平 —— 还剩三天。
但是,这次发布并不是赌约到期的一次交代和参数提升,而是小鹏让 AI 真正理解物理世界,并做出决策和行动的持续探索。
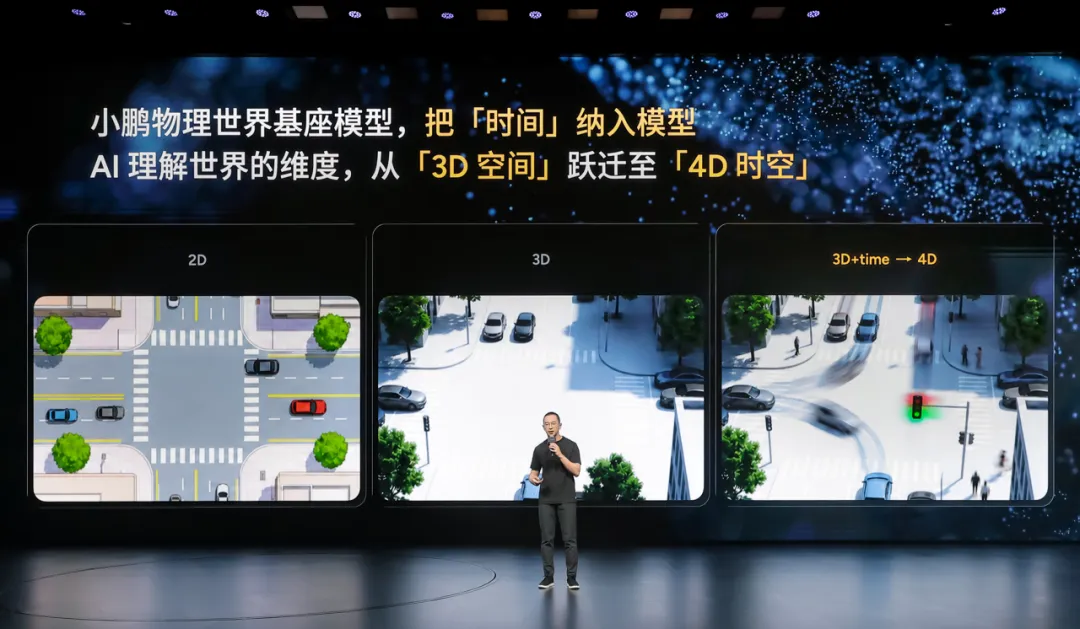
主题 「TIME 时间 」 ,明示了本次模型首次重大升级的主要逻辑。把「时间」纳入模型,从静态「 3D 空间」跃迁至动态「 4D 时空」。多了一个 D ,推理和训练层面都有改变。
从 3D 到 4D , 「 时间 」 是什么能力?
首先,「 4D 时空」才是真实人类世界。但智驾跟人的感受,又略有不同。
人是爱回忆的时间轴生物,对远期时间有细致强烈感受。比如 「 欲买桂 花同载酒,终不似,少年游。 」
但对于智驾模型来说, 「 少年游 」 的时间戳叙事没有意义,只要学会老司机的能力就行。模型阅过的海量时空数据更像是一张静态图谱;而大量的训练时间,则凝练为模型能力。
智能驾驶,真正有意义的时间,即工作记忆,代表一种应变的能力,体现在两个具体维度上:轨迹预测和响应速度。
先看轨迹预测。
人类老司机在开车时,其实一直在做无意识的预测。前方那辆出租车在慢悠悠地靠右,你大概率知道它要靠边接客了,即便它不打灯。不但知道有车有人,还能猜到它们往哪里走,几秒后会到达什么位置。
预测能力,第一来源于模型能力,第二来自前序记忆。
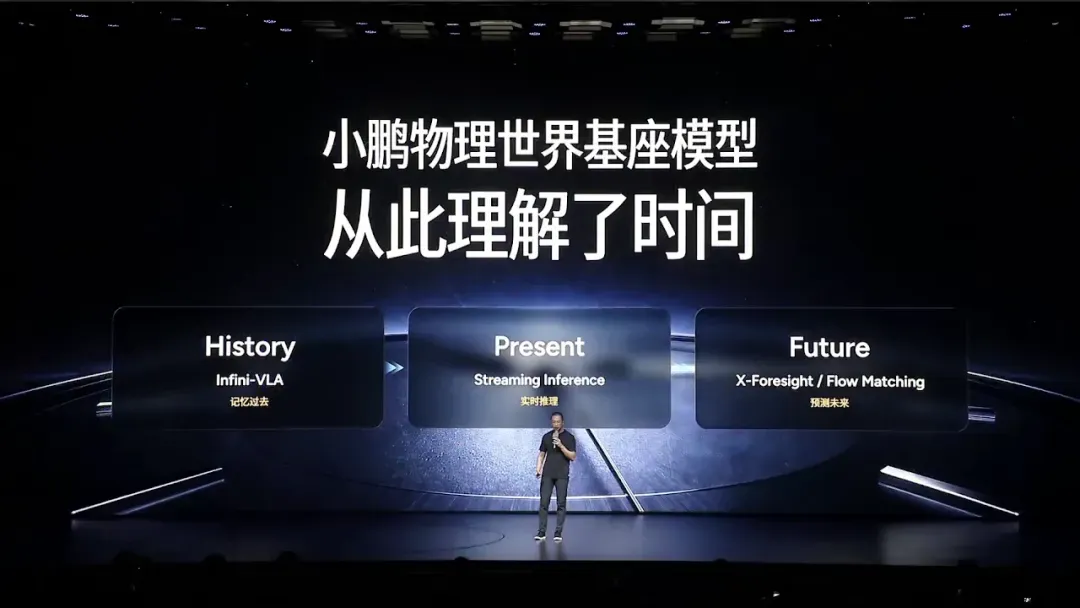
此次 Infini-VLA 长时序架构 的 30 秒记忆留存,是小鹏团队权衡下来的一个时间。 保留太长记忆,无意义信息占用算力内存,影响效率;保留太短可能信息不全。 30 秒是一个充分且有用的时间,让足够的有效视觉信息进入决策。
与之相对的是 第二代 VLA 的 X-Foresight 预测世界模型 ,能 预测 6 秒未来。
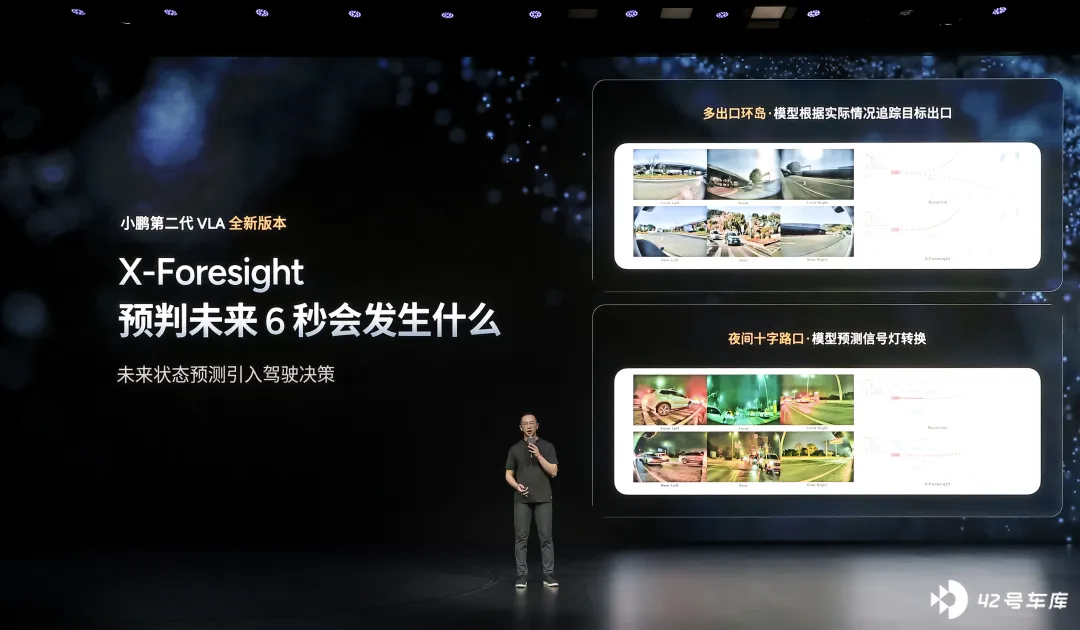
刘先明透露,其实可以预测 21 秒,取 6 秒是为了效果最优,省算力也保证准确度。
因为系统要并行预测的目标物,往往多达数十上百个。每个目标物的位置、速度、运动趋势、道路环境约束,都在同步推演,甚至互相干扰,时间越长变量越多,准确度下降。
正如刘先明所说,这不是一个功能的增量迭代,而是模型认知维度的底层跃迁。
智能驾驶判断有了更长的上下文之后,思维模式发生了变化,从离散的概率推论 + 强化,变成了因果思考。
前车为什么刹车?因为前方路口有行人突然折返。行人为什么折返?因为他看到对面有来车。这些事件之间存在时间上的因果链条。把碎片化的道路事件串联起来,形成连续时序认知。
那么有了记忆,有了预判,有了认知,怎么能提升智驾效率呢?
这里刘先明介绍了「流式自回归推理」的概念。简单说,既然认知已经从离散,进化到连续,那么推理也要节奏同步。
过去 「 看一帧算一帧,再看,再算 」 的离散模式,天然带着一种滞后性。模型永远在处理 「 上一帧 」 的信息,无论系统有多快,只能追赶和无限靠近现实。
「流式自回归推理」可以 「 边看 → 边想 → 边行动 」 。
从离散推理走向连续推理 ,流处理的结果是,不但端到端响应提速 300% ,输出的动作也是天然衔接不割裂的,俗称丝滑。
流式自回归推理的另一层意义,在于多模态融合的效率。
传统模式下,摄像头、激光雷达、毫米波雷达的数据往往需要先做时间戳对齐,对齐产生额外延迟。流式推理模式下,新到达的模态数据进行局部更新,更快进入模型、更快参与决策。
当反应速度足够快时,系统从 「 被动应对 」 变成了 「 主动博弈 」 。就会靠近何小鹏一直期待的临界点。
「 通用基座模型, 95% 的冰山在水下 」
但无论大模型再强,时间理解再深,最终都要端侧算力去承接。
尽管小鹏自研的芯片单颗 750 TOPS , 总是配足,但刘先明强调 「 端侧算力总是有限的 」 。模型越大,端侧部署的挑战就越尖锐。
第二代 VLA 端侧模型新的参数量扩大 3.5 倍,达到主流 VLA 模型的 15 倍以上。这是一个数量级的差距。总不能每升级一次,就加三倍的图灵 AI 芯片,那成本可太要命了。
如何给端侧算力提效?
新版模型引入 MoT(Mixture of Tasks) 混合架构,要解决两个问题:一个是任务干扰,一个是全量推理的浪费。
MoT 类似 DeepSeek 用过的混合专家思路,把基座模型拆解为多个 「 专家模块 」 ,每个专家针对特定类型的驾驶任务做深度优化。针对不同任务动态分配和激活不同专家,让大模型在有限车端算力上跑出最大有效能力。
一套组合拳下来,模型多维综合安全能力提升 20 倍。
20 倍。意味着当模型在多维度同时提升时,安全能力的跃升不是线性的,而是指数级的。
车端要省着用,但是基座模型越大越好的 scaling law 似乎越来越成为共识。
更大的参数量意味着更强的泛化能力 —— 模型见过的场景越多、学到的模式越复杂,在面对未见过的边缘场景时就越从容。
对于野心更大的小鹏来说,复用不光要从中国复用到全球市场,还要跨载体。
第二代 VLA 的同一套物理 AI 基座模型,已经在小鹏人形机器人 IRON 完成端侧落地。 IRON 搭载 3 颗图灵 AI 芯片,算力 2250TOPS ,可自主完成复杂任务。
大模型和泛化,大概是一个鸡生蛋和蛋生鸡的问题,如果想负担起大模型的费用,就必须泛化来分担研发成本,如果要提高泛化效率,模型必须更大。
汽车和机器人,看起来是完全不同的硬件载体,但它们面临的底层问题是一样的 —— 如何在物理世界中感知、理解、决策、行动。
小鹏机器人业务在 8 月 24 日完成首轮股权融资,融资金额超 9 亿美元,投后估值超 63 亿美元,刷新了中国具身智能行业单轮私募股权融资纪录。
资本的认可,某种程度上是对这套 「 统一物理 AI 基座 」 逻辑的认可。
第二代 VLA 全新版本不只升级智能辅助驾驶,小鹏用做机器人的方式重构了车机大脑,首次推出 Master Agent ,实现 VLA 与 VLM 的驾舱融合,让车辆从 「 听懂一句话 」 走向 「 理解用户真正想完成什么 」 。
基于小鹏自研的 Omni 全模态模型,整车第一次拥有了「统一大脑」, 统一的决策层。 它不仅能理解自然语言和模糊语义,还能将用户意图自动拆解为多任务,并调度智驾、底盘、座舱、车身控制等垂直 Agent 协同执行。
而在全球化维度上,第二代 VLA 已经完成德国本地化验收测试 —— 在几乎不增加本地化训练数据的前提下,海外道路表现和国内高度接近。 小鹏目标 2027 年起逐步向全球用户交付更适合本地道路环境的智能辅助驾驶系统。
这些能力的背后,是一整套长期建设的「 AI 基础设施」 —— 形成了 「 大模型 + 大数据 + 大算力 + 多本体 」 的闭环。
小鹏在做的,不是简单的功能或产品的叠加,而是在持续建设这四个底层变量。持续建设万卡集群,自研大算力芯片,依托百万车队积累的十亿级数据资产,大模型单次训练数据吞吐量已达到 1 亿 clips ,较半年前增长 10 倍。
看得见的是一次大版本升级,是 3 倍、 3.5 倍、 20 倍这几个数字,是第二代 VLA 在主流道路智能化达到全球第一梯队,看不见的是庞大的通用物理 AI 基座模型的基建,是持续迭代模型的能力。
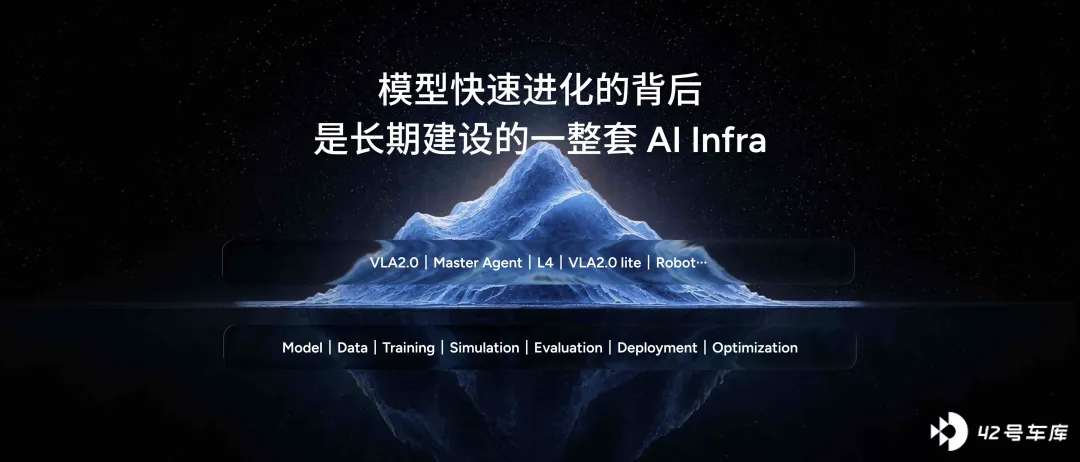
刘先明说, 「95% 的冰山都在水下。 」 体现了小鹏做物理 AI 公司的决心。
结语
从 3D 到 4D ,从 300% 到 20 倍,从 L2 到 L4 ,从汽车到机器人。小鹏在 2026 年做的所有事情,本质上只有一件:把一个基座模型越做越大、越做越深,然后让它跑在越来越多的硬件上。
在行业焦灼的 2026 ,这看起来不像一个 「 大招 」 。但这恰恰是最难复制的东西 —— 一个需要持续投入数年的漫长过程,是无论市场起伏,都坚定往前推进的企业护城河基建。
刘先明在分享会上说,这是 「 先难后易,以终为始。 」
「 先把最难的问题解决了,解决真正的问题,而不是给一个临时答案。不是打补丁,做真正的 AI 公司。 」