


撰文 | 青竹
编辑|周长贤
2026 年,头部智驾已经集结完毕。在「大模型 + 世界模型」范式共识下,大家殊途同归,都实现了软硬一体,虽然来时路各不相同:
华为始于软硬锁定的封闭系统;英伟达从通用芯片出发,客户自己算法适配;而 Momenta 走了一条独特的路,从软到硬,且兄弟联手 ……
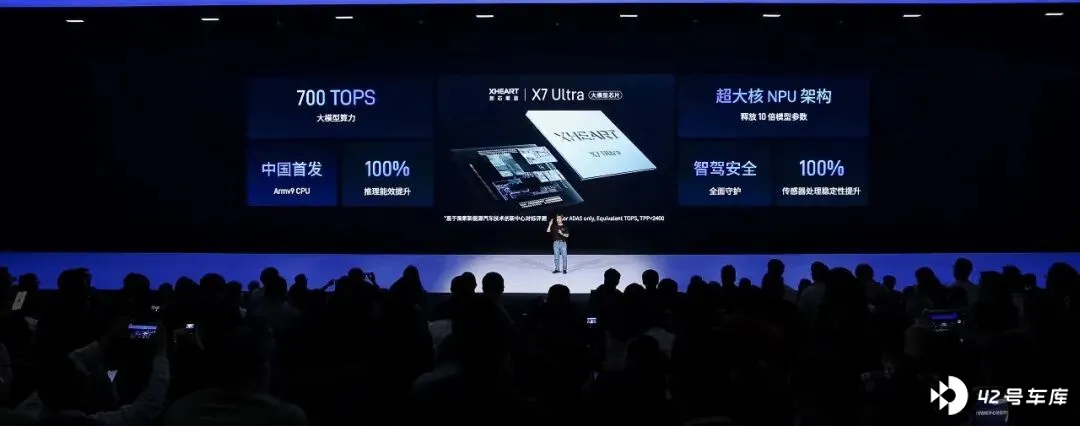
10 月 29 日, Momenta 的兄弟公司 XHEART 「新芯航途」,抢了一步先手棋 —— 发布大模型芯片: X7 Ultra 。
同时, Momenta 即将发布 R7 Ultra 世界模型,并且多次强调一个词汇:双方 co-design 「协同设计」。
「 让大模型定义芯片,让芯片承载大模型的下一次进化。 」 发布会上, XHEART 新芯航途 CEO 李宗霖这句话,概括了大模型芯片的战略意图。
在卷模型、卷数据、卷算力的同时,一款量身协同打造的大模型芯片,可能意味着事半功倍。
Momenta 的 CEO 曹旭东把新的芯片范式,视为指数级增长的关键引擎,并首次公开他的「第三个洞察」。
曹旭东指出,当智能驾驶迈向 L4 规模化时,车载系统需要承载百亿、千亿参数的大模型,但现有通用车规芯片陷入了 「 不可能三角 」 。
破解之道就是专用大模型芯片,从现有智能驾驶大模型需求出发,反向定义和设计芯片的 NPU 架构、内存层级和技术特点。
这并非普通芯片的「 升级版」 ,而是一种范式转移。官方给出的对照是:相比通用芯片路线,同等成本功耗下性能提升潜力约 10 倍。
那么这颗大模型芯片 X7 Ultra 怎么做到的?
大模型芯片:破解不可能三角
新车发布,往往爱展示参数,多大 TOPS 算力、多少传感器、多少线激光雷达 …… 但这里有个小陷阱,数字并不必然等于能力。软硬不适配的算力,其实根本用不上。
例如,智驾模型已经到大模型阶段,但在用芯片大多是之前的通用芯片或优化版。某些大算力芯片还能堆冗余来应付,但要付出成本和能耗。
于是通用芯片的结构性困境凸显: L4 级百亿甚至千亿参数的大模型,要求海量的矩阵运算和向量运算,通用芯片相当一部分算力给了控制逻辑、缓存管理和通用接口,真正矩阵运算的只是一部分。
更关键的是,这些计算单元往往被拆分成许多个小核,彼此之间通过 「 核间互联 」 来交换数据。当模型大了,通用芯片就倒腾不开了,不是在运数据,就是在等数据,损耗时间,损耗效率。
尤其在车端功耗、散热和车规可靠性的多重限制下,大部分算力无法被充分调用。
但是,X7 Ultra 的设计逻辑不是堆通用算力,而是从大模型倒推芯片架构,重新组织计算、存储和数据流转。芯片定义阶段就与算法团队共同开发,设计模型架构和关键算子,以承接面向 L4 的 大模型。
X7 Ultra 的第一个设计:把 「 小核之间的对话 」 ,变成 「 超大核内部对话 」 。
专为大模型设计的超大核 NPU ,将传统小核之间百 GB/s 级的数据交互,聚合至超大核内部 TB/s 级的高速互联,实现带宽数量级提升。
数据搬运的功耗和时间被大幅压缩。在大模型推理中,数据搬运本身就是功耗的大头。把交互从核间拉到核内,等于从根源上砍掉了一大部分无效消耗。最终 「 内存带宽消耗下降 80%」 ,核心来源之一就在这里。
第二:给 Transformer 里那几个「磨人」的算子,配专用工具。
Transformer 里并不是所有运算都一样,有一些高频关键算子 LayerNorm 、 Softmax 、 Transpose 等,很耗资源。 X7 Ultra 给它们配置高精度专用加速引擎,不再频繁占用通用计算单元,浪费算力。
第三:并行度打开,让计算单元「别闲着」。
计算单元再多,如果调度不当,很多单元会在那里等数据、等权重加载,实际干活的只是一部分。
X7 Ultra 在底层做了软硬协同的并行度解锁,让更多计算单元同时工作,并且让 「 计算 」 和 「 权重加载 」 并行,减少互相等待的空窗期。
这不是单纯堆硬件,需要对 AI 工具链做整网级融合,统一编排模型计算任务,减少中间结果反复读写外部内存。
第四: Armv9 车规级 CPU ,一个强大的「管家」。
NPU 算得够快,如果控制和调度跟不上,最终还是被卡。 X7 Ultra 在中国首发量产了 Armv9 车规级 CPU ,性能提升 20% ,能效提升 10% ,大集群架构提升了多核协同与 L3 访存性能,并集成了 SVE2 向量处理引擎,让整颗芯片高效协同。
第五:深度异构计算:传感器专用计算「随手干活」
其实和 「 核内数据交互 」 是同一个逻辑,都是减少数据搬运。
激光雷达和摄像头产生海量原始数据,如果全部先送到 NPU「 预处理 」 ,会占用大量带宽和时间。 X7 Ultra 的思路是:用专用计算单元就地完成预处理,减少中央计算负担,激光雷达处理带宽最高达到 2000 万点 / 秒,预处理稳定性提升 100% 。
以上几个动作下来,效果立竿见影:
量产模型实测 NPU 计算利用率 98.7% 。 意味着这颗芯片的 700 TOPS 大模型算力不是纸面数字,几乎全部被喂给了模型计算本身。在车端功耗和散热被卡死的前提下, 「 不浪费 」 意味着一颗顶 N 颗。
推理能效提升 100% 。 同样跑一个模型,耗电减半。对电动车来说,智驾芯片的功耗不是实验室参数,直接吃整车能效,影响热管理设计。
可部署模型参数量提升 10 倍。 在智驾大模型时代,这个指标关乎终极兑现。
目前,大算力芯片是世界模型上车的基准算力要求,以后的模型更大, L4 需要百亿到千亿参数的模型, 车端和成本约束下, 通用芯片 塞不下。 而 X7 Ultra 让更大量级大模型在功耗和成本可接受的车规条件下跑起来。
李宗霖表示,这款芯片 700TOPS 的大模型算力不是实验室结果,具有量产测评一致性,也预留了 OTA 的性能冗余。
「 智驾摩尔定律 」 与芯片节点的咬合
发布会上,曹旭东首次公开分享公司的第三个洞察: 「 大模型定义芯片。 」
「 大模型定义芯片 」 的背后,是 XHEART 与 Momenta 对技术方向的共同判断,也是联合开发对「 智驾摩尔定律」 的紧密咬合。
这一判断形成于 2022 年底,曹旭东认为,相比通用芯片, 大模型定义的芯片性能能够提升 10 倍。
过去四年,智能驾驶的摩尔定律是 「 两年十倍 」 ,但曹旭东在 2026 年 10 月的最新判断是:这一规律正在向 「 每年十倍 」 加速。
「2026 至 2028 年,头部企业相关指标每年提升十倍是可能的。 」
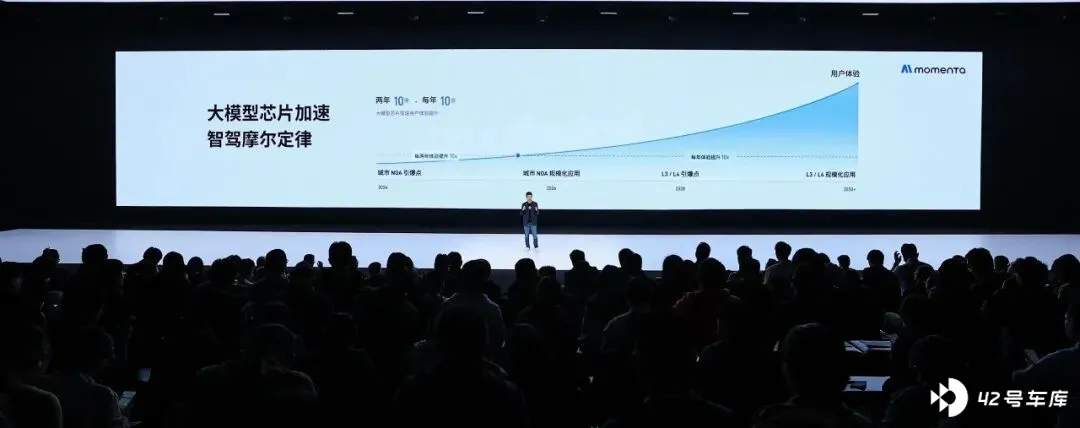
由此,他判断 2028 年是 L3/L4 落地的引爆点; 2030 年 L3/L4 有望实现规模化渗透,智能辅助驾驶全面达到并超越人类水平。
在当下节点,一颗大模型芯片将成为关键「加速器」。因为 模型、数据、芯片这三件事,必须像齿轮一样咬在一起转,而且转速要同步加快, 每一环都不能拖 。
即将发布的 R7 Ultra ,展现了这一协同的最新成果。
基于 X7 Ultra 的支撑, R7 Ultra 的模型参数规模扩大 5-10 倍,安全性能提升 5-10 倍以上,推动世界模型从 「 理解世界 」 走向 「 推演世界 」 。
Momenta 的数据侧也在加速,累计交付超过 140 万台,最近的 10 万台用时不到一个月。海量数据在涌进来,模型在变大,如果芯片跟不上,前两环的加速度就会被硬件瓶颈吃掉。
在圆桌论坛上,图灵奖得主 Jack Dongarra 教授表示,让算法、软件与芯片团队在设计定型前紧密协作,是面向大模型时代,更加行之有效的研发方式。
「 大模型定义芯片 」 的技术路线,正在接受规模量产的检验。
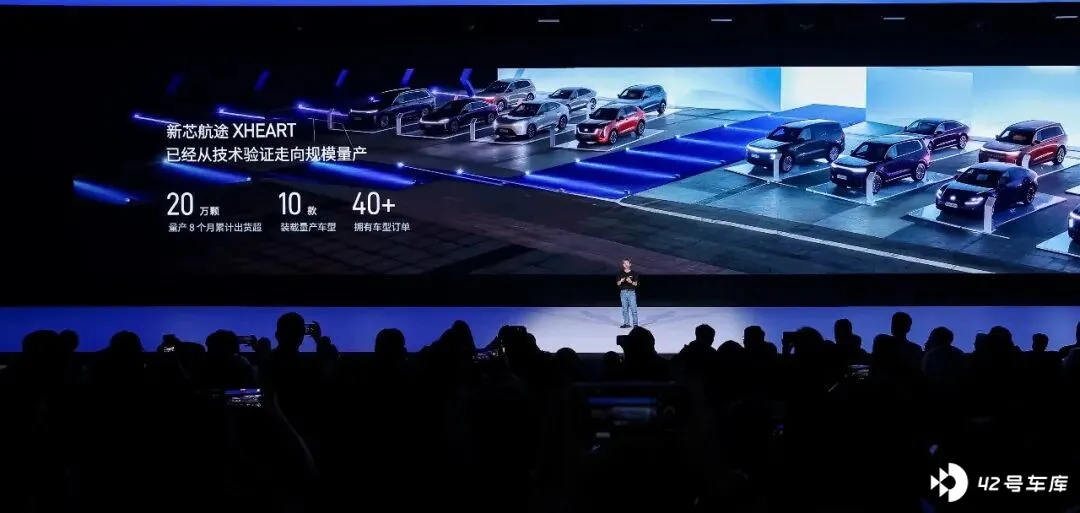
从成立到芯片量产, XHEART 用了两年。截至发布会, X7 系列已量产 8 个月,累计出货超过 20 万颗,搭载 10 款量产车型,获得超过 40 款车型订单。基于双 X7 的 L3/L4 计算平台,也已获得多个车型项目定点。
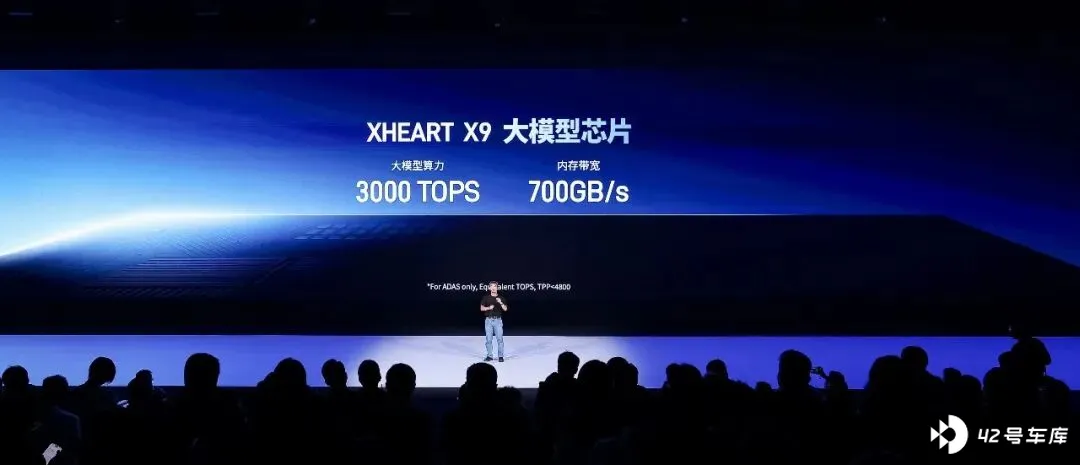
「 每年十倍 」 不只争当下这一年。面向下一代更大模型, XHEART 公布 X9 的核心研发目标: 3000 TOPS 大模型算力、 700GB/s 单芯片内存带宽,计划于 2027 年推出。
通过计算与访存能力同步提升,曹旭东透露,下一代 X9 芯片将支持端侧模型规模进一步扩大 100 倍。
结语
X7 Ultra 的定位不局限于车,曹旭东认为,大模型定义芯片的路径要 「 进一步推动机器人及更多物理 AI 应用取得突破 」 。
也不局限于国内, XHEART 的战略轮融资里,雷诺集团首次投资,奇瑞追加投资,长鑫科技入局。与此同时, Momenta 一侧已与全球 27 家车企合作,覆盖全球前十大汽车集团,量产方案在 10 多个国家和地区落地。
X7 Ultra 意味着全新定义的大模型芯片时代开启, 「co-design」 开发范式和 100B 参数大模型时代的螺旋新起点 —— 接下来的问题是,这个起点到 X9 的两年窗口,够不够把先手变成胜势。


