出行百人会旗下媒体,关注汽车出行产业链进化
作者:李逸之
8 月 20 日,特斯拉预热已久的 AI Day 如期举行。一如以往的投资者日公开活动,AI Day 同样以秀技术肌肉为主,以顺便招人为辅。
然而,今年的 AI Day 在秀技术的时候实在用力过猛,各种专有名词出现的频次和信息密度之高,让涌入直播间试图看个乐呵的网友们直呼头秃。大家的普遍反应如下:
但 AI Day,正值特斯拉在自动驾驶技术上确立新路线的当口。通过这次烧脑的公开日,特斯拉试图解释,为什么他们选择在纯视觉自动驾驶技术路线上走到底 —— 甚至,他们选择这条道路,或许不仅仅只是为了造出自动驾驶汽车。
对这场难度超纲的 AI Day,我们连夜组织了技术攻关,选择了视觉神经网络、数据集、Dojo 超算以及 Tesla Bot 四个关键词,尝试去厘清它们与特斯拉自动驾驶汽车、它们之间的内在联系,以飨读者。
特斯拉的视觉智能进化
正式讲 AI Day 之前,先补充一点背景知识。
从今年 5 月开始,特斯拉移除了北美市场上新交付的 Model 3 和 Model Y 的毫米波雷达。从那一刻开始,特斯拉就已经宣告,新的视觉技术框架已经确立,它要走上一条 「仅凭视觉智能实现自动驾驶」 的道路。
特斯拉 CEO 马斯克一直笃信,人既然仅凭视觉就可以开车,那么根据第一性原理,自动驾驶汽车应该也能做到。
而负责领导这项工作的特斯拉 AI 主管 Andrej Karpathy(安德鲁・卡帕西),其实在去年的一场公开演讲上就给出了提示。当时他说,特斯拉正在尝试用视觉神经网络,去准确 「预测」 物体的速度与距离 —— 这就是毫米波雷达的功能。
一年之后,特斯拉正式挥舞起 「纯视觉路线自动驾驶」 的大旗。
但特斯拉视觉团队所做的工作,远比 「拿掉毫米波雷达」 要多得多。「始作俑者」 安德鲁,在 AI Day 上讲述的,正是特斯拉视觉智能数年来的进化。
4 年前,安德鲁刚从 Open AI 加入特斯拉带领视觉团队时,特斯拉在视觉 AI 上的技术并没有啥令人惊叹的地方。特斯拉那时开发了一个结构不太复杂,层数不太多的神经网络,用于进行单帧的图像处理,在 2 维图像上输出识别、追踪、语义分割等结果。它的特点是比较高效,在延迟和准确率之间有比较好的平衡,显然性能并不出色。
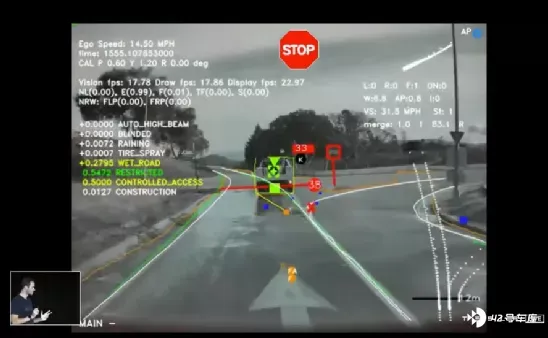
而当特斯拉开始启用车上的 8 个摄像头,决心向 FSD(full self-driving 全自动驾驶)进发时,发现如果按原来的技术框架,让 8 个摄像头各自为战,然后将它们的识别结果整合起来去指导驾驶,那么车辆根本无法变得更智能。比如 「智能召唤」 功能的率先跳票,就是 「过于简单的技术无法搞定复杂的世界」。
随后,特斯拉视觉团队开始对神经网络的技术框架进行大规模的修改,决定将 8 个摄像头采集到的信息捏合到一起,并通过一个转换器(Transformer),输出为一个三维的向量空间(而不是原来的 2 维图像)。看图就知道,多摄像头融合后输出的向量空间质量更高,能够帮自动驾驶汽车更精准地感知世界、定位自身。
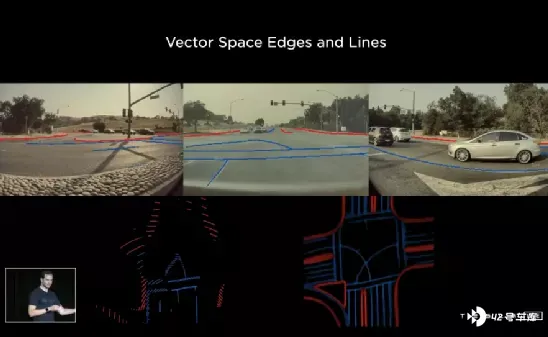
但这并没有万事大吉,因为在这个向量空间中缺少时间标记。从自动驾驶汽车的角度看,它并不知道上一刻与这一刻所看到景象的内在联系,没有 「记忆」。随后的关键工作是,特斯拉视觉团队在神经网络中插入一个特征队列(Feature queue),它的任务是能够记录下时空信息,让后面的结构能够从中提取记忆。
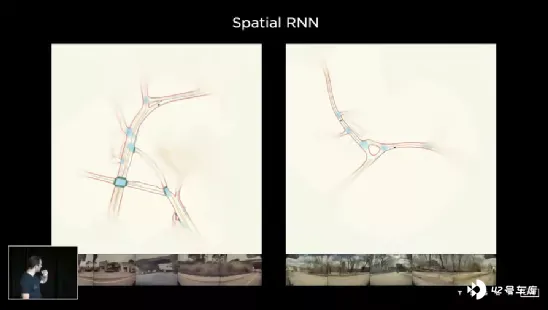
在拥有了时空概念后,自动驾驶汽车能理解的不再仅仅是单帧的图像。在此基础上,视觉团队开发了一个视频模块,将凝固在某一刻的时空特征,转化为连续的。它使得自动驾驶汽车可以追踪物体的连续运动,可以凭借 「记忆」 实时绘制出驶过道路的地图,在面对识别物体被遮蔽的场景时,也更加聪明了。
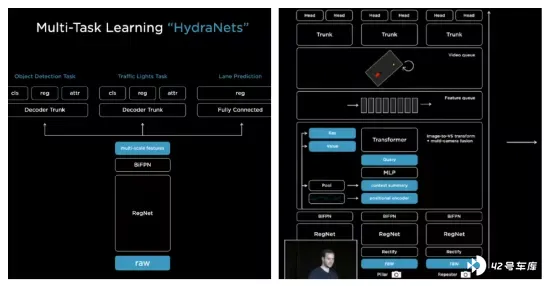
以下,便是特斯拉如今实现这一效果的视觉神经网络的结构(图右)。显然,相比于四年前的框架(图左),它的复杂程度已经成倍增长。而 Andrej 的团队还在想办法将其进一步优化,例如,把加入时空特征的步骤向神经网络的下方移动(提高信息效率);又或者,在神经网络底部增加一些模块如立体视觉匹配、光流(提高识别性能与深度预测准确性)等等。
事实上,AI Day 应该是特斯拉所有公开活动中理解难度最大的一次。以上的内容,对一个吃瓜群众来说已经完全超纲了。但如此复杂的技术结构,其实刚刚走完了自动驾驶汽车的第一个步骤 —— 感知。如何让车辆依托感知的结果进行合理的操作,同样是一个浩瀚的工程。
话筒接下来交给了特斯拉自动驾驶规划与控制团队负责人 Ashok Elluswamy。他将自动驾驶汽车执行操作的核心任务分解为了三个目标 —— 安全、效率、以及舒适。和人一样,自动驾驶汽车执行动作前,需要根据感知结果做出驾驶路线的规划。
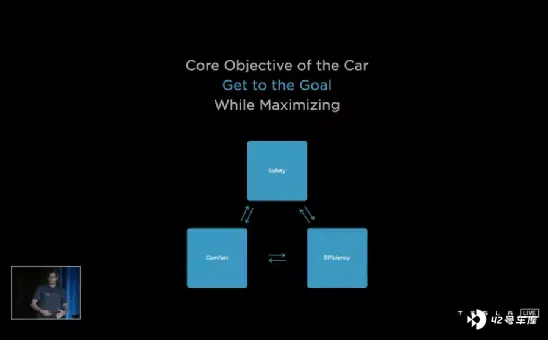
而对规划的实质,就是围绕安全、效率、舒适目标分解出各种复杂的变量(比如交通规则、横纵向加速度、与障碍物的距离、执行动作的时间等),将它们组织为一个函数,再求函数的最优解或最小值。
解这样的一个反映现实世界的函数的难点在于两点:
1、它是非凸的(Non-Convex,有多个局部最优解,但对全局最优目标来说这个解可能很糟糕,而全局最优解又很难求得)。
2、它是高维的(High-Dimensional,有很多复杂的参数生成)。这两个特性适合两种完全相反的解题思路。
特斯拉团队的方法是,将规划任务分层,先使用离散搜索筛出一条合适的 「走廊」 避免陷入局部的最小值,再用连续函数优化的方式进一步取得全局最优,画出一条平滑的路线。
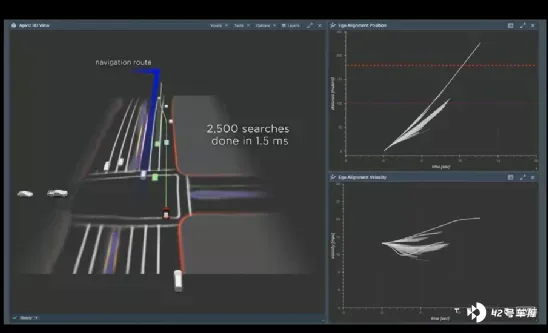
值得一提的是,特斯拉不仅会对自身的运动轨迹做规划,也会根据视野里其他车辆的运动状态,对它们的轨迹做规划和预测。这样,特斯拉在一定程度上能够掌握其他车辆的驾驶意图,从而做出更像人类司机的驾驶反应。
不过,并不是所有场景都是规则明确的。在一些非标准场景,人力很难设计出一套基于规则的、能够获得全局最优的算法。在这时,特斯拉规划与控制团队便会通过给定成本函数、输入人类操作模式、输入仿真数据等方式,让神经网络以黑盒(而不是像上面那样基于完全明确的规则)的方式找到一个启发算法,由它来指导最后的路径规划。
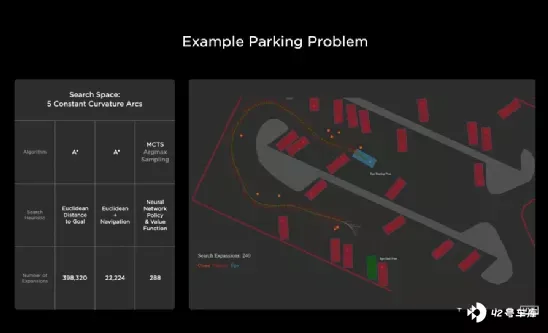
最终,在视觉识别→特征提取→基于显性规则的路径规划 / 基于神经网络的 「黑盒」 路径规划等这些漫长的流程走完了之后(实际上在计算层面可能就几十毫秒),自动驾驶汽车将会输出运动指令,自己动起来。
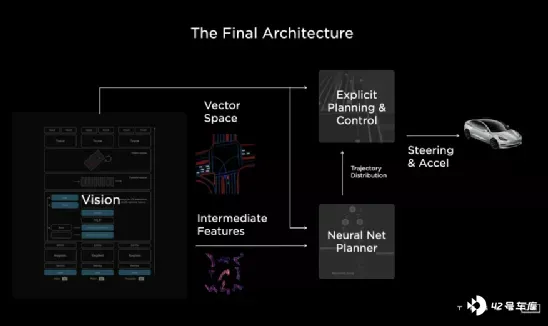
其实,从技术上来看,特斯拉基于视觉的感知与规划技术框架并没有太惊人的地方,没有造出新的轮子,只是工程创新而不是理论创新。在介绍特斯拉应对非标准场景的规划策略时,Ashok 还大方表示,这种问题完全可以采用与谷歌第二代围棋人工智能 AlphaZero 类似的技术。
但是正如安德鲁所说,要让这套纯视觉自动驾驶技术走出实验室,在复杂的现实环境中运行起来,说起来容易,做起来非常难。它看起来是个技术的大缝合,实质上则是一次又一次工程创新。
由于各家 Robotaxi 公司的落地困难,特斯拉这套新的技术框架在大规模更新到已有的车队中后,实际上会开始探索视觉智能的实际效用前沿。
不过,由于这套新的技术框架差不多今年才正式建立,特斯拉也仅向很少一部分 FSD Beta 用户进行了推送更新。加之 NHTSA(美国国家公路交通安全管理局)在 AI Day 上刚刚发起对特斯拉的自动驾驶系统事故调查,因此在短期内,用户不能指望特斯拉车型的自动驾驶能力会有指数级的增长。
但特斯拉视觉技术的进步,尤其是用摄像头取代了传统上被认为必不可少的毫米波雷达这一 「壮举」,显然为团队带来了一种正向的反馈:纯视觉路线,还有很多潜力可以挖掘。特斯拉手中,正好掌握着挖掘视觉潜力最重要的东西:数据。
让有用的数据,来得更快些
如果人工智能是一艘火箭,那么数据一定是火箭燃料 —— 它们会以极快的速度消耗。
而要喂养出一个能实现自动驾驶的人工智能,需要的数据更是天量的。所幸,依托售出车辆的影子模式,特斯拉已经收集了数十亿英里的 Autopilot 行驶数据。但这些数据并不是随手就可以用的,它们需要被 「标注」 后才能成为训练的样本,就像这样。
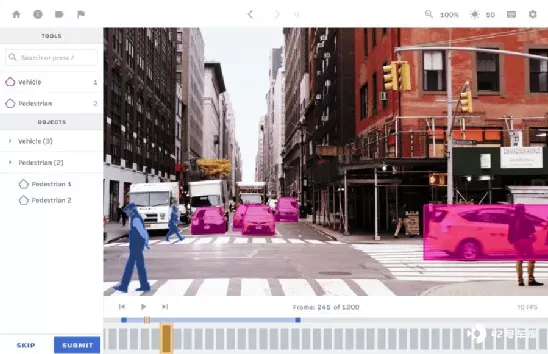
早几年,特斯拉与第三方合作,将数据标注工作外包,但发现产出的标注数据质量并不高,随后便自建、扩充自己的数据标注团队。到今天,特斯拉的数据标注团队已经达到了 1000 人。
在团队扩大的同时,应视觉神经网络的复杂化、处理信息的升维要求,团队也开发了工具,使数据标注工作从 2 维的图像可以转换到 3 维乃至 4 维的向量空间中。不过随之而来的,是数据标注工作量的进一步攀升,此时仅靠人力已经难以完成。
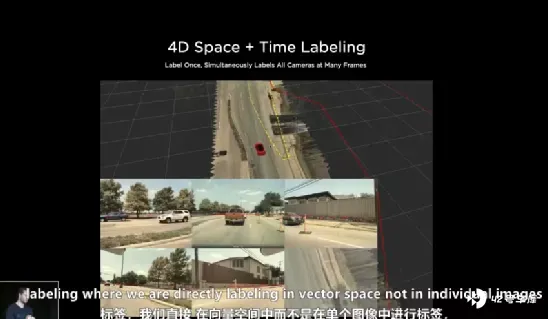
于是,特斯拉的 AI 团队开始开发自动化的标注工具。
据团队在 AI Day 上所说,他们开发的工具,使得汽车可以在行驶的时候实时地对道路、交通参与者以及障碍物等进行标注、重建。这样,不同的车辆驶过同一条道路后,他们的标注 / 重建数据汇聚到一起,就可以囊括这条道路上丰富的时空信息。
这些完整且高质量的数据集,被用于训练新的神经网络,最终带来的结果是,「只靠视觉,特斯拉比原来开得更好了」。
举个例子,在车辆移除掉雷达,前车有遮蔽物干扰的情况下,车辆仍然实现了对前车位置、距离、速度较为准确的追踪。而如果采用的是原来的算法,这种情形要应对起来则有些危险。
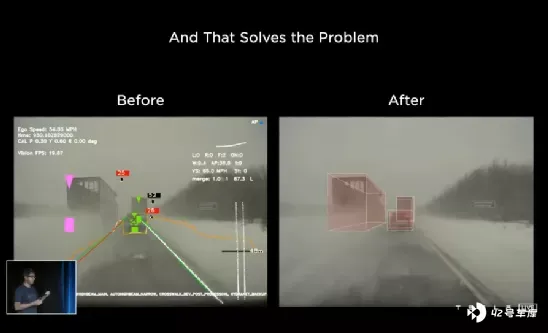
实际上,为了让新的神经网络学会处理这种情况,特斯拉收集了上万个场景类似的视频短片并进行了标注。如果依靠人力,这些工作要花几个月。但使用自动化标注工具,一周之内就完成了。
不过,即使特斯拉有大量的数据和高效的自动化标注工具,也并不意味着它们的数据够用了。现实的复杂程度超乎想象,在好些情况下,特斯拉的数据收集 / 标注自动化工具很难发挥作用,比如场景非常罕见以至于几乎收集不到(例:高速上人车狗同时飞奔),或者是场景复杂程度超过自动化工具能力(例:一条街上塞了重重叠叠的几十上百号人)。
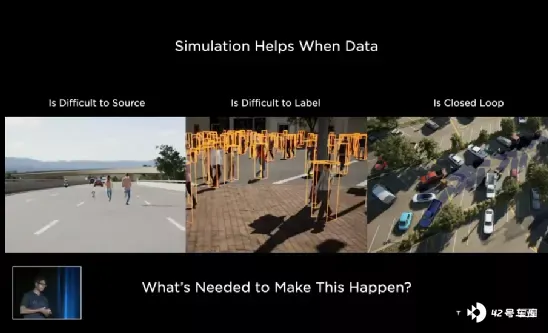
这个时候,便需要特斯拉依靠过去收集到的数据,生造出全新的、自带标注的场景以供训练 —— 这就是仿真。
根据介绍,特斯拉的仿真系统有几个特征:
1、对传感器(主要是摄像头)进行精确的仿真,甚至包括噪点、运动模糊、镜头畸变等。
2、尽可能逼真的图像渲染,使用了包括光线追踪、神经网络渲染等技术,让图像效果尽量贴合现实。
3、丰富的素材。特斯拉的仿真素材库里有上千种不同的车辆、行人和其他物体,以及人造的 2000 英里长的模拟道路。
4、更具有针对性。特斯拉的仿真库会着重记录下那些自动驾驶功能失效的现实场景,并生成几乎一样的仿真场景以供反复训练。
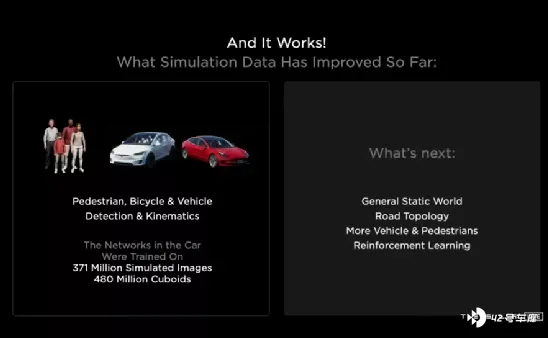
在数据量方面,特斯拉的仿真库中目前已经有 3.71 亿张仿真的图像,并带有近 5 亿个标签。接下来,特斯拉的仿真团队希望在仿真世界中加入更多的车辆行人,加入道路的拓扑结构,并在其中应用增强学习。
按照特斯拉既定的道路,要实现自动驾驶能力的不断升级,就要求持续不断的数据自动化标注,以及对神经网络的持续迭代、训练,这些都需要海量的算力。
事实上,过去数年中,特斯拉一直在扩充自己的超算集群。到 2021 年,特斯拉已经建立了三个高性能计算集群,总共由将近 1.2 万个高性能 GPU 组成,但这仍然远远不够。
最强 AI 超算 Dojo:最强之处并非算力
在去年 11 月,特斯拉的全球保有量即超过了 100 万台。而其今年的交付目标被认为是 80 万 - 90 万台。在这近 200 万台 「高质量数据生成机器」 日复一日生成的庞大数据下,特斯拉现有的计算中心,算力其实是力不从心的。
AI 超算 Dojo,正为此而生。
Dojo 项目负责人 Ganesh Venkataramanan 说,在几年之前,马斯克预见到了数据和算力需求的爆炸式增长,要求他领导这个项目。他们为 Dojo 设置了一些显性的目标:高算力、高效率、成本经济。
不过在超算领域,一直存在的一个世界级难题是:算力很容易通过加芯片堆上去,但数据传输的带宽和延迟却非常难以解决。反过来,带宽与延迟的瓶颈其实会拉低整个超算系统的计算效率,让通过暴力堆上去的算力空转。
解决掉 Dojo 的带宽与延迟瓶颈,实际上成为了超算团队的工作关键,事实上这也是团队最大的创新。
对此,超算团队的主要工作,一方面是开发各级指标合适的运算单元,让一个大规模的全局运算任务能够被分解成很多个并行的本地运算在运算单元上执行,以减少全局的数据交换(减少带宽与延迟问题);另一方面则是在组成 Dojo 的各层级上(运算单元 - 芯片 - 系统)都尽力实现高带宽与低延迟性能,防止出现木桶效应。
超算团队将最基本的运算单元,称为训练节点。一个节点的主要组成部分,包括一个 4 线程的超标量 CPU,多个 8X8 乘法矩阵,SMID 单元等。它们的共同特征是,适合进行并行运算。另一边,超算团队在这个节点的内部和四周,布满了用于数据传输的线路。
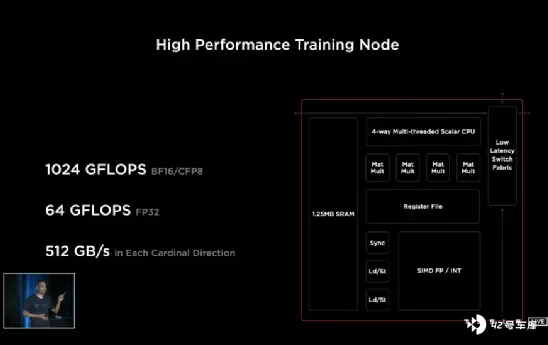
由此,仅是 Dojo 一个最小的节点,其算力在 BF16/CFP8 数据格式下就达到了 1Tflops(即每秒 1 万亿次),在精度更高的 FP32 格式下,其浮点运算性能也有 64Gflops(1Tflops=1000Gflops)。这个节点 4 条边的每一条,每秒的数据吞吐量都达到 512GB/s(作为对比,一枚 60hz 的 800 万像素高清摄像头占用的带宽为将近 2GB/s)。
354 个这样的节点连接在一起,则组合成了我们实际上能看到的超算芯片,D1。D1 芯片使用了 7nm 工艺制造,在 645 平方毫米的尺寸上内建 500 亿个晶体管,芯片内部走线就达到了 11 英里,而 TDP(满负荷功耗)达到 400W,全力工作时相当于一个小暖炉。
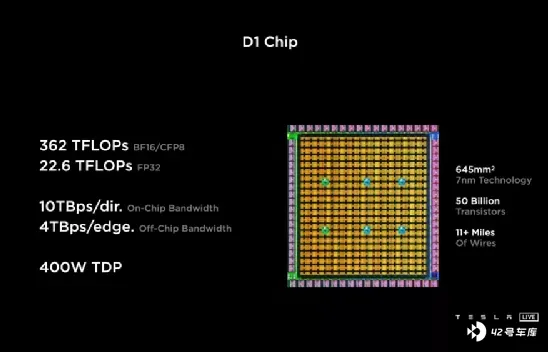
这么高的功耗,D1 到底有多能打?一枚 D1 的浮点算力,在 FP32 格式下为 22.6Tflops(英伟达目前最先进,用于 AI 计算的 A100 芯片,这一数据为 19.5Tflops),芯片每一边的带宽则为 10TB/s。在与外部进行数据传输的带宽上,D1 芯片每边也有 4TB/s 的速率,这一带宽是目前最先进网络交换芯片性能的 2 倍还多。
到开发出 D1 的环节,超算团队在芯片层面都比较好地解决了带宽与延迟的问题。但更难的一步,是把芯片凑成一个模块后,带宽与延迟问题的解决。到这一步,芯片之间的物理距离与连接方式往往决定了带宽与延迟。既然 D1 芯片有着超高的带宽,超算团队决定 「不要中间商」,用芯片直连芯片。
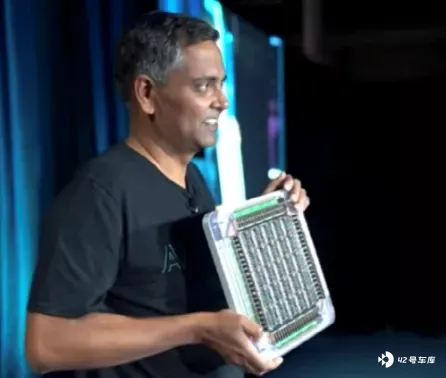
因此,特斯拉在 D1 芯片上引入了全新的 InFo-SoW(晶圆上集成扇出系统)技术,直接在一整片晶圆上刻出 25 个 D1 芯片但并不切开单独封装,从而保留它们内部的连接走线,使带宽最大化。这 25 枚连在一起的 D1 芯片,便组成了一个训练块(training tile)。在这一整个训练块上,才进一步封装上供电、冷却等模块。
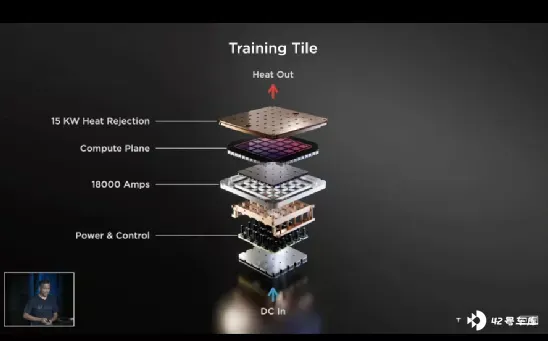
这样的一个训练块,其 BF16/CFP8 精度下的浮点算力达到惊人的 9PFlops。当然,Dojo 不可能只由一个训练块组成。因此超算团队为每个训练块开发了总带宽为 36TB/s 的连接器,既能把训练块相互组合起来,也作为它们之间的数据通道。
这一步完成后,特斯拉会将训练块们组装成最后的超算集群 Dojo。他们的计划是,将含有 3000 枚 D1 芯片的 120 个训练块,放入 10 个机柜中,并保证每枚芯片每个训练节点,都拥有高带宽与低延迟的性能。而 Dojo 最后的算力是,在 BF16 精度下为 1.1EPlops(即每秒 1.1 百亿亿次浮点运算)。
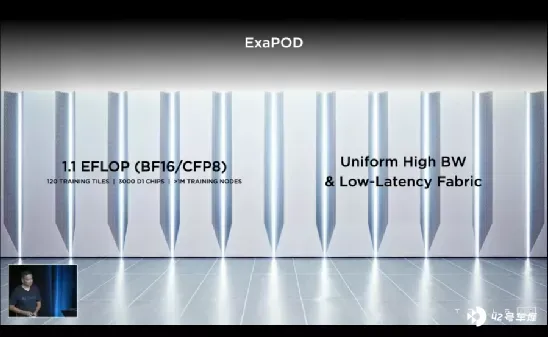
Eflops 是什么概念,其实普通人很难感知。在日常生活中,人们根本接触不到 「E」 这个数量级。举个例子,即使是人类有史以来生产的数据总量,有学者认为也不过在数百 EB 级别。
此外,超算团队还开发了特别的虚拟化工具,让 Dojo 可以在硬件调度上被切分成多台小 Dojo,以满足同时计算不同任务的需求。在硬件与软件的配合下,Dojo 无疑是一台强劲但又不失灵活的算力怪兽,在投入工作后可以极大缓解特斯拉数据爆仓的问题。
需要提到的是,有人因 Eflops 级别的算力将 Dojo 认作全球最快超算。但实际上,特斯拉在宣传这一数据时选择的是精度较低的 BF16 格式。按照精度稍高的 FP32 算,Dojo 的算力只能达到数十到近百 Pflops,比 Eflops 低了一个数量级。而目前全球最快的超级计算机 「富岳」,在精度要求更高的 FP64 下算力可以超过 600Pflops,远超完全体的 Dojo。
相较于算力,其实 Dojo 更大的特点,是同时集合了不同计算芯片的特点,在高算力与灵活性之间取得了平衡,并且解决了带宽 / 延迟问题。
当然如果限定在人工智能领域,Dojo 在组装完毕后,确实也能称得上最快的 AI 训练超算。不过,目前 Dojo 尚处于 「即将组装第一个机柜」 的阶段。使用了诸多新技术的 Dojo 也面临着一些显著的风险,比如,D1 芯片基于的 InFo-SoW 是台积电首次将这项技术投入使用,其良率爬坡需要一个过程,Dojo 实际完成组装很可能需要一段不短的时间。
One More Thing:Tesla bot,迈向通用人工智能?
自乔布斯以后,每一个让人记住的发布会,都应该有一个 one more thing。
对特斯拉的 AI Day 来说,最好的 one more thing,莫过于人们对人工智能最期待的形态 —— 机器人。
在马斯克看来,特斯拉就是全球最大的机器人公司,因为特斯拉的车实际上是跑在轮子上的半智能机器人。而自动驾驶汽车对世界的感知和认知,也可以被放到机器人上。
因此,在 AI Day 的最后,马斯克宣布,特斯拉计划明年生产一个原型机器人,Tesla Bot。它拥有 40 个运动执行单元,外形、身高、重量、速度乃至力量被设定为与普通人一致,将被用于完成危险或者无聊的重复工作。
目前尚不清楚这款机器人会不会上演特斯拉传统的跳票环节,毕竟马斯克在 AI Day 发布它的主要目的,是为这个项目招人。而机器人的运动控制,并不像汽车的底盘控制那样有一套相当成熟的体系,这意味着 Tesla Bot 的研发可能要从一些非常底层的工作做起。
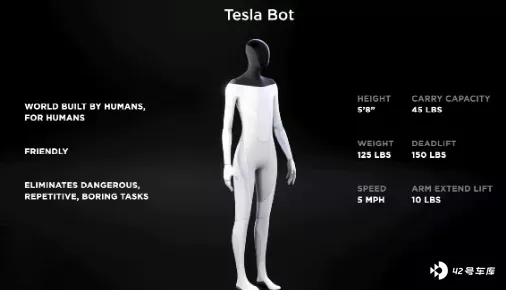
但尤其值得关注的一点是,Tesla Bot 在计算芯片(使用 FSD 芯片)、传感器(使用特斯拉 Autopilot 摄像头)、感知算法以及云端训练上,都将与特斯拉的自动驾驶汽车同源。在 PPT 上,特斯拉将自己的目标写得很明白 —— 通用机器人。
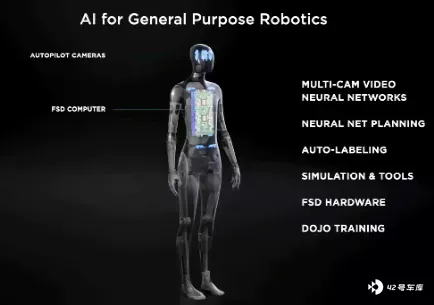
超算团队主管在介绍 Dojo 时提到的一些特性,其实也能服务于此。比如,他说 Dojo 的芯片有 「GPU 级别的算力,CPU 级别的灵活性」,Dojo 的软件虚拟化,可以支持多种训练任务同时进行。
一个数据是,人类感知、认知世界时,有 70%-80% 的数据,都是通过视觉进行处理的。这至少意味着,在 「智能」 的产生过程中,视觉占据了极其重要的地位。而特斯拉选择依靠纯视觉技术的持续升级不断向自动驾驶发起挑战,某种程度上是在复现智能的进化过程。
如今特斯拉开始将视觉技术用于研发机器人,将部分地回答一个问题 —— 通过对 「视觉智能」 的不断迭代,人类能否创造出一个通用人工智能或者说类人人工智能?
答案大概要很多年以后才能揭晓。
但 AI Day 过后,想必特斯拉在更多人心中锚定了一个观点:相比于车企,特斯拉更像一家 AI 公司。每一家车企(当然不仅仅包括车企)大概都会感到压力,被特斯拉扰动着,划出和以往截然不同的发展轨迹。