


作者 | 邱锴俊
编辑 | 章涟漪
「智己汽车已成为全国首个同时具备 L2+、L3、L4 智能驾驶量产能力的车企。」
10 月 28 日,智己汽车联席 CEO 刘涛发出如此宣言。
在当天联合 Momenta 举办的智能驾驶技术日上,刘涛罗列了 L2+、L3 和 L4 的路线图:
- 智己 L2+级高阶辅助驾驶,已于本月在全国范围内开通全系车型「无图城市 NOA」上落地;
- L3 级自动驾驶,智己入选全国首批「L3 准入及路试联合体名单」,预计将于 2026 年正式具备 L3 级自动驾驶方案的量产条件;
- L4 级自动驾驶,预计智己将在年内获得首批「L4 级无驾驶人道路测试牌照」,实现无人驾驶车率先上路。
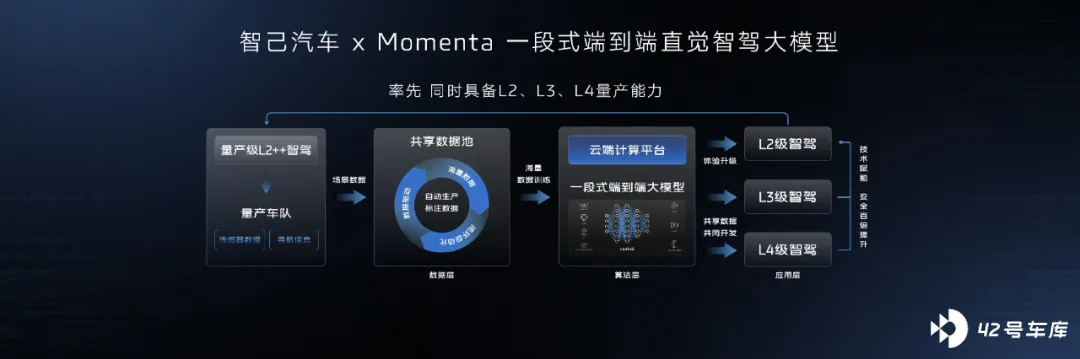
智己汽车敢于立下这样的 FLAG,底气是——基于智己汽车 & Momenta 联合打造的「一段式端到端直觉式智驾大模型」。
智己汽车在智驾研发和应用上,起步较晚,2023 年 4 月才落地首城高快领航,但今年 10 月已经在全国开通城市 NOA,现在又准备量产 L3、做无驾驶人的 L4 测试,这样的跨越式进步, 是如何发生的?
智己智驾大跨越
智己汽车成立于 2020 年底,从名称来看,就以「智能化」为标签,但在智能驾驶上,智己汽车是追赶者。
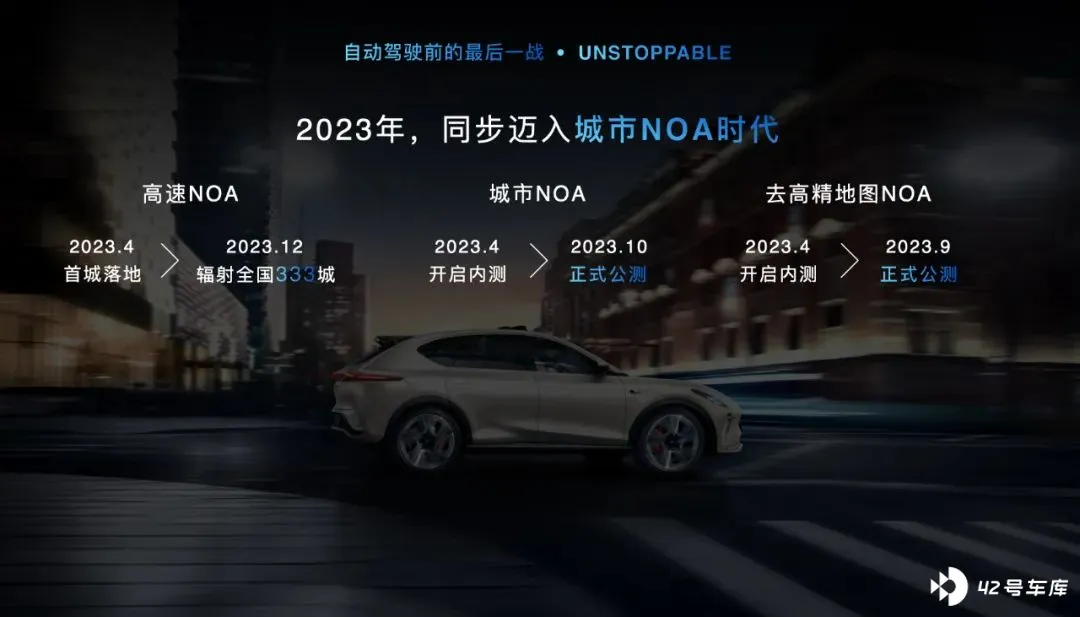
2021 年 3 月,智己与 Momenta 达成合作,开始量产 L2+级智能驾驶辅助方案。
2023 年 4 月,智己汽车的高快领航才落地。但到了今年 10 月,智己 IM AD3.0 推送,具备了全国无图城市 NOA 能力,从功能和可用范围而言,已经和华为、小鹏这样的领先集团看齐。
按智己官方介绍,IM AD3.0 实现了全国城市中「全场景都好开」,而且也能在城市狭窄街道、乡村小路、复杂环岛的全部道路使用。
不仅如此, IM AD3.0 的智驾体验,还有了更加「类人」的感觉。智己汽车称它为直觉驾驶体感,是「直觉」智驾时代的产品。
何为「直觉」智驾?
刘涛举了一些例子。
例一,在一个红绿灯路口,绿灯亮起,车辆起步,但右方车辆突然在斑马线前刹停,「如果是用逻辑来分析,前方没有障碍,同时绿灯又亮起来,我们的判断应该是可以笔直前进。」刘涛说,但经验丰富,直觉敏锐的老司机,会感觉到大概率是右前方有突发情况,继而减速再决定下一步操作。
另一个例子是,在一个占道修路的路段,对向一个车道被临时划作本方向的车道。「常规的智驾基本上是退出的,要接管,因为规则它不允许跨越实线直线。」刘涛说,但有直觉的智能驾驶,会综合分析整个路面场景,果断做出全局判断,借道行走。
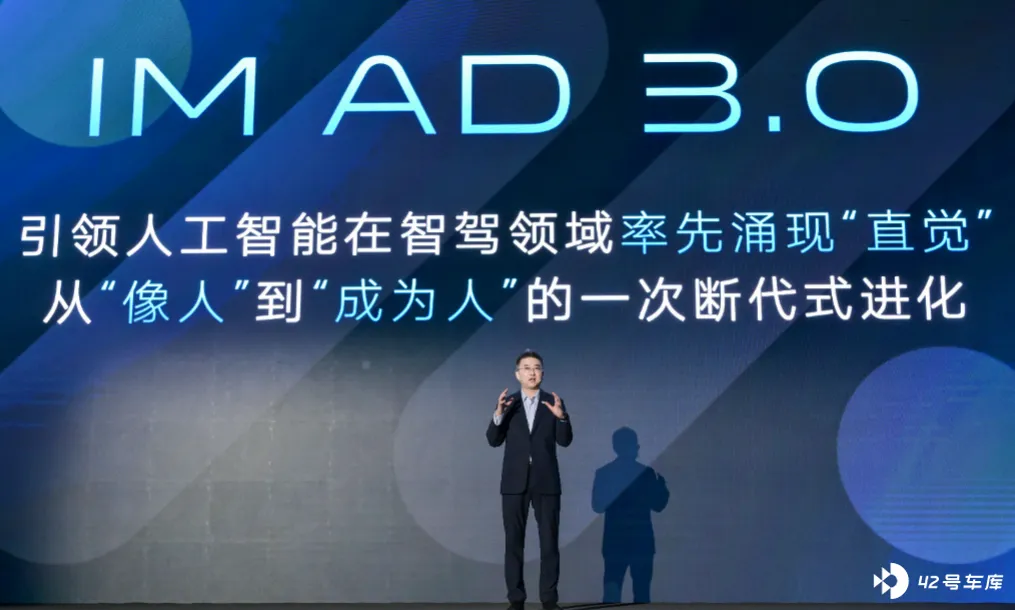
基于这些功能、范围和体验, 刘涛表示,IM AD 3.0 是一次断代式的进化,带来十年老司机的直觉驾驶体感。
跨越背后:「一站式端到端」
智己智驾的「狂飙」,决定性的一跃,发生在无图城市 NOA 这一赛段。
而智己凭借的,是和 Momenta 一起联合开发的 IM AD3.0,背后是「一段式端到端智驾大模型」。
「端到端」大模型由特斯拉首先用于智驾开发,并在特斯拉 FSD V12 版本应用之后,取得明显进步,引发智驾企业纷纷跟随。
不过,有些企业,比如华为,采用的是分段式或者分模块的「端到端」,分为感知和规划两个模块,分别进行「端到端」的模型训练,而且还有安全网络兜底。
有的企业和特斯拉一样,比如 Momenta,就直接采用「一段式」或者「单一模型」的端到端方案,从感知设备输入信号,到输出执行指令,全都由一个模型学习完成。
Momenta CEO 曹旭东也在双方联合举办的智能驾驶技术日上做了发言。
曹旭东认为,一段式端到端方案,更符合人类大脑的运行原理,「通过把感知、规划两个模型整合成一个大模型,传感器原始数据输入规划路径输出,实现人类的高级思维中的快速直觉般的反应,让自驾体验更加的人性化。」
分段式的模型问题在哪?
曹旭东认为,分模块做感知和预测,一方面很机械化,另一方面,在过程中会有很多的重要的信息出现偏差回落,使得整体智驾不能符合用户预期或者尴尬。
而单一模型,「无需人为定义感知到规划的接口,可学习全局信息、隐含信息,就算是看不清的看不到的房子、一些道路的结构或者情况,也能综合分析车流的轨迹,获得全局的隐含的信息。」
曹旭东说,「这是一种基于全面的信息输出行驶轨迹,通过理解环境、理解世界,边看边开的真正的老司机的驾驶方式。」
他举了一个例子,当路面上存在水坑时,在分段式的模型中,对水坑的识别是很困难的,因为首先是要严格定义水坑的类型,然后再大量的数据来训练感知模型并认知水坑。在训练规划的时候,当系统绕开的时候,从感知训练到规划训练,又要大量的数据和人为的操作,而且最终的车辆行为还会受限于感知的准确度。
一段式的智驾训练方式发生了本质的变化,去除了人为定义的水坑的步骤,可以通过水坑的数据直接学习人类优秀的驾驶行为,「对水坑没有显性的定义,我们的智驾大模型也可以学习到隐含的认知,并绕过水坑。」
尽管刘涛强调 IM AD3.0 是「直觉」智驾,曹旭东说是「一段式端到端」大模型,但是,双方联手开发的这一智驾方案,还是带有安全兜底的意味,和华为所说的安全网络类似。
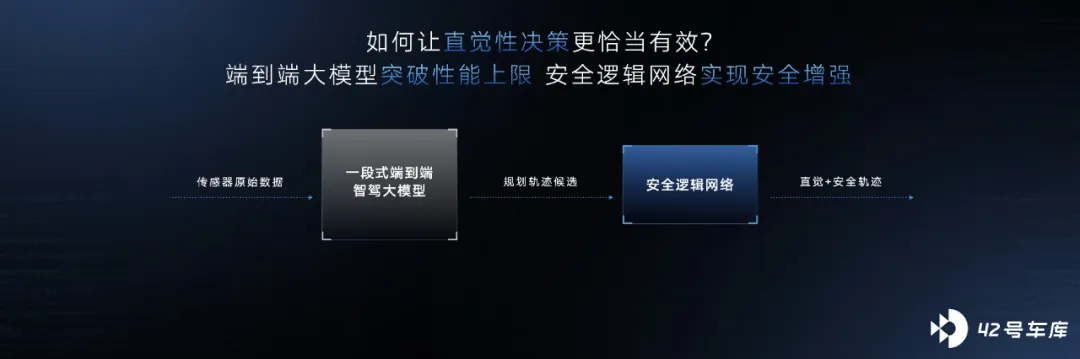
智己汽车智能驾驶项目高级总监脱悦在技术日上介绍,他们通过安全逻辑网络——也就是理性分析——来进一步提升产品的安全性,「这是我们如何让直觉性的决策,既恰当又有效的解决方案。」
对此, 笔者的感觉是,智己和 Momenta 有点滥用了「直觉」一词。本质上即便是拟人的、丝滑的处理过程,也并非来自直觉,而是大模型训练之后的经验使然。只是模型训练之后,将逻辑推理的过程内化在其中,用时更短了。
在「一段式端到端智驾大模型」的基础上,曹旭东还分享了大模型训练的一个「降本」方案。
之所以需要降本,是因为这样的训练需要大量数据和算力。
曹旭东引用马斯克的话说,特斯拉去年花了 20 亿美金建设超算中心, 今年计划用 100 亿美元训练自动驾驶 。「可以看到自动驾驶的大部分的训练,其实试错的成本是非常高的,训练一个模型可能要花百万美金甚至几百万美金,如果方法错了或者继续错了,基本上你就打水漂了。」
Momenta 采取了一个长短记忆结合的方式,来训练智驾大模型。
「它也是仿造了人类的记忆的一个过程,就是外界的大量的信息数据首先会进入短期记忆,再经过短期记忆的筛选验证,之后才会进入长期记忆,形成习得的能力和经验。」
曹旭东说,其逻辑是,「短期记忆的训练成本比较低,可以据此验证新模型是不是正确的,以及用于训练的数据是不是正确的,训练的周期也会比较短,平均一天就能迭代一个版本」。
最终,经过短期记忆被验证过的好的方法,好的数据在积累一段时间之后,再进入的「长期记忆」,这样能够保证长期记忆的训练,基本上一次训练就能训练得对。
曹旭东说,「这一长短期记忆以及合作模式,可以说是我们的一个秘密武器」,可以将模型训练量减少 10-100 倍,迭代的速度也会大幅提升。
曹旭东还表示,一段式端到端的智驾大模型,需要大量的数据进行训练,因此,海量的数据以及数据工具的自动化也是核心能力之一,更是成败的关键。
他介绍,Momenta 已经有了密集的、优质的数据积累,数据量以指数级的爆发的方式增长, 到 2027 年的时候,数据积累预计会突破 1000 亿公里,彻底解决自动驾驶的长尾问题。
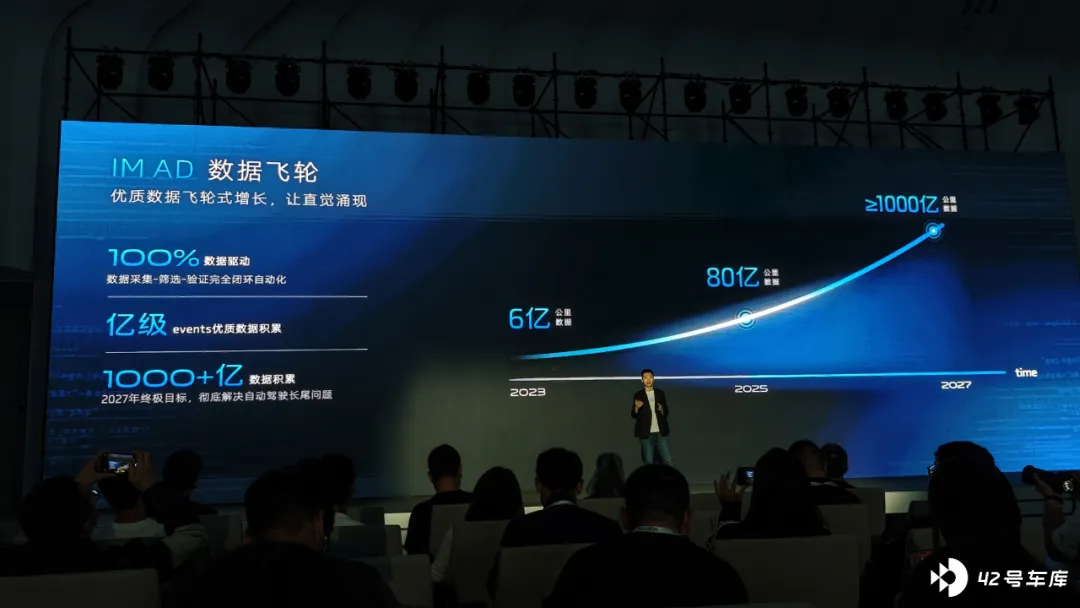
由此,曹旭东说,「我们是全球首批实现一段式端到端智驾上车的企业,我们 Momenta 将助力智己汽车成为最早实现 L3、L4 自动驾驶的品牌。」
开发全球都能开的 L2+
在智驾技术沟通会上,刘涛带来了一个「ONE MORE THING」。
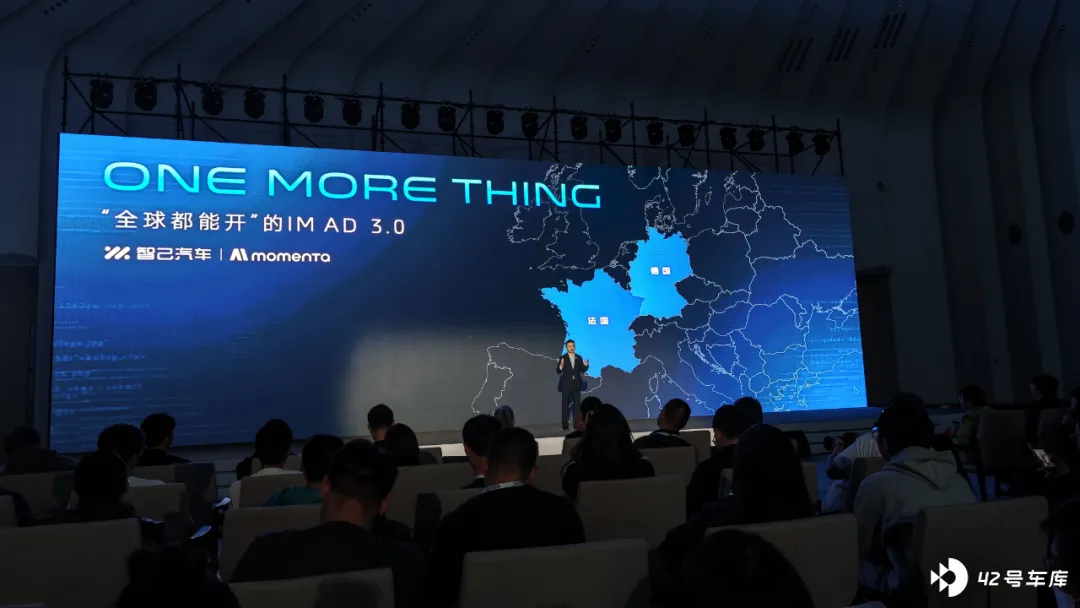
他透露, 智己汽车已经启动欧洲市场的 L2+道路测试,希望为智驾出海打造首个「全球都能开」的无图 NOA。
刘涛表示,中国已经是全球新能源汽车的创新中心,毫无疑问也将会成为全球自动驾驶创新中心。
「我们一定要在 3~5 年之内,打造自动驾驶的中国方案和中国影响力,来打赢技术上的最后之战,让世界看见中国树立智驾上的终极标准,让世界见中国,中国即世界。」


