


撰文 | 张祥威
编辑|马青竹
2024 年中,理想汽车发布名为“端到端+VLM”的双系统架构,端到端跑在一颗 Orin X 芯片上,VLM(视觉语言模型)跑在另一颗 Orin X 上。
有玩家很快叫阵。
“(双系统)是一个落后的架构,可能比新手司机会强一点。打个比方,VLM 像是让车上坐了一个教练。”
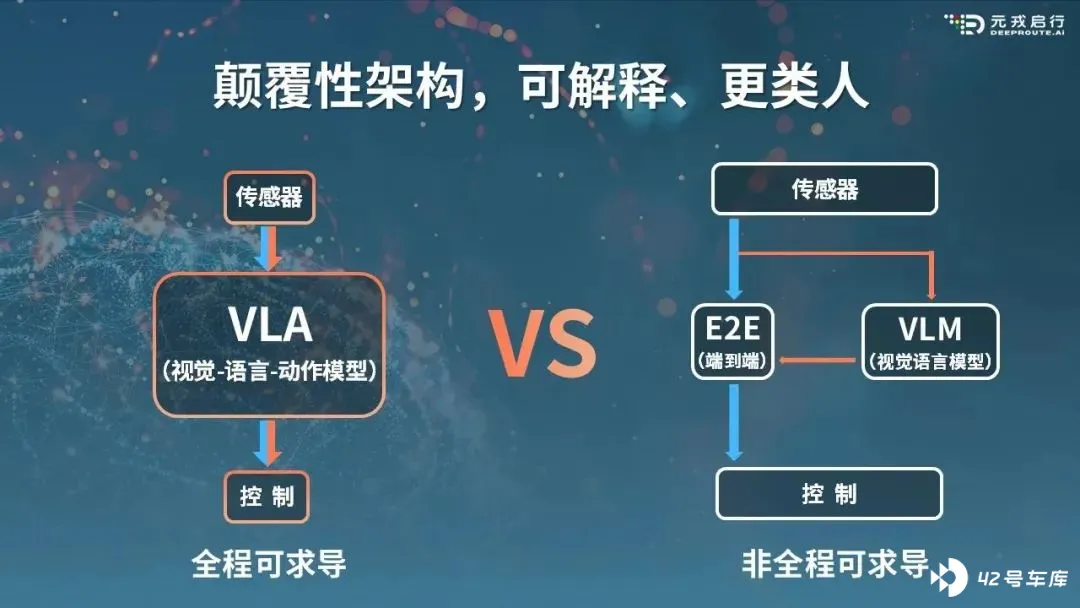
元戎启行 CEO 周光在一次分享中称。并提出另一个自认更好的模型——VLA,可以让教练直接开车的模型。
“我们现在没上 VLM,预计明年推出 VLA。”一名元戎启行内部人士告诉我们,元戎启行的智驾方案搭载在魏牌蓝山上,当前仅需一颗 Orin X 芯片。
商汤绝影 CEO 王晓刚则告诉我们,不否认 VLA 是端到端的下一代技术方向,只是不会那么快。
“端到端的发展还是要经历一个过程,包括基础设施、数据积累、数据仿真。要真正发挥它的威力,这不是一蹴而就的。”
上个月,商汤绝影抛出名为“开悟”的世界模型,可生成仿真数据,与量产实车采集的真实数据结合,共同重建物理世界。
VLM、VLA、世界模型……,概念不断涌现,代表智驾玩家的技术路线和投入重心。
据《出行百人会/AutocarMax》了解,以 VLA 为代表的技术路线,侧重车端模型,而以世界模型为代表的技术路线,侧重云端模型。
概念的另一方面,是用户购车的隐形成本。
比如,如果单颗 Orin X 可以搞定端到端 1.0 模型,那么,那些搭载两颗 Orin X 芯片的车,是否存在算力浪费?
随着下一代端到端到来,算力需求更大,各方再次争夺智驾话语权。谁在真正做事,谁又在蹭概念?车端和云端,当下与长远,究竟如何权衡?
车端,还是云端?
“未来竞争的核心在云端。”
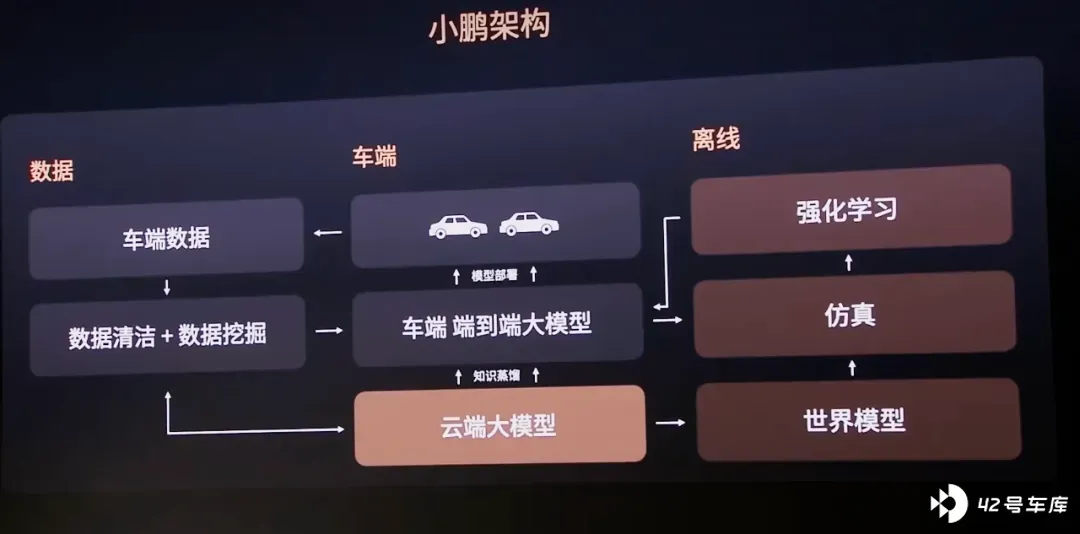
代表是小鹏汽车。大致思路:车端算力有限,所以先在云端探究更强的能力,然后在车端实现降维。
根据小鹏的架构,云端大模型通过知识蒸馏,形成车端的端到端大模型。云端大模型还被用于世界模型和数据的清洗和挖掘。
对云端的重视,也让世界模型的智驾方案供应商有了用武之地。
按照商汤绝影的“开悟”世界模型,基于商汤 20 EFLOPS 的云端算力,将能够用“实车道路采集+世界模型生成”双轮驱动,实现 Corner Case 数据生成。
云端头部智驾玩家,近一两年展开云端算力竞赛。
数据显示,去年 9 月问界 M7 改款发布会时,余承东披露华为云端算力为 1.8 EFLOPS。最新数字已经到了 7.5 EFLOPS。
今年 7 月,理想汽车公布云端算力 2.4 EFLOPS,最新数字是 5.39 EFLOPS。小鹏汽车当前云端算力 2.3 EFLOPS,预计明年达到 10 EFLOPS。
不同于重云端一派,另一派认为,应该发力车端模型。
一个代表是理想。除大力加快云端算力储备,理想已对车端模型进行布局。
今年 7 月,理想详细解释了自家端到端的做法,也就是那套“端到端+VLM”的双系统。其中,VLM 模型的参数规模为 2.2B,部署在车端芯片也就是一颗 Orin X 上,用来指导另一颗 Orin X 上的端到端模型。
理想的 VLM 模型,具备复杂场景的理解能力、读懂导航地图能力,以及交通规则的理解能力。接下来,VLM 还将用于识别交警手势、施工改道等更复杂的场景。
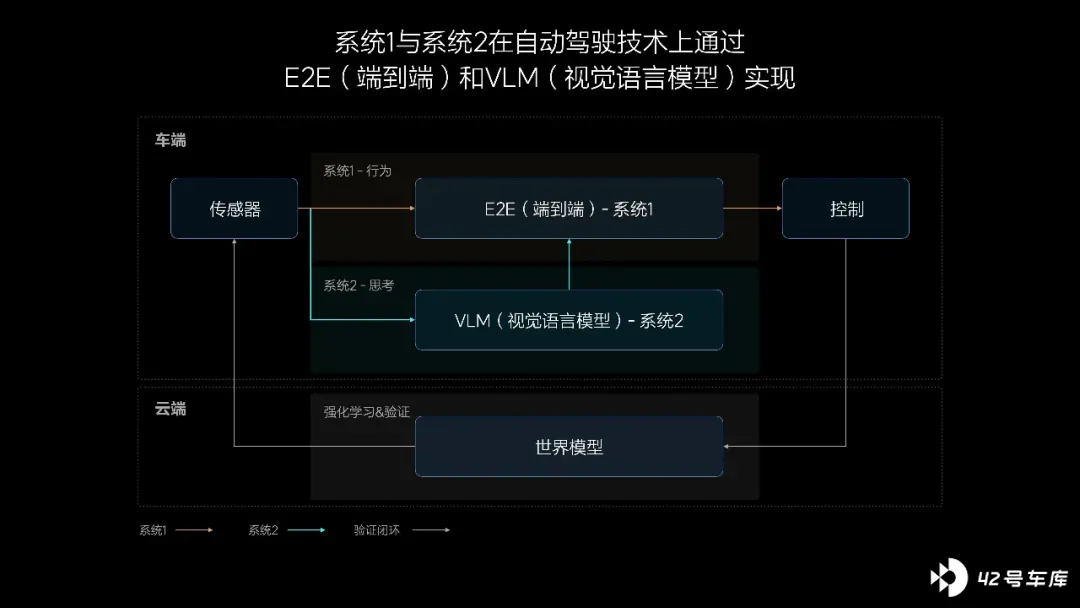
这套双系统架构,让车辆初步具备对周围物理世界的理解能力。如今,端到端+VLM 的技术路线,已经有了跟随者。
“我们明年上 VLM。Corner Case 和语义信息的解读,如可变车道这种信息,得调用 VLM 看路上信息。”一名极氪内部人士告诉《出行百人会/AutocarMax》。
在浩瀚智驾 2.0 端到端 PLUS 架构中,赫然可见“多模态大语言模型”,也正是上述极氪人士口中的 VLM,极氪采用与理想相同的双 Orin X 芯片方案。
不过,将 VLM 用于指导端到端,尤其是与端到端模型分开跑在两颗芯片上,这一做法或许并非终点。
“两个模型,资源占用方面不是最高效的方式,会降低模型效果。本质上,两个模型能够融合在一起,只不过,现在的数据还不能支撑一个模型训练好。”一名智驾供应商高管表示,“这是一个过渡阶段,将来还是会融合。”
理想智驾人士则告诉我们,“端到端的下一代,有几个方向我们都在看,VLA、世界模型以及类似特斯拉的做法,通过扩大端到端模型的体量,训练出 VLM 的早期认知能力。”
元戎启行则更加坚定看好车端模型。
其大致思路:自动驾驶端到端相当于进入 GPT2 时代,关键点在于车端模型的能力。
“车端的端到端 VLA,跟真正的大语言模型比起来是个小网络。”到了 GPT 3 时代,Scaling law 非常重要,前提依然是要有正确的架构。
2019 年, OpenAI 发布 GPT2 ,基于 transformer 的大型语言模型,包含 15 亿参数。次年, GPT3 问世,参数规模达到 1750 亿。
在周光看来,VLM 像端到端 1.0,VLA 和 VLM 最大的不同,在于时间层面的推理能力。“基于 Rule-Base,可能是 1 秒钟的推理能力。端到端 1.0(VLM)可能是 7 秒钟,VLA 可能达到几十秒。”
“VLA 部分结合了世界模型,具体多少不好描述,可以理解为跟驾驶相关的世界模型。”元戎启行技术副总裁刘轩告诉我们。
“之前做泛化测试时,遇到过一个特别离谱的路口。直行等红灯,下面竖了一块牌子:‘保持安全的情况下红灯可以直行’。就算是人类驾驶员,尤其外地人,看到这个路口肯定也懵。这些和驾驶相关的信息,需要世界模型进行理解。”
刘轩不看好重云端一派的部分做法。
“为什么不直接放在车端,难道要在云端做实时训练吗?在云端训练好的模型,不能裁剪然后塞到车上。总要测试吧,如果最终要在车端测试,为什么不直接放在车端?”
至于扩大端到端模型的体量,刘轩认为,“特斯拉具体怎么做,我们不清楚。不过对通过扩大端到端模型体量扩展出 VLM 认知这一方向表示怀疑。这有点像一个人一直练开车,有一天突然能写好文章的感觉。当然,不排除有人能做到。”
下一代端到端,影响重重
端到端向下一代进化,会带来多层冲击。
以 Orin X 为例,支持 VLM 模型已经接近极限。下一代端到端模型,适合采用更大算力的芯片,比如英伟达 Thor 芯片,其它如地平线 J6P 等国内大算力芯片,均需接受检验。
能用好更大算力芯片的智驾供应商,会在端到端之战后留在牌桌。
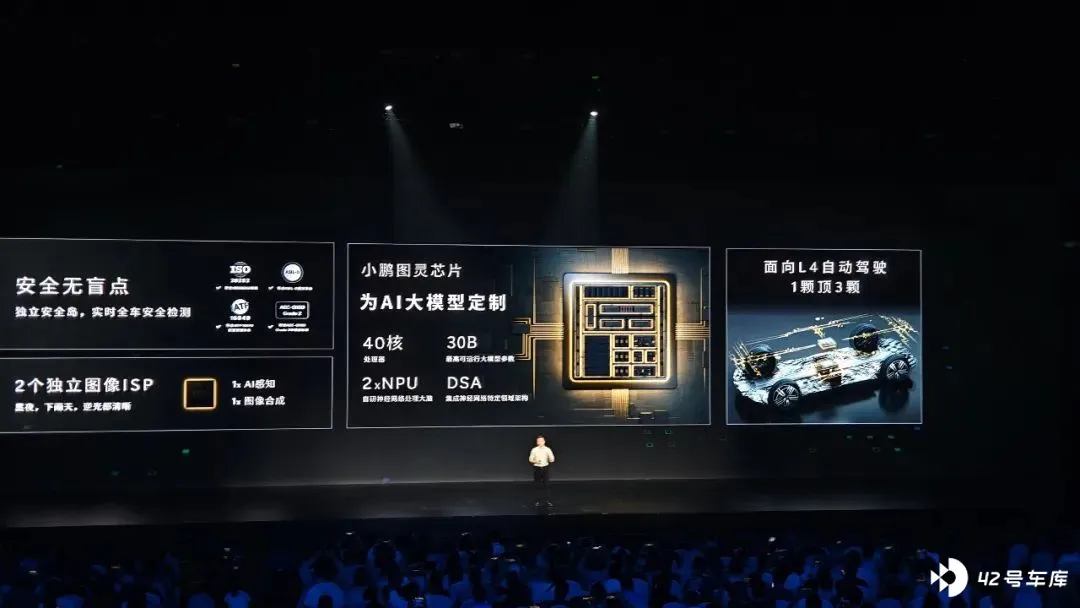
造车新势力如蔚来、小鹏自研的神玑 NX031、图灵 AI 芯片,也将很快接受检验。以小鹏图灵 AI 芯片为例,最高可运行 30B 大模型参数,更方便下一代端到端大模型的部署,云端模型的下放,理论上更加便捷。
提升车辆交付规模,也是角逐下一代端到端的要求。
周光认为,“端到端 1.0,万台规模级的车就有挺好的效果。真正做 VLA,10 万台可能是一个入门券。”
所以,下一代端到端的竞争,也要看谁能更快达到 10 万台交付规模。
Robotaxi 也会被下一代端到端影响。
上个月,Waymo 宣布最新研究成果,基于多模态大语言模型 Gemini 推出的 EMMA 模型,又称端到端多模态自动捷驾驶模型。
本质上,EMMA 被业内人士称为 VLA 模型,也是对传统 L4 的革新。基于这类下一代端到端模型,Robotaxi 完成商业闭环,或能早日实现。
大算力芯片也会让舱驾一体方案到来。这对于自动驾驶算法、座舱方案供应商的融合,提出了新挑战。
眼下,一些重云端的玩家并不能放松。
目前智驾方案中,元戎启行、Momenta 等玩家基于单颗 Orin X 芯片,小鹏、理想等则以采用双 Orin X 方案为主。
在车端,由于一个自动驾驶大模型大多只能在一颗芯片上运行,所以,那些目前在两颗 Orin X 上跑“端到端”的玩家,模型是如何部署的,是否存在算力浪费?
长远来看,元戎启行等注重车端模型的玩家,也要面临检验,即,基于 VLA 的模型部署,在数据质量、迭代效率上,能否追得上那些动辄 10E FLOPS 的重云端玩家。
总之明年,大概率又将是概念满天飞。
“小心 VLA 的偷换概念,就像现在的端到端一样。”一名造车新势力智驾人士笑道。


