


撰文 | 张祥威
编辑|马青竹
几个月前,黑芝麻智能上市,创始人兼 CEO 单记章告诉投资人,那天相当于「抵达延安」。
他还有更长远的行军计划,「2030 年在中国做到市场占有率领先,2040 年在端侧做到全球第一。」
听起来很难,英伟达就像大山挡在前面。单记章也认同,英伟达最厉害的是训练。但他希望,在端侧,黑芝麻智能是更有优势。
眼下,黑芝麻智能和英伟达的下一次交锋就要开始,华山 A2000 家族对决 Thor 系列。
交锋的背景,是一场新的芯片战将要到来。
智驾人的 2024 年非常热闹。「无图 NOA」「全国都能开」「端到端」「大模型」「去激光雷达」「车位到车位」……隔一阵儿,就搞点儿新名词。
热闹中,高阶智驾下探到 15 万元级新车,全系标配渐成趋势。
即将告别 2024,明年智驾人大概率仍不会放松,另一场 AI 大模型之战要来了。
智驾芯片供应商更不会放松,英伟达那款热门芯片 Thor 要解决设计缺陷尽快量产,几家国产智驾芯片厂的新一代产品,也来到上车关键期。更好地支持大模型,是智驾芯片接下来的重头戏。
黑芝麻智能入局大模型之战的船票 A2000 家族,在年底刚正式推出。这一专为 AI 模型设计的芯片平台,包含 A2000 Lite、A2000、A2000 Pro 三款产品,最高算力相当于 4 颗行业旗舰芯片,意味着达到上千 TOPS 的水平。
能否顺利通过大模型考验,黑芝麻智能相比对手又有哪些底牌?从 A2000 家族芯片上能窥得一斑。
自研 NPU 和 ISP,原生支持大模型
黑芝麻智能数据显示,A2000 家族的三款芯片,算力分别相当于 1 颗、2 颗和 4 颗行业旗舰芯片,不难看出,行业旗舰芯片应该指的是 Orin X。
作为对比,蔚来神玑 NX9031 相当于 4 颗,小鹏图灵 AI 芯片相当于 3 颗。
这意味着,A2000 家族的算力分别约为 250TOPS、500TOPS 和 1000TOPS。最高算力与英伟达 Thor 一致。
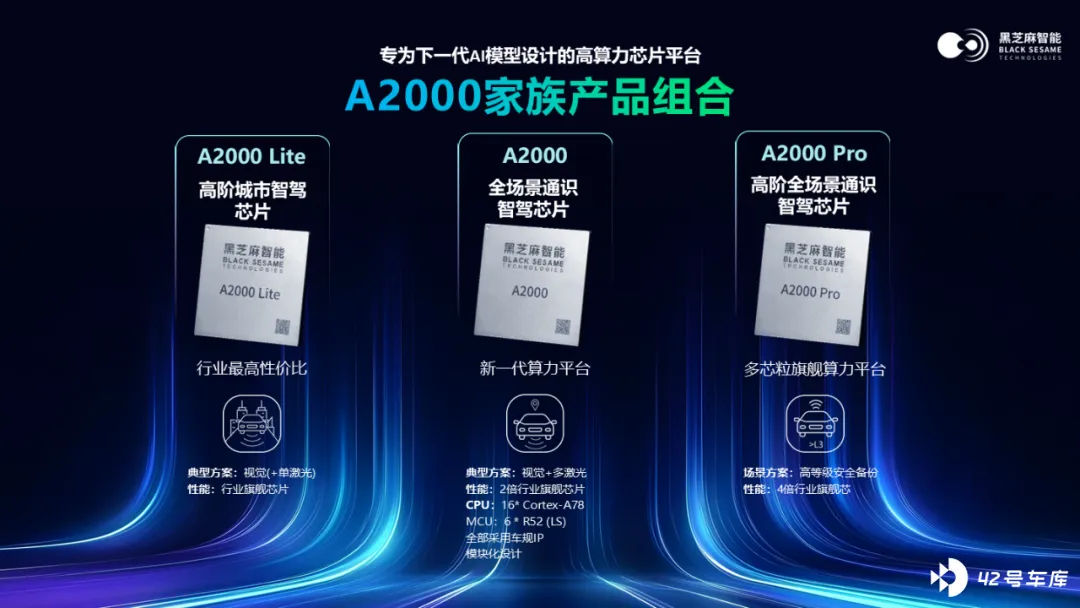
三款芯片,除面向智驾,支持实现 NOA,且可以应用于 Robotaxi,A2000 家族还支持机器人和通用推理计算等多个领域。
账面算力上,黑芝麻智能 A2000 家族是够的。挑战在于,能否适配最新的算法模型。
据《出行百人会/AutocarMax》了解,部分上一代国产智驾芯片在支持 BEV 算法时存在问题。主要由于芯片设计阶段,BEV 算法尚未提出。导致在适配 BEV 算法时,拖慢上车进度,让部分车企对国产智驾芯片产生顾虑。
此次推出 A2000 家族,黑芝麻智能表示,芯片多合一集成了 CPU、DSP、GPU、NPU、MCU、ISP 和 CV 等,单芯片能多任务处理。最重要的是,架构设计原生支持 Transformer 大模型。
拆开看,A2000 家族的 CPU 为 16 核,采用 ARM Cortex-A78 处理器。MCU 为 6 颗 ARM Cortex R52。
而核心部件 NPU 和 ISP,均为黑芝麻智能自主设计。NPU 又称神经网络处理加速器,支持卷积、矩阵乘、非线性计算等。自上一代华山 A1000 芯片,黑芝麻智能便自主设计。
此次,黑芝麻智能推出自研 NPU 新架构——「九韶」,采用独立大核架构,而非传统的小核心堆叠。
小核心堆叠是将大量小计算核集成,软件看到的是多个核。优势是容易实现,也容易获得理论算力的提升,比如单个核的算力去乘以核数量。但事实上软件要调度好这些小核的使用,达到线性的多核性能表现,几乎是不可能的,所以说只是「纸面」的理论性能提升。除了导致软件复杂外,还有额外开销大、延迟、不稳定等问题。
基于大核架构,软件只看到一个核,省去了大量核间调度的工作,开发重心可以放在算法本身,而非硬件使用上,同时,还具有实际性能高、低延时,能效高 2 倍以上等优势。缺点是芯片实现难度高。
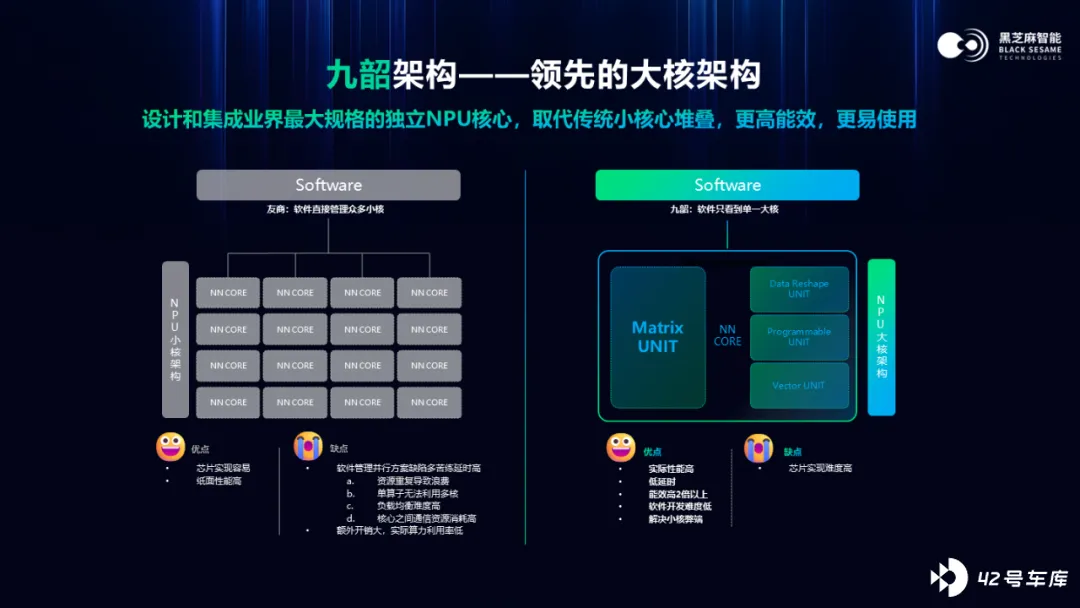
黑芝麻智能表示,大核架构能简化算法多任务并行处理的难度,支持智驾大模型的实时推理,降低计算延迟,支持优先级抢占机制,满足复杂计算任务需求。
于智驾芯片而言,这相当重要。
当下,基于英伟达 Orin X,智驾芯片支持的 VLM 模型参数可达到 2B 规模。基于下一芯片,参数规模将大幅提升。以小鹏图灵 AI 芯片为例,可支持 30B 大模型参数规模,为提升神经网络处理效率,小鹏还自研设计了 2 个 NPU。
何小鹏甚至判断,「当前量产车的算力水平在 500TOPS,未来需求水平则要达到 1 万 TOPS。」
「1 万 TOPS 有些不太现实,要考虑功耗、成本等。几千 TOPS 应该是有的,」另一智驾人士判断。
综合算力、CPU 核、NPU 架构等信息,合理推测 A2000 家族采用了制程工艺更高的 5nm,与蔚来、小鹏的自研芯片处于同一档。
不过,决定芯片水平高低的远不止账面算力等指标,还涉及开发部署便利性、安全等级等。
据悉,九韶架构支持包括 INT8/FP8/FP16 在内的混合精度计算,既可针对高精度进行精细量化,又可节省资源,提高速度,实现 Transformer 的硬加速,简化开发者的量化和部署。
九韶架构还具备高安全等级,能避免模型推理过程中的随机错误和失效,实现训练与部署一致性,确保自动驾驶系统的高安全性和确定性。
此外,九韶架构采用低延时和高吞吐的三层内存架构,包括大容量高带宽的 NPU 专用缓存、核心模块片内共享缓存,以及对称的双数据通路和专用 DMA 引擎,提升了性能和有效带宽。
通过以上设计,黑芝麻智能 A2000 在迎战大模型时,或将能与智驾算法供应商更顺利地协同,完成量产上车。
芯片制胜的其它因素:ISP、量产经验与成本
除了计算能力,其它因素同样影响着车企的判断。
其一,ISP 图像处理能力。
即便 800 万像素前视摄像头已经上车,采集回来更清晰的图片,但车企仍对智驾芯片的 ISP 有着强烈需求。
蔚来神玑 NX9031、小鹏图灵 AI 芯片,均围绕 ISP 能力进行了布局。蔚来自研 ISP 技术,小鹏采用 2 个独立图像 ISP,通过 AI 降噪算法,以及更高的处理位宽,让芯片在黑夜、逆光、雨天等暗光场景下,获得更清晰的图片数据。
自研 ISP 是华山系列研发历代产品的惯例。单记章认为,新一代 ISP 技术基于自研,让车辆看得更清更远。
据悉,A2000 家族的 ISP 具备 4 帧曝光和 150dB HDR,提升了隧道、夜间等场景的图像处理能力。能够在暗光及明暗变化环境下,更好的对镜头中的小目标物体进行探测,以及检测道路障碍物、交通标志和行人。
其二,量产经验。
「智驾方案上车不是凭空出现的能力,一定有车企前期为其买单。部分智驾供应商之所以发展不顺,还是在于缺少量产落地经验。」一位新势力智驾研发人士告诉《出行百人会/AutocarMax》。
量产验证,考验算法供应商,也考验芯片供应商。
黑芝麻智能的 A1000 芯片,在智驾上车一战中完成了量产验证,分别在领克 08 EM-P、东风奕派 eπ007、合创 V09 等车型实现量产搭载。
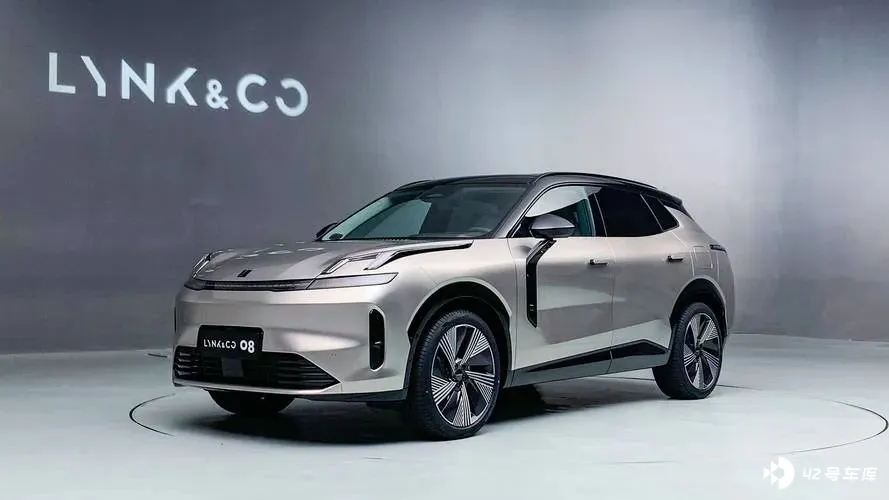
这些案例,将让黑芝麻智能积累了丰富的量产经验,跑通量产后,同时搭建成熟生态,有助于后续芯片,收缩上车适配周期。
其三,成本控制能力。
蔚来、小鹏之所以自研芯片,一方面由于市面上通用芯片的算力无法最大化利用,另一方面,也因成本过高。
「新势力自研芯片并不是特别难的事情。很多公司都是去买芯片的 IP,自己主要做软件工具链的配套。总体上,要比打造一颗通用芯片的成本少很多。」一位智驾供应商人士说。
他告诉我们,单颗英伟达 Orin X 芯片售价约 500 美金,成本约 100 美金,「卖 500 美金不是成本就那么贵,而是因为它没有对手。」
A2000 的 NPU 存算架构,不仅提升性能和有效带宽,还降低对外部存储带宽的依赖,在性能、带宽和成本间取得平衡。
黑芝麻智能提出「极限成本」,称 A2000 家族将实现 BOM 成本、导入成本和迭代成本的多重目标。
在成本维度,国产智驾芯片通常低于海外芯片,这是它们抢客户的一大优势。接下来就看黑芝麻智能们,能否赢得智驾算法研发团队的关键一票。
结语
回顾黑芝麻智能芯片历程,从华山 A500 到 A1000 系列,再到主打舱驾融合的武当 C1200,以及今天面向大模型的 A2000 家族,基本上紧贴智驾技术趋势。这相当不易。
时下,造车新势力已经上车 VLM,VLA 也很快被头部确定为下一方向。新势力自研芯片、英伟达 Thor、国产智驾芯片,明年又是一场硬仗。






