


撰文 | 张祥威
编辑|马青竹
最近,车圈两大顶流,比亚迪、小米,纷纷玩起赛车。
上海赛车场,小米 SU7 Ultra 用时 2 分 09 秒 944,打破保时捷 Taycan Turbo GT 纪录,技术高管胡峥楠捧起成绩牌,笑得灿烂。
拳打性能老师傅保时捷,小米拼的是造车工艺。
另一边,湖南株洲国际赛车场,比亚迪派出豪华跑车仰望 U9,白天、夜间各跑了一圈,夜间出场甚至甩尾亮相。
仰望 U9 在纽北曾拿过 7 分 17 秒 900 的圈速成绩,湖南那场没再公布成绩。关注点在赛道无人驾驶。
前几年,王传福批判无人驾驶,如今玩一把赛道,主要为秀实力,真正重心在「全民智驾」。当年销四五百万台的车企,举起全系标配「天神之眼」大旗,智驾广度来了。
有人做广,也有人做深。
DeepSeek 出现后,正为智能座舱、智能驾驶带来「智商」级的加持。近日,多名行业人士向笔者表达了三个观点:
DeepSeek 带来智能座舱服务的准确性;
智驾模型研发,DeepSeek 提供了许多借鉴思路;
云端算力的军备竞赛,可能会随着 DeepSeek 出现而降温。
火得一塌糊涂的 DeepSeek,放到车圈,智能座舱团队鼓掌欢迎,智能驾驶团队埋头学习。
魅力真有那么大?
集体接入智能智舱
2 月 6 日,吉利汽车宣布其自研的大模型星睿,与 DeepSeek R1 大模型完成深度融合,至此拉开车企拥抱 DeepSeek 大幕。
短短几天,动作快的车企们,将 DeepSeek R1 接入智能座舱。目前, 已有吉利、长安、长城、比亚迪、上汽大众、上汽通用、零跑等多家车企,在自家智能座舱完成 DeepSeek 的模型部署。
「我们主要用到 DeepSeek 的深度思考和推理能力,增强用户服务准确性。」一名长城汽车座舱人士告诉《出行百人会/AutocarMax》。
这种热情,前年百度文心一言发布时出现过。
彼时,岚图、红旗、长城、东风日产、爱驰、零跑、吉利汽车、海马汽车等近 10 家车企,一夜加入文心一言朋友圈。
我们了解到,此后部分车企与文心一言大模型的合作,类似地图合作的授权模式,按单车每年收取费用。
直到主打开源、免费的 DeepSeek 出现,不仅倒逼 OpenAI 反思闭源策略,也推动文心一言等国内大模型加入免费阵列。
当下,车企敞开怀抱,一边接入 DeepSeek,另一边并未放弃与文心一言,以及免费的豆包等大模型继续合作。
「开个接口的事儿,比较方便。」一名车企智能化部门人士表示。
不过,他认为,智能座舱接入 DeepSeek,噱头成分多些,「谁会没事在车里傻傻地提问。我只调戏过大模型一两次,就觉得没意思了。现在的大模型,只是起到搜索引擎 Plus 版的作用。」
不同的大模型,有所区别。
在上述座舱人士看来,DeepSeek 擅长推理,想得多且深,反应相对慢些。其它大模型如文心一言、豆包等,知识面广,C 端用户群大。车企在深度融合时,会根据产品形态做好结合。
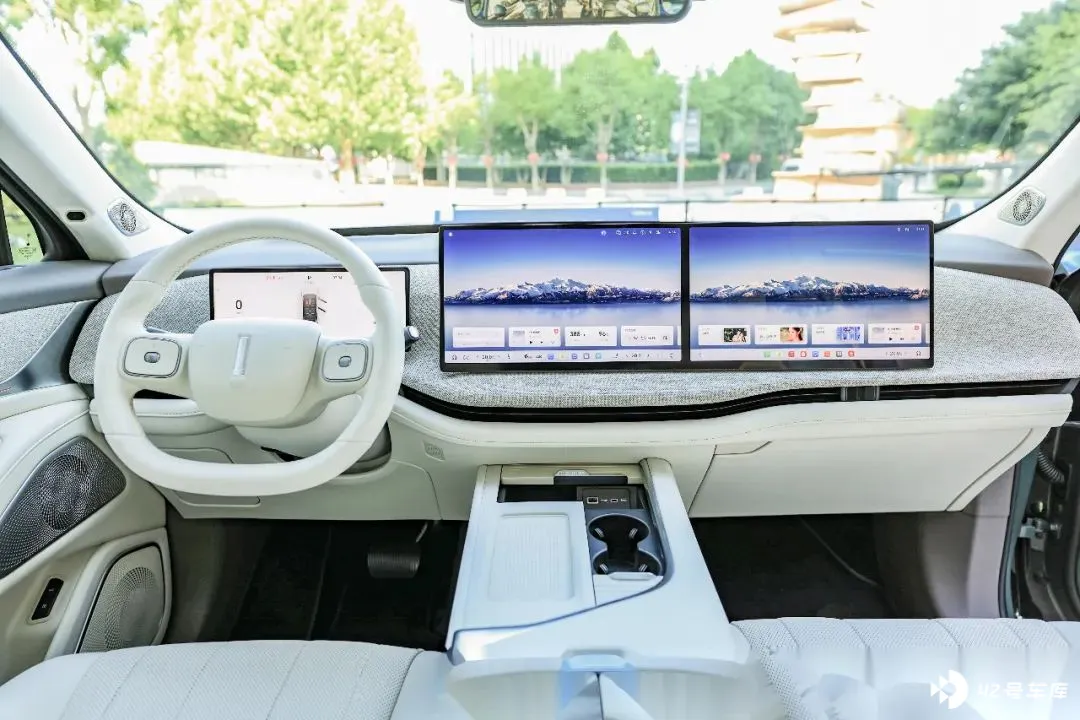
智能座舱领域,目前仅剩蔚来和小鹏 尚未明确表示接入 DeepSeek,但这已经不重要了。DeepSeek 增强了人机交互能力,乃至于谁家要自研智能座舱大模型,显得意义不大。
「这些没有意义,现在开源的 AI 足够好了。其他公司都没有必要训练自己的模型。」此前 被问到如何看待理想汽车自研大模型,并且推出了手机版的个人助手「理想同学」时,金沙江创投主管合伙人朱啸虎曾表示。
目前,理想同学的内测版 V1.2.0,已接入 DeepSeek R1 & V3 模型,支持用户体验 R1 模型深度思考、联网搜索、连续对话等能力。
DeepSeek「席卷」智能座舱,影响并未停止。
近日,吉利汽车集团与阶跃星辰联合宣布,将双方合作研发的两款阶跃 Step 系列多模态大模型向全球开发者开源。
座舱之外,智能驾驶从业者同样在被 DeepSeek 震撼,只不过,他们埋头学习。
给智驾人以启迪
「智驾不能直接接入 DeepSeek,领域不同,还得有很多工作要做。我们会借鉴它的一些思路,采用类似的技术创新方法,进行模型研发。」一名本土智驾公司生态合作高管人士透露,具体做法会找时间公布。
另一智驾公司技术高管同样表示:
「DeepSeek 中的很多思路可以借鉴。算法架构一直是我们最重要的部分,代表了人工智能的智商。很早我们就研究过 DeepSeek 的产品,并且交流过。」
至于如何借鉴 DeepSeek 的思路,上述人士又希望保密,准备稍后再揭晓。
DeepSeek 对智能驾驶的另一层影响在于,它也许会按下云端算力竞赛的慢速键。
作为推理模型,DeepSeek 有诸多技术创新之处,核心是 MoE( Mixture of Experts,混合专家网络)架构,通过自研的动态算法,帮助数据找到最适合它的「专家」,大幅降低计算量和能耗。
简单理解,基于这一算法架构,不需要那么高的训练算力,就能达到业内顶尖公司 OpenAI 性能效果。
一组数据显示,DeepSeek-R1 需要 2000 张 GPU,传统模型需要 16000 张,R1 训练成本 600 万美金,GPT-4 模型需要数十亿美金。
即显卡没对方多,靠着算法牛,最终追平性能。在数据、算法、算力三要素中,DeepSeek 证明,算法为王。
银河证券研报显示,DeepSeek 的影响在于,推动行业从 pre-training 转向 post-training 和推理,通过增加模型规模、扩展训练数据、提高计算资源以及合理的任务设计,加速模型学习更复杂的推理能力。
多名智驾供应商人士向我们表示,算法模型架构的能力先进性,比起云端训练算力更重要。
目前,投入云端算力最积极的三家,华为、理想分别达到 7.5/8.1EFlops,小鹏计划今年扩充至 10EFlops。
一位熟悉华为和理想的业内人士认为,「这几家模型能力都不太一样,理论上,理想应该利用的比较充分,华为用不了这么多算力才对,这是从算法架构反推的。」
「随着 DeepSeek 出现,车企做智驾的云端训练算力,可能不会像以前那么高了。车企有钱可以继续(囤卡),但我们不会这么干。」上述本土智驾生态高管说。
无论要大改算法架构,还是注重云端训练效率,总之,智驾人又要加班了。
结语
智驾从业者早期基于规则算法。OpenAI 的 ChatGPT 出现后,又迅速拥抱 AI。有情怀的,又在盯着 AGI 通用人工智能。
AGI 也许不远了?
虽然自动驾驶模型仍有进步空间,据上述本土智驾公司技术高管人士透露,现有的车端算力芯片,基本很难支持有明显推理能力的大模型。
「推理模型的参数下限,我们有些结果,目前还是保密状态。」
但路径依稀可见。擅长深度推理的 DeepSeek,不仅让智能座舱率先受益,更推动智能驾驶酝酿新的算法变革。
朱啸虎告诉媒体,DeepSeek 创始人梁文峰和他交流 AGI 时曾说,「意识,不过是低阶技能。」
这气势,智驾人会有吗?


