


作者 | 邱锴俊
编辑 | 章涟漪
借着端到端 +VLM 架构,理想汽车实现了在辅助驾驶上的逆袭。
尝到新技术架构甜头的理想汽车,希望更进一步,引入更新的技术架构,来夯实自己在辅助驾驶、自动驾驶领域的优势,甚至希望成为引领者。
那就是 VLA (视觉、语言、行动)大模型,理想汽车将其命名为司机大模型。
5 月 7 日晚,理想汽车举行了「理想 Al Talk 第二季 李想面对面」线上活动。理想汽车创始人、 CEO 李想再度现身讨论 AI 及 AI 在辅助驾驶、智能驾驶和汽车上的应用思路。
李想认为, 「 今天辅助驾驶的这些规则算法、端到端跟人类差距还是太大了。 」而司机大模型能力是最强的, 「 是最接近人类的,甚至有机会超过人类能力的一种 」 。
「 我自己认为 VLA(司机大模型)能够解决到全自动驾驶 。 」
李想没有透露具体的司机大模型支持的辅助驾驶系统上车时间。只是表示,比此前预计的 9 月要提前。
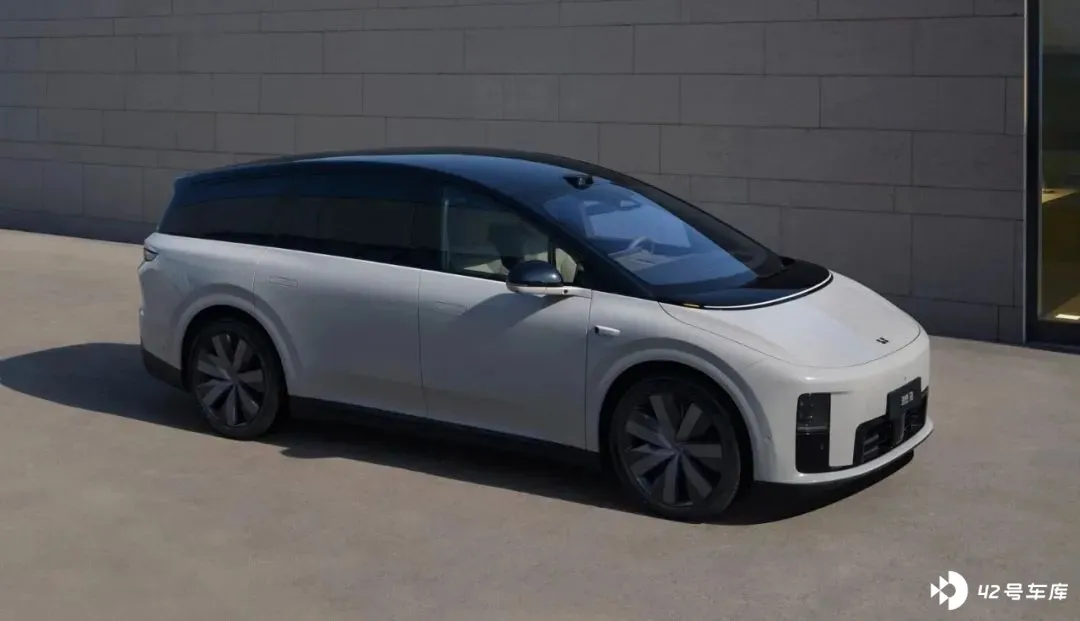
按照理想汽车透露的信息,理想纯电 SUV 理想 i8 将于 7 月发布上市,并且搭载 VLA(司机大模型)。
司机大模型有多厉害?
辅助驾驶系统发展到今天,对于行业、对于理想汽车,都可以说是一个节点。
就行业而言,由于一些饱受关注的事故影响,辅助驾驶系统的安全性受到质疑。
就理想汽车而言,尽管端到端 +VLM 双系统开行业先河,并且将理想智驾拉到行业前列,引起一些技术路线追随者,但是其辅助驾驶产品依旧是辅助工具。
本质上,这两个问题都可以归结为 ——辅助驾驶系统的能力依旧不足。
李想提及了此前规则架构、端到端架构的两个问题。
一是 对复杂东西的理解,比如复杂的修路, 「 如果是规则算法可能就会撞上了,如果是端到端可能停下来,但它不知道该怎么干了。 」
另一方面是 无法 跟人沟通。 「 今天端到端怎么做?就跟猴子一样,你影响不了它,对吧? 」
但 VLA 架构不一样。 面对复杂场景, 司机大模型能轻松解决,因为它有理解能力 。 在训练阶段, VLA 架构模型即便没有经历过真实场景的学习,也可以通过生成数据来训练。
在沟通方面,司机大模型作为 Agent (智能体) , 可以理解语言,司机可以给出指令,比如让它 一直在中间行驶,直到 下 一个 路口,再比如靠边停车,或者「到 C3 区停车」。
而且,端到端架构的系统 与导航配合出现问题时无法妥善处理, 司机大模型 却能在小区等开放空间漫游并与导航调整后汇合。
因为,司机大模型 看 得 懂导航软件运行,具备思维链和推理能力,像人类司机一样执行驾驶行动,最终 能像全职司机一样工作, 实现全自动驾驶。
司机大模型如何训练?
司机大模型为什么理解世界,听懂司机指令,并且还能成为驾驶 「专家」呢?
还要从 VLA 模型的架构特点和训练方式说起。
李想认为, VLA 架构是逐渐进化而来的,具备了很多「 像人类一样的 」能力:
- 它能 用 3D 的 vision(视觉)和 2D 的组合,去看整个真实的物理世界,也包含它能够去看懂导航软件 」 。
- 它有自己的整个脑系统,不但要看到物理世界,还能够理解这个物理世界。
- 它有它的 language(语言),然后它也有它的 CoT(思维链),有推理的一个能力。
- 它能够像人类一样的,真正地去执行这样的行动 ……
这些能力来自何处?
李想表示,司机大模型需要四个步骤来训练。
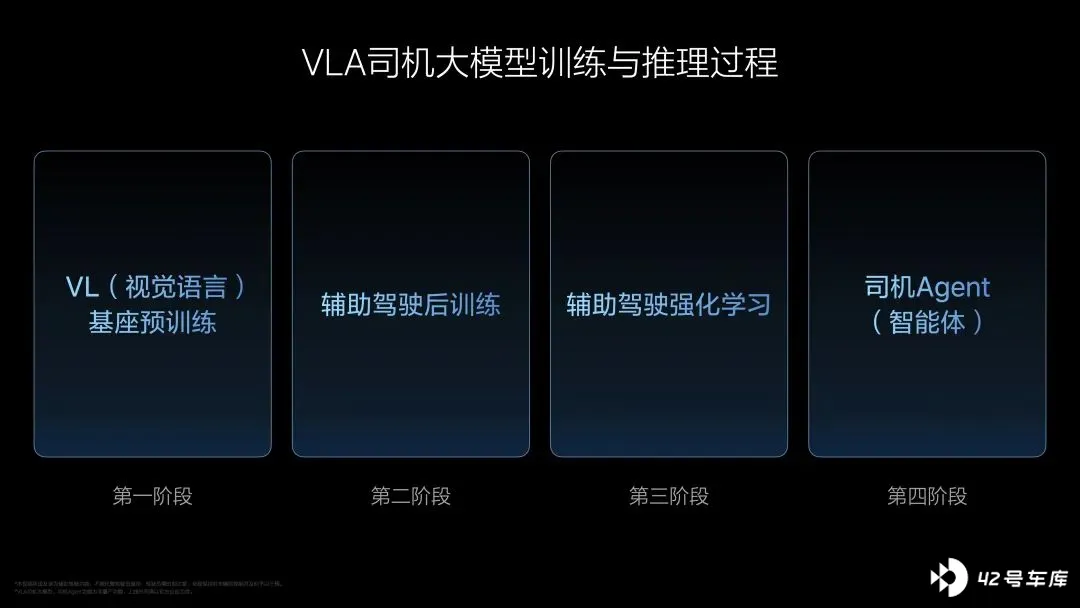
步骤一, 训练一个 VL(视觉和语言)的基座 模型 。 「 我们目前在训的,当前的这个版本,是一个 32B 的,就是 320 亿云端的一个基座模型 。 」
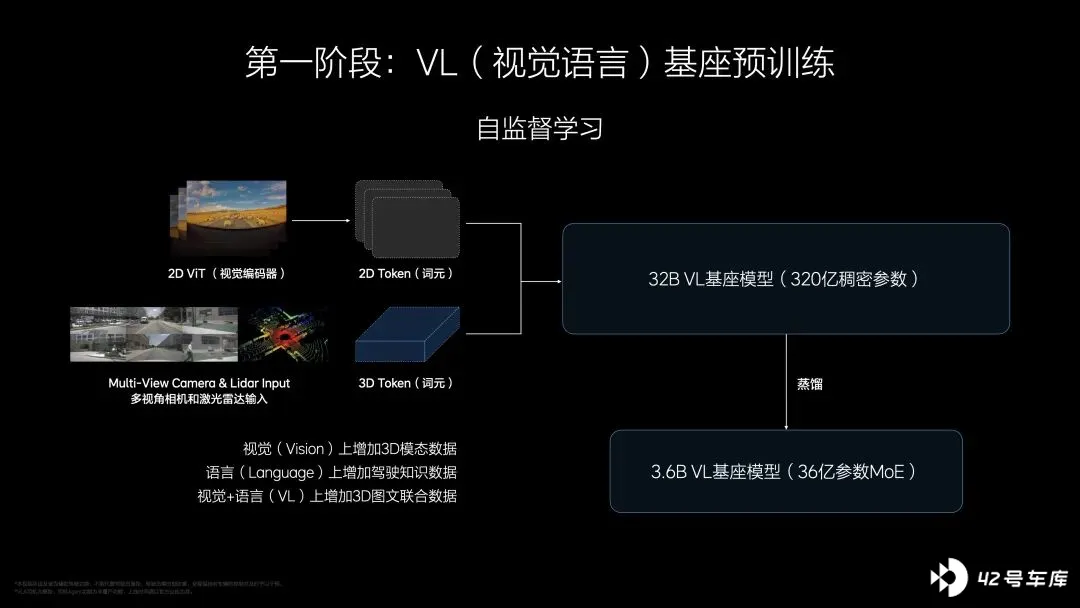
这一模型和过去的 模型的差异在于 , 要放入更多视觉的语料, 其中就包括 3D 上的视觉 语料、 高清的 2D 的视觉 语料 。 而此前的 多模态的开源 VLM(视觉语言模型)里边,2D 视觉 语料 的清晰度太低,所以看的距离不够。
在语言模型方面,要放入 跟交通、驾驶相关的足够多的这方面的语料。
此外,还 必须放入很多 VL(视觉和语言)联合的语料,就是三维图像和对世界的理解语义要同时产生的。 「 比如我举一个例子,我要把导航的地图和车辆对导航地图的理解一起放进去。 」
李想也回应了为什么要做基座模型。
他说, 理想汽车的 VLA 模型,即便是 V ( vision 视觉)和 L ( language 语言) 部分也和通用大模型不一样,需要 涉及到更专业的车领域 、 交通领域 、 面向家庭用户 的语义语料, 此外还需要 把 VL (视觉和语言)的组合语料 放进去训练。 「 那这些无论是 OpenAI 还是 DeepSeek ,它都没有这样的数据,它 们 也没有这样的场景和需求,也不去解决这样的问题,那只能我自己来做了。 」
他也强调, DeepSeek 的 开源加速了理想基座大模型的开发进度。 「 好处是说 VLA (视觉语言行动模型)里边的这个 language (语言),我可以站在巨人的肩膀上,但是它只是我其中的一部分。 」
李想在这里透露, 理想汽车把 基座模型的团队 从智驾系统开发团队拆开, 并且加大了投入, 「 训练卡比 团队 的预期应该多买了 3 倍。 」
这一基座模型训练出来之后,需要 蒸馏成一个 3.6B (即 36 亿) 端侧 (即上车) 的蒸馏模型。 「 因为我要保证它运行速度足够得快,然后无论是两个 Orin-X 还是 Thor-U 上能够流畅地运行。 」
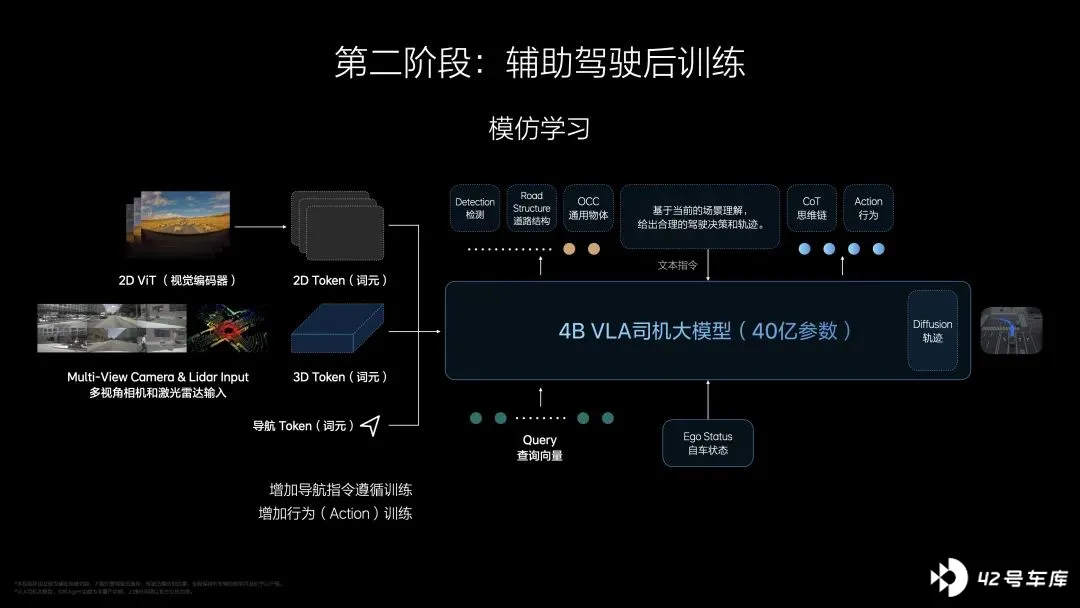
步骤 二 是做后训练 , 要把 action(行动)放进来 , 从 VL 模型变成 VLA 模型, 仍然是一种模仿学习。 「 特别像你去驾校学开车 …… 这个时候大概模型规模就会从 3.2B 大概扩大到接近 4B,大概这么一个规模。 」
步骤三 是强化训练, 「 比较像人到社会上开车了 」 。 强化 学习一部分 先做 RLHF(基于人类反馈的强化学习), 包括人类接管的反馈 。 强化学习另一个 部分是纯粹的 RL(强化学习), 「 是(拿 RL 模型放到)我们的世界模型来做训练。这块儿的目的什么呢?就是开得比人类更好。 」
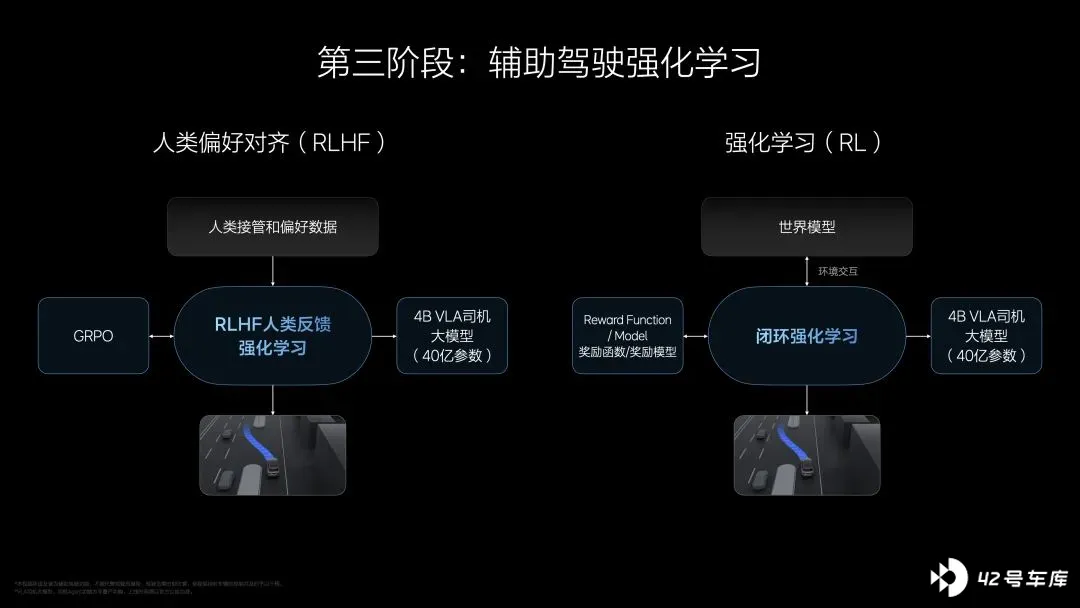
当这三个步骤完成了以后, VLA(司机大模型)能够跑在车端的模型其实就产生了。
步骤四, 搭建一个司机的 Agent(智能体) ,能够听懂司机的语音指令。 「 如果是一些短指令,通用的短指令 VLA(司机大模型)直接就处理了,不需要再经过云端。如果是一些复杂的指令,其实先要到云端的 32B 那里,VL(视觉和语言)处理完以后,(因为它理解交通的一切),整个交给 VLA(司机大模型)来进行处理,大概这么运行的一个过程。 」
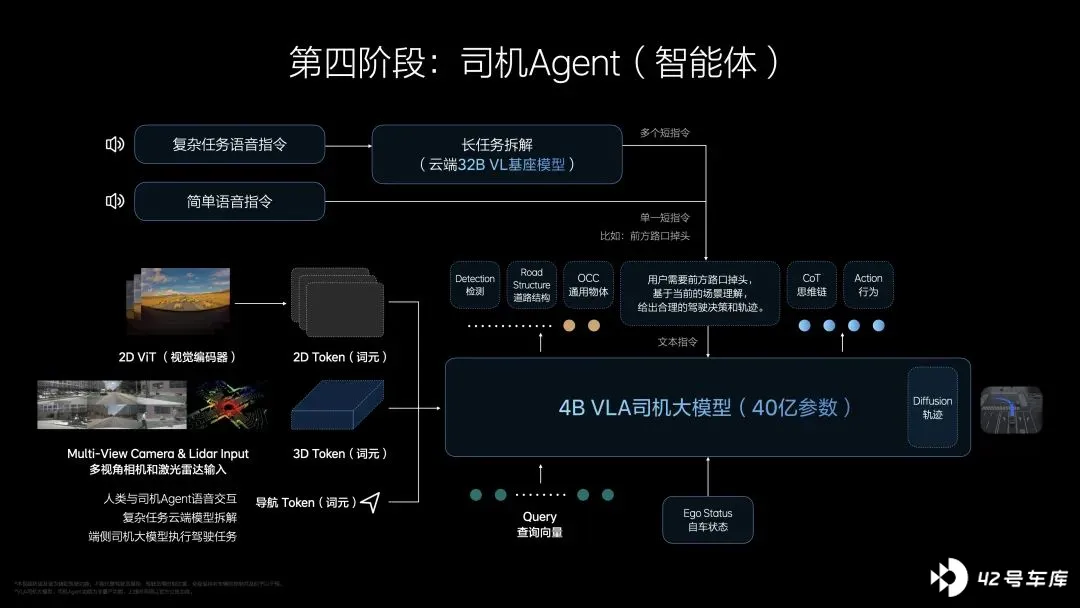
最终,李想认为, 「 说白了它最后的一个好处是说它能够像人类司机一样去理解物理世界,能够像人类司机一样去开车,去处理复杂的问题,也能像人类司机一样跟其他人类进行沟通。这是最后我们交付到用户那里的产品。 」
还有没有更强的架构?
自特斯拉引入端到端技术架构之后,探索智能驾驶辅助系统的企业,纷纷模仿。
但是,特斯拉不再举办 AI DAY 之后,业界无法再跟随。此后,理想汽车提出了端到端+VLM 的双系统架构,被一些企业学习模仿。
再往后呢?
在机器人领域, VLA 架构被广泛讨论。和智能驾驶辅助领域,理想汽车和元戎启行都提出 VLA 作为下一代架构。
李想认为, 交通领域应该是 VLA 最早实现 应用的 。
第一, 因为 交通 规则清楚, 虽然 复杂但具备确定性。
第二 , 车有三个 方向的 自由度 需要控制,而 机器人的上来就是 40 多个自由度,那个挑战就更大了。
第三 ,在交通领域 还能做特别好的强化 , 「 大家在使用的过程中不满意的时候就接管了 」。
理想汽车自从自研智能驾驶辅助系统以来,已经迭代了数个技术架构。会不会明年又换一个?
李想表示, 司机大模型 是能力最强的架构 , 能解决到全自动驾驶,但 是, 不一定是效率最高的架构。 VLA 基于 Transformer,而 Transformer 架构不一定是效率最高的,未来大概率会出现更高效的架构,因为当前 VLA 对算力要求较高。
未来还没来, 当前社会和行业对于辅助驾驶有不少负面评价,李想说, 「 比较像黎明前的黑暗吧。我觉得黎明马上就要来了。 」


