

全文约 7,900 字,建议收藏阅读
作者 | 直观解
一、 CAN 总线介绍和车辆中的作用
CAN ( Controller Area Network )总线是一种高效、可靠的串行通信协议。它采用多主竞争式总线结构,支持多节点同时发送数据,能自动仲裁优先级,避免数据冲突。 CAN 总线使用差分信号传输,抗干扰能力强,传输距离远,最高可达 1Mbps 速率。
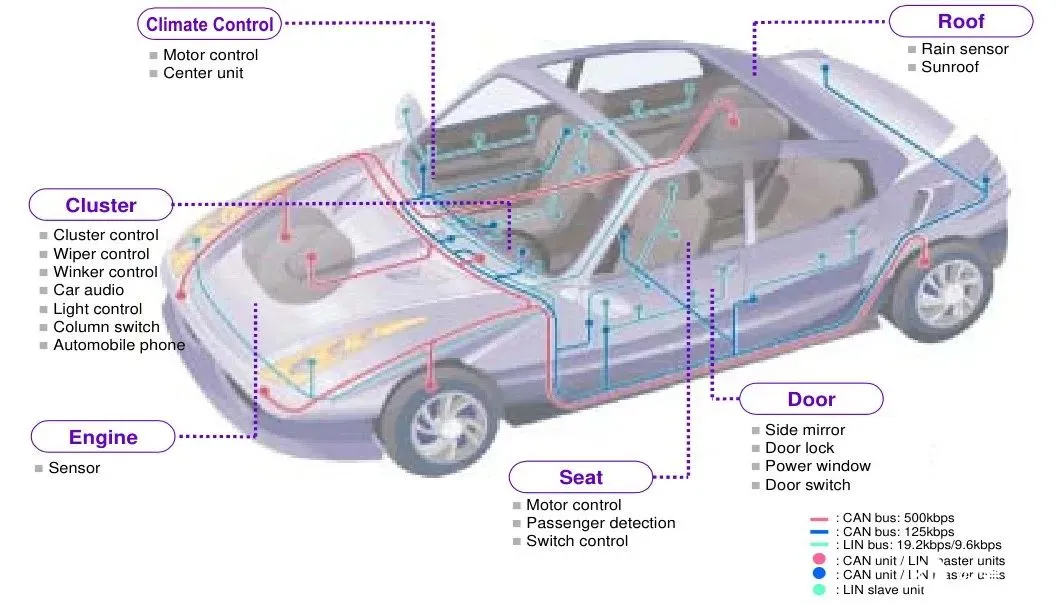
在车辆中, CAN 总线如同 “ 神经中枢 ” ,将发动机控制单元、 ABS 系统、仪表盘、娱乐系统等多个电子控制单元( ECU )连接起来。它减少了车辆线束数量,降低成本和故障率。通过 CAN 总线,各 ECU 间可快速交换数据,比如发动机转速、车速、刹车信号等信息,让车辆各系统协同工作,提升驾驶安全性与舒适性。此外, CAN 总线还支持故障诊断,方便维修人员快速定位问题,保障车辆稳定运行。
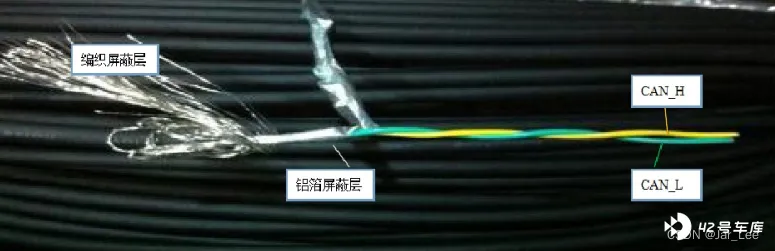
通信时, CAN 总线以帧为单位传输数据,常见帧类型包括数据帧、远程帧等,数据帧携带实际数据,远程帧用于请求数据。总线通过差分信号工作,两根数据线( CAN_H 和 CAN_L )的电压差表示逻辑 “0” 或 “1” ,当差值大于 2V 为显性电平(逻辑 0 ),小于 0.5V 为隐性电平(逻辑 1 )。
所谓差分信号传输是一种利用两根信号线(通常称为正信号线( CAN_H )和负信号线( CAN_L ))传输信号的技术,通过两根线的电压差(即 “ 差分电压 ” )来表示逻辑状态。这种传输方式在 CAN 总线中被广泛使用,是其抗干扰能力强、传输距离远的核心技术之一。
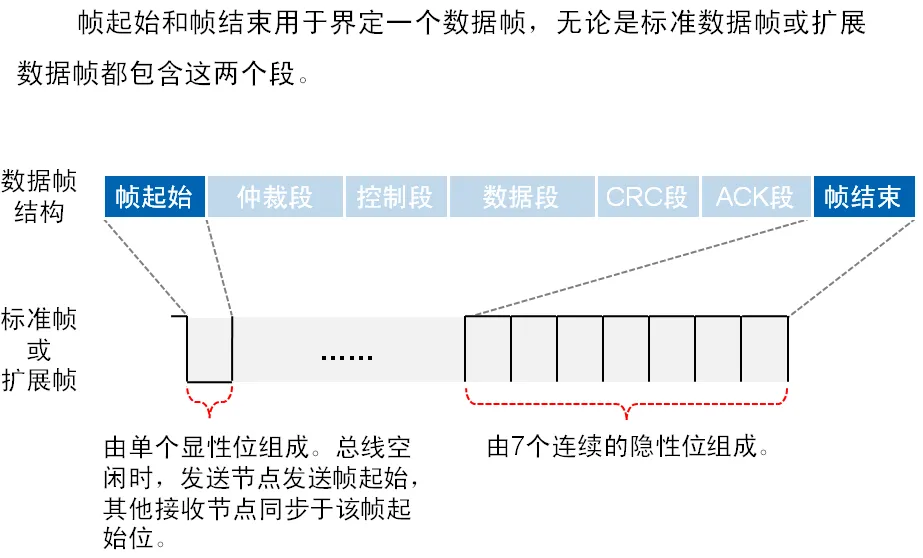
CAN 总线具备错误检测与自动重发机制,节点接收数据时,通过循环冗余校验( CRC )等方式检测错误,一旦发现错误,立即发送错误帧,要求发送节点重新传输数据,保障数据准确可靠。
CAN 总线不是传统意义上的广播模式,而是一种多主节点的总线式通信方式,其数据传输特性与广播有相似性,但机制不同。
CAN 总线的通信特点:多主节点,数据广播式发送
发送方式类似广播:
当某个节点向 CAN 总线发送数据时,总线上的所有其他节点都会接收到该数据,这一点与广播(单发送端、多接收端)类似。
例如:发动机控制单元( ECU )发送 “ 转速数据 ” 时,仪表盘、变速箱 ECU 等节点都会收到该信息。
CAN 总线支持多主节点竞争式发送 —— 任意节点都可以主动发送数据,且发送的数据会被所有节点监听。因此,它更像是 “ 多对多 ” 的共享总线通信,而非单一发送端的广播。
但存在与广播的核心区别:仲裁机制与接收选择性
( 1 )仲裁机制避免冲突
传统广播无需处理发送冲突(单发送端),但 CAN 总线允许多个节点同时发送数据,因此引入了非破坏性仲裁机制:每个数据帧包含标识符( ID ), ID 越小优先级越高。
当多个节点同时发送时,总线会逐位比较 ID ,优先级低的节点自动停止发送,高优先级节点继续传输,确保数据不冲突。
( 2 )接收端可选择性过滤数据
传统广播的接收端只能被动接收所有数据,而 CAN 节点通过验收滤波器( Filter )选择性接收所需数据:每个节点预先设置过滤规则(如只接收特定 ID 的数据),不符合规则的数据会被直接丢弃。
例如:仪表盘只关心车速、转速等数据,会过滤掉与自身无关的发动机故障码信息。
CAN 总线本身是基于有线(双绞线)的通信协议,设计初衷是通过物理线缆实现可靠的近距离通信(如车辆内部)。在实际应用中,如果实在要无线扩展,可通过无线通信技术扩展,实现 “ 类 CAN” 的无线数据传输,具体实现方式和特点如下:
通过有线接口(如 CAN 收发器)连接传统 CAN 总线,再通过无线模块(如蓝牙、 Wi-Fi 、 Zigbee 、 LoRa 等)将数据转换为无线信号传输。例如:在工业设备中,用蓝牙模块将 CAN 数据转发至手机或云端,实现无线监控。这种无线扩展本质只是用无线连接代替了中间一段实物双绞线来连接。
理解 CAN 总线的基本性质,是什么和不是什么,才能有效理解对 CAN 线入侵的防御。
二、 如何侵入 CAN 线:攻击模式和防御对策
CAN 在多数形态下是物理有线的,看起来似乎是不太容易入侵的,因为没有物理接口,特别是在车辆运动时,更不能在上面插接口。但实际上有多种入侵方式,枚举如下:
物理层攻击
1. 直接接入攻击
方式:通过物理接触 CAN 总线(如 OBD-II 接口、线束),连接自制设备注入伪造数据帧。
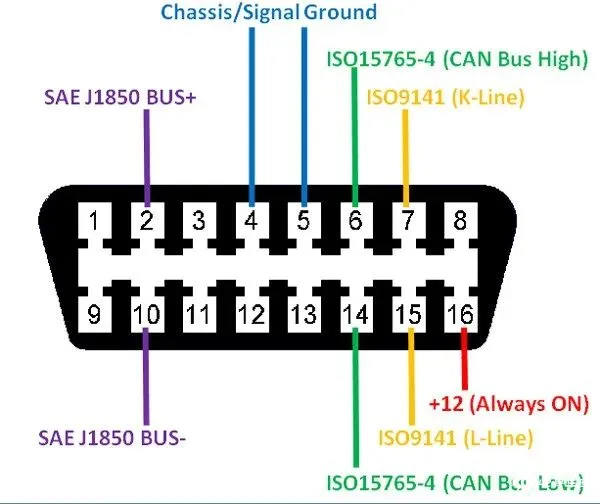
案例: 2015 年安全研究员 Charlie Miller 和 Chris Valasek 远程入侵 Jeep Cherokee ,通过篡改 CAN 数据控制车辆转向、刹车。防御:物理隔离:限制 OBD-II 接口访问(如加装机械锁、车辆停放时断开连接)。
硬件加密: 使用带硬件加密的 CAN 收发器(如 NXP SJA1000T/3 ),对数据帧进行加密认证。
电磁干扰(EMI)
方式:通过强电磁辐射干扰 CAN 总线的差分信号传输,导致数据错误或节点异常。防御:屏蔽线缆:使用双层屏蔽 CAN 专用线缆,降低外部电磁干扰。
共模扼流圈: 在线路中加入共模扼流圈,抑制共模干扰信号。这个主要是硬件方案防御。
数据链路层攻击
1. 伪造数据帧
方式:攻击者伪装成合法节点,发送伪造的高优先级数据帧(如加速、刹车指令)。防御:消息认证码( MAC ):对每个 CAN 帧附加 MAC ,接收端验证签名后才处理数据。
动态 ID 分配:定期更换 CAN 帧的标识符( ID ),增加攻击难度。
2. 拒绝服务( DoS )攻击(也就是互联网说的洪水攻击,用垃圾信息淹没有效信息)
方式:通过持续发送低优先级帧或错误帧,阻塞总线带宽,导致合法通信中断。防御:错误计数器监控:节点检测到连续错误时自动进入 “ 总线关闭 ” 状态,防止 DoS 攻击扩散。
流量整形:限制单个节点的发送频率,确保关键信号优先传输。
这种攻击的关键是攻击者如何伪装成合法节点?如果不能物理接触和物理改造车辆的话。
其实主要还是基于无线的远程攻击。
攻击者即使 无法物理接触车辆 ,仍可通过 远程或间接手段 伪装成合法 ECU 节点,以下 是具体攻击路径和方式:
通过车载无线接口入侵
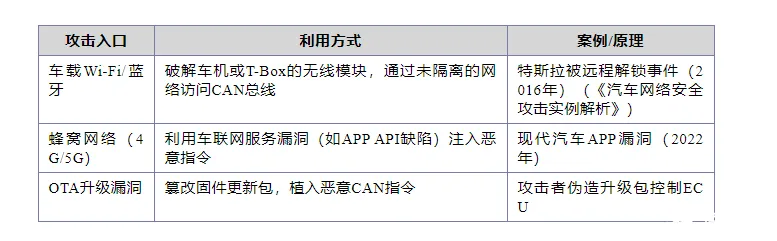
中继攻击( Relay Attack )
原理:通过信号中继放大钥匙扣的 RFID 信号,欺骗车辆认为钥匙在附近,从而解锁并启动车辆。
工具:使用低成本设备(如 HackRF 、 Proxmark )在数米外中继信号。
典型攻击链如下:
攻击者 ->> 车载 Wi-Fi: 破解弱密码
车载 Wi-Fi->> 网关 : 绕过防火墙
网关 ->>CAN 总线 : 注入伪造报文( ID=0x2E0 )
CAN 总线 ->> 引擎 ECU: 执行恶意指令(如熄火)
应用层攻击
1. 诊断服务滥用
方式:利用 UDS (统一诊断服务)协议的漏洞,通过 OBD-II 接口发送恶意诊断命令(如重置 ECU 、读取密钥)。防御:诊断服务限制:仅在维修模式下启用完整诊断功能,正常运行时禁用高危命令(如 0x10 服务)。
会话认证:诊断会话需双向认证(如挑战 - 响应机制)。
2. 固件漏洞利用
方式:通过 CAN 总线向 ECU 发送恶意固件更新包,植入后门程序。防御:固件签名验证: ECU 仅接受经过数字签名的合法固件更新。
空中下载( OTA )安全: OTA 通道需加密(如 TLS 1.3 )和完整性校验。
网络层攻击
1. 跨网段攻击
方式:现代车辆通过网关连接多个 CAN 网段(如动力 CAN 、舒适 CAN ),攻击者突破某网段后横向移动。
防御:域隔离:不同安全级别的网段(如动力系统与娱乐系统)通过防火墙隔离。
消息过滤:网关仅转发授权的 CAN 帧类型,阻止非法跨网段通信。
2. 远程攻击链
方式:通过车载 Wi-Fi 、蓝牙或蜂窝网络(如 4G/5G )入侵 T-BOX ,再渗透到 CAN 总线。防御:纵深防御:车载网络与外部网络之间部署入侵检测系统( IDS )。
关键 ECU 采用 “ 白名单 ” 机制,仅允许已知 ID 和格式的帧通过。虽然会拖慢速度,但安全第一。
现在主要的防御方式是结合规则和 ML 。
基于规则的 CAN 总线异常检测技术通过预定义逻辑或协议规范来识别异常行为,具有高实时性和低计算开销的特点,适合车载嵌入式环境部署。以下是其核心方法与应用场景的详细分析:
规则检测的 核心维 度
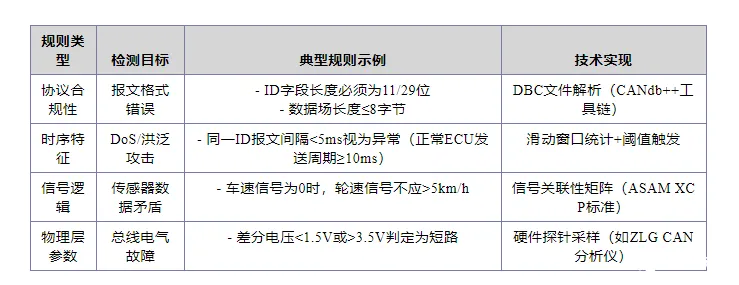
典型技术方案对比
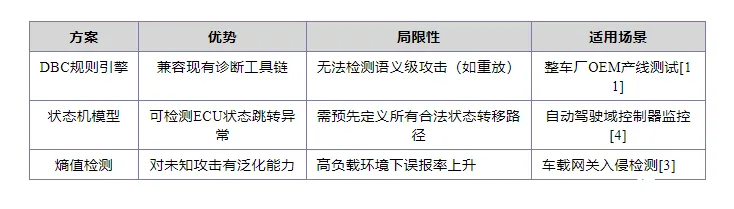
实际应用案例
特斯拉早期 IDS 规则集:
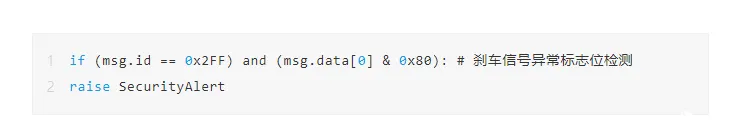
效果:可拦截 80% 的简单注入攻击
大陆集团 Sentry 系统
采用多级规则链:物理层 CRC 校验 → 2。 协议字段合规性 → 3。 信号值范围验证
延迟: <2ms@100Mbps 总线负载
规则与机器学习方法的协同
前置过滤:规则系统快速拦截已知攻击模式,降低 ML 模型计算压力
后置验证: ML 检测结果需通过规则库二次确认(如防止方向盘转角信号突变)
当前趋势是规则 +ML 混合检测,如奥迪 A8 的 IDS 将规则引擎与 LSTM 模型并行运行,误报率降低至 0.01% 以下(《汽车信息安全:扒一扒 CAN 总线的安全漏洞(上)》)。
规则型防御的优点在于:
又小又快,适合在嵌入式算力受限;可解释性强,易于回溯。
但是缺点和优点是一体两面的,规则太死板无法变通细分场景,而且人为编写的规则对多如牛毛的场景覆盖不足,只能吃一堑长一智,不断的补充规则。
三、 防御机制部署和运行在什么地方
所谓机制,得具体体现在软件和运行软件的硬件上。防御机制的硬件在哪里?软件在哪里?
总体来说就两种:车端单独部署和车云结合。而机器学习主要在云端,因为机器学习模型需要较大的算力和存储空间,不适合在车端嵌入式。至少在训练阶段(算力大且耗时长)不适合。
当然也有例外,比如决策树,随机森林或者聚类算法等轻量级机器学习模型也可以部署在车端嵌入式里面。而且现在不断出现适配嵌入式的微型机器学习库,比如 tinyML , shuffleNet 等等。
但很少有抛开车端嵌入式 ECU ,单独只使用云端的,因为云端需要网络回传,受制于网络状态,响应时间和响应保证不确定,特别在极端天气下或者隧道场景下效果更差。另外流量费也是不小的开销,推高产品成本,降低竞争力。
具体的,基于规则 + 机器学习的车载 CAN 总线入侵检测 CAN-IDS ( IDS 是 intrusion detection system )可根据部署位置分为车端实时检测和云端协同分析两类,其技术特点和典型案例如下:
1
车端实时检测系统
1. 轻量化模型(嵌入式部署)
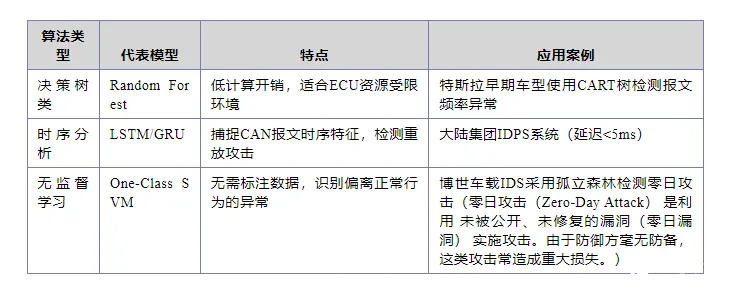
2. 混合架构(规则 +ML )
DBC 规则引擎:先通过 DBC 文件校验报文格式合法性,再用 SVM 分类可疑流量
联邦学习:车端模型定期与云端同步参数更新(如丰田 Guardian 项目)
2
云端协同分析系统
1. 大数据分析平台
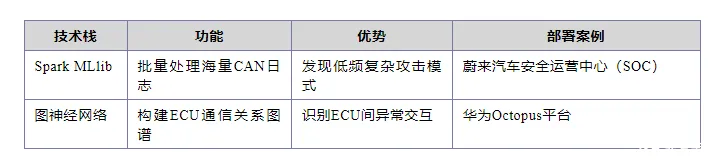
2. 边缘 - 云协同
边缘节点:网关部署轻量级模型(如 TinyML )执行初步过滤
云端模型:深度分析聚合数据(如用 ResNet 检测多车协同攻击)
部署对比与性能指标
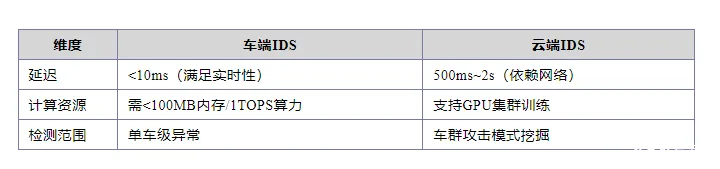
当前主流方案采用车端轻量化检测 + 云端深度分析的协同架构,如盖瑞特方案同时支持两种模式。
四、 机器学习的作用
首先说明无论机器学习还是规则,对保护 CAN 免受物理类的电磁攻击没有效果,仅限软件层面才有效果。
电磁攻击比如在 CAN 线附近高能放电,比如闪电或者人为放电,由于 CAN 线本质还是电路,会由于电磁感应而在线路内激起电压或者电流变化,而信号又是用电压差分表示的,可能会信号错乱。
机器学习用 CAN 总线入侵检测,主要是两方面:报文流量特征(不看报文内容)和报文内容(也就是虚假指令)。
我们先谈虚假指令这一块。
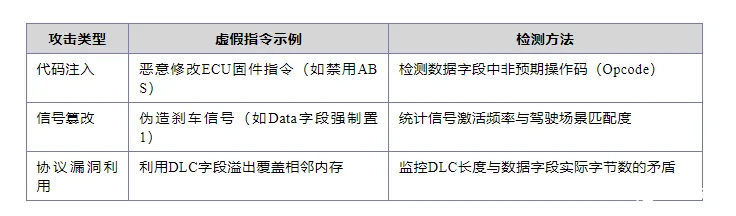
虚假指令通常隐藏在 CAN 报文的数据字段中,表现为:
数据值异常: 超出传感器合理范围(如车速突然从 0 跳至 300km/h )。当然,这也有可能是 uint8 数据溢出问题,这是编程没编好,要靠其他机制来避免。
字段组合违规: 违反协议定义的信号组合(如刹车信号与油门信号同时激活)。
时序逻辑矛盾: 信号变化不符合物理规律(如发动机转速骤降但车速未减)。
机器学习检测报文内部虚假指令的核心是通过分析报文数据字段( Payload )的异常模式(异常模式包括字节级别,信号级别,和时序级别),结合上下文时序特征进行综合判断。
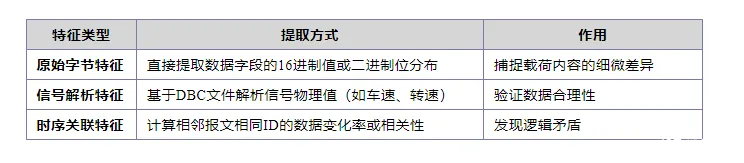
虚假指令的攻击场景与检测案例
这种判断虚假指令的机器学习本质是在判断异常(字节级别,信号级别,和时序级别)的概率分布,如果某些变化的概率分布从未见过或者极为小众,则判断为假。
比如基于预测误差的方法: 训练 LSTM 预测下一帧数据字段,若实际值与预测值误差超过阈值则判定为虚假指令。
打一个比方,某人告诉你他们班有个同学身高 1.7 米,你会觉得很正常;如果说高 1.9 米,也可以接受但会惊叹一下;如果说 2.3 米你会很惊讶;如果说 3 米你会断然不信。因为你已经学习了人类身高的正常分布。机器学习是一样的。即使是急刹车行为,在大数据视角下,也是有概率分布可循的。
我们再谈流量模式这一块。
在 CAN 总线入侵检测中,机器学习( ML )通过分析通信流量的时序、频率、负载等特征来识别异常行为。以下是具体方法和应用场景:
流量异常检测的核心特征
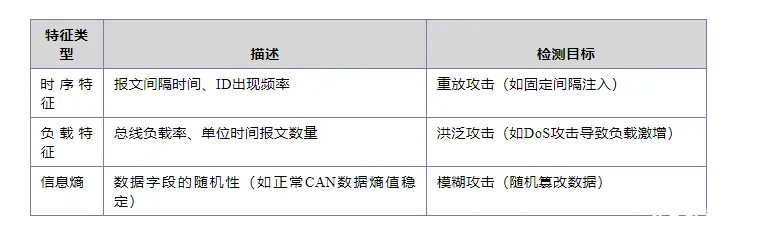
熵值在信息论中表示数据的 “ 不确定性 ” 或 “ 混乱程度 ” 。
熵值低表示数据规律性强、重复度高(如周期性发送的传感器信号)。
熵值高表示数据随机性强、无规律(如被篡改或伪造的异常数据)。
熵值低好,高不好,所以华为任老板一直在要求 “ 熵减 ” ,对抗熵增,就在于此。
正常的 CAN 数据的熵值稳定且比较低,本质是因为车辆通信的 “报文规律性” 和 “内容确定性”;熵值突然变高则是识别总线异常的关键信号,是汽车网络安全防护的重要监测指标。
检测流量异常的机器学习方法分类
(1) 监督学习
适用场景:已知攻击类型的标注数据充足(如注入攻击、重放攻击)。
典型模型:随机森林:通过多棵决策树投票判断异常(准确率 >95% )。
SVM :利用核函数分离高维特征空间中的异常点(适合小样本)。
(2) 无监督学习
适用场景:缺乏攻击标注数据,仅依赖正常流量建模。
典型模型:自编码器( Autoencoder ):重构误差高的报文视为异常(检测未知攻击)。
聚类(如 K-Means ):偏离正常簇中心的流量判为异常。
(3) 深度学习
适用场景:处理高维时序数据(如原始 CAN 报文序列)。
典型模型: LSTM :捕捉长周期依赖(如检测间歇性攻击)。
1D-CNN :提取报文字节级局部模式(对信号篡改敏感)。
流量异常的典型攻击与检测案例
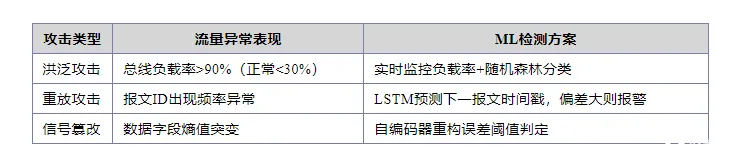
最后谈一下明星范式 ---联邦学习。联邦学习(Federated Learning)是一种分布式机器学习框架,旨在解决数据隐私、安全和合规问题。它允许多个参与方(如企业、机构或设备)在不共享原始数据的前提下,协同训练机器学习模型,实现 “数据不动模型动,数据可用不可见” 的目标。这种模式在医疗、金融、物联网等对数据隐私敏感的领域具有重要应用价值。
核心思想有如下三方面:
数据本地化: 各参与方的原始数据保留在本地,不对外共享;
模型分布式训练: 通过交换模型参数(如权重、梯度)或中间结果,在中央服务器或去中心化网络中协同更新全局模型;
隐私保护: 避免因数据共享导致的隐私泄露风险,符合《通用数据保护条例》( GDPR )、《个人信息保护法》等法规要求。
直观地总结,联邦学习的精髓是在使用子模型(局部数据训练出来的)代表(和隐藏)某一局部数据,然后多个子模型聚合训练形成统一的大模型。核心就是 “模型代表数据”。而每一辆车,每一位车主,每一个车队,都是一个局部数据。最后统一的大模型不知道任何局部数据,只知道局部子模型。
五、 入侵检测数据集
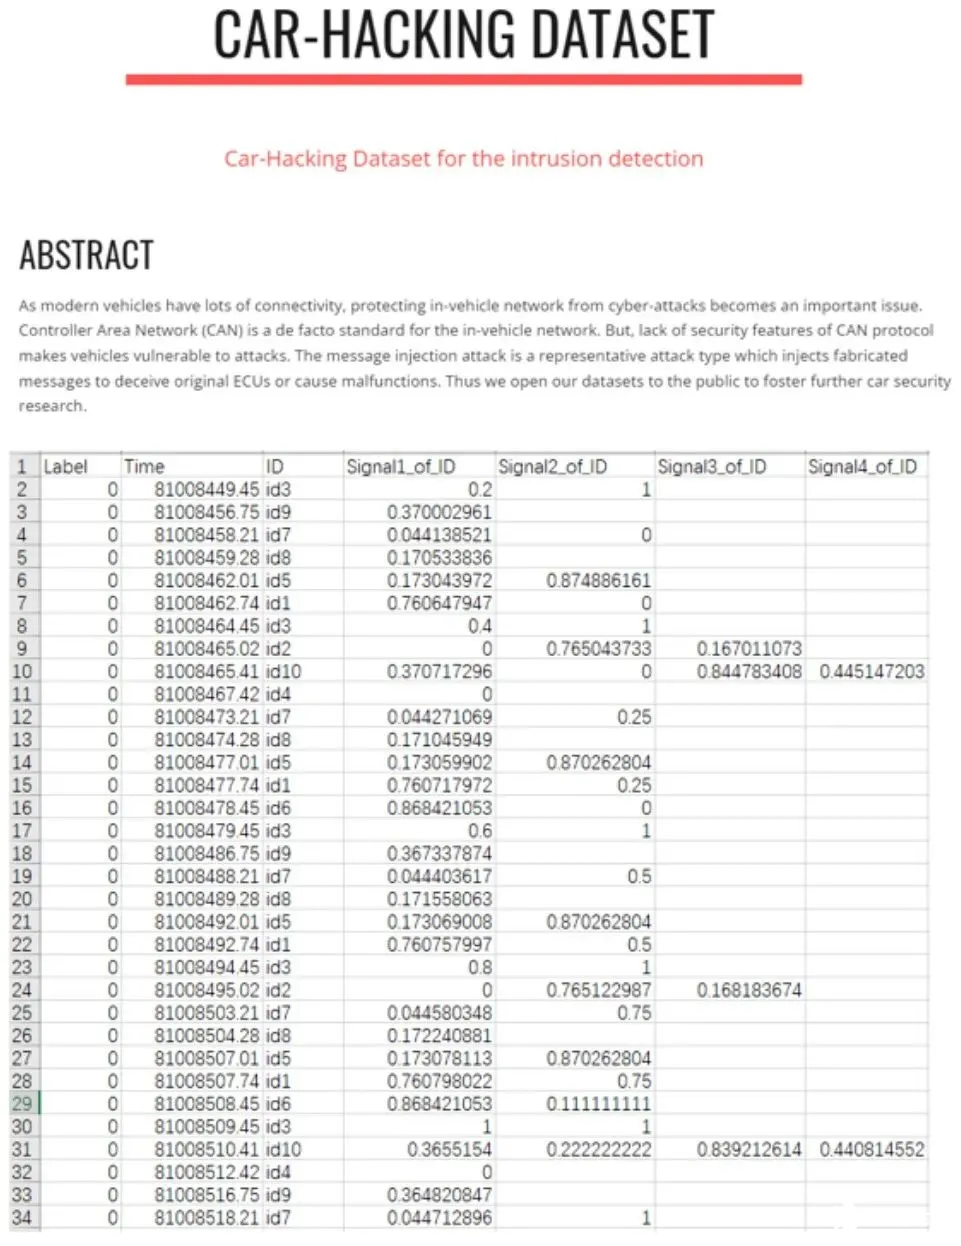
专门针对车辆 CAN 总线入侵的数据集并不是特别多,比如韩国 HCLR 实验室数据集。
由韩国 HCLR 实验室提供,包含 Car Hacking 和 Road 两个数据集。可在 https://ocslab.hksecurity.net/Datasets/CAN-intrusion-dataset 获得。
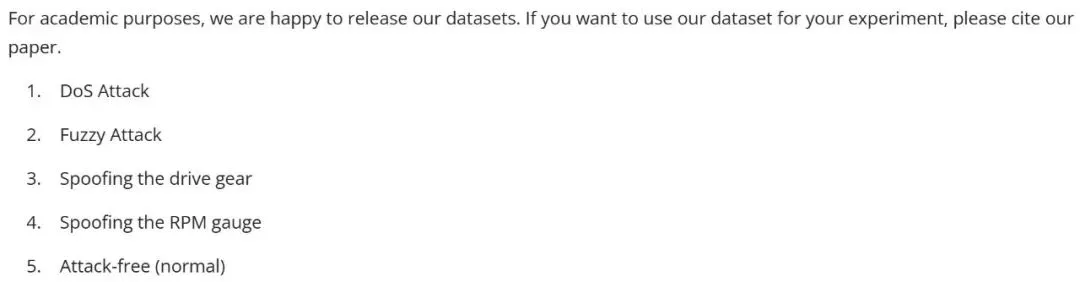
包含 Fuzzy 攻击、 DDoS 攻击、 Spoofing 攻击等多种攻击模式的脱敏数据。
数据集构成:压缩文件包括 road.zip 和 CarHackData.zip ,文件中包含经过预处理的 CAN 总线通信数据,如帧隔离、时间同步、标签化(标注正常或异常行为)等,以便研究者直接用于训练和验证模型。
还有一个虽然不是专为车辆领域使用,但经常被车辆网络用来训练检测流量异常的数据集是 KDD Cup 系列(最早的是 1999 )。 KDD Cup 99 数据集是一个广泛用于网络入侵检测研究的标准数据集。它包含了正常网络连接和各种网络攻击的数据,用于构建能够区分 “ 好 ” 连接和 “ 坏 ” 连接的网络入侵检测器, 经常用于构建基于机器学习的入侵检测系统( IDS )。
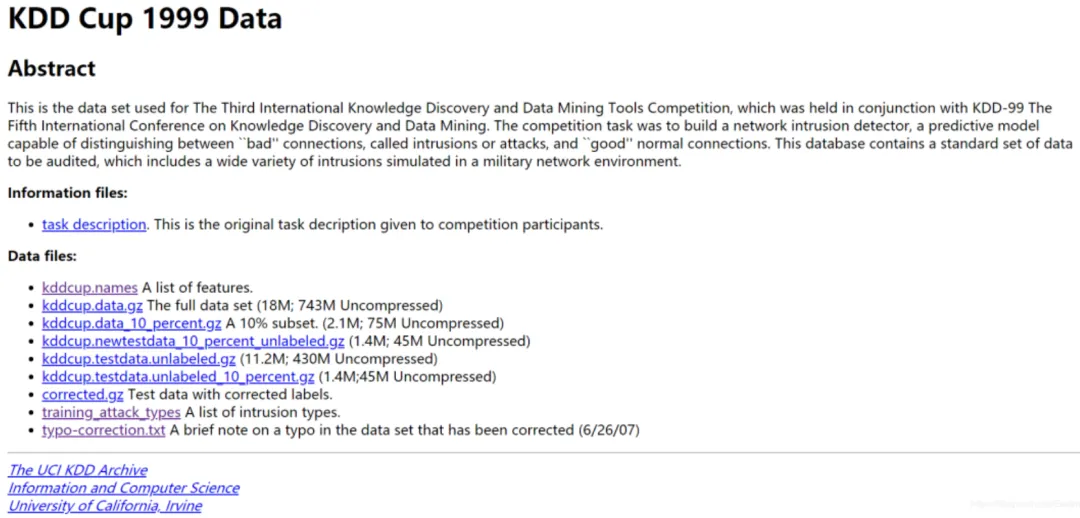
比如利用 KDD Cup 数据集中的 41 维特征(如连接持续时间、协议类型、端口号、字节数等)和标签(正常 / 攻击类型),训练传统机器学习模型(如决策树、朴素贝叶斯、 SVM )或早期神经网络模型。
使用训练集中的 22 种已知攻击数据(如 ftp_write 、 smurf 、 neptune )训练模型,使其学会识别已知攻击的特征模式。
利用数据集中的正常流量数据(约占 19.4% )学习 “ 正常行为基线 ” ,用于区分异常流量。
它还可以针对数据集中的未知攻击(测试集中的 17 种新攻击类型,如 portsweep 、 ipsweep ),研究如何通过无监督学习(如聚类、异常点检测)识别未标记的异常流量。
研究未知攻击主要是为应对零日缺陷(前面描述过),模拟真实场景中 “ 未知攻击难以提前标注 ” 的挑战,推动无监督入侵检测技术的发展。
虽然 KDD Cup 数据集可以为 CAN 总线入侵检测提供一定的参考和帮助,但由于其并非原生的 CAN 总线数据集,在应用过程中可能存在一些局限性,如对 CAN 总线特定攻击类型的覆盖不足、数据特征与实际 CAN 总线数据的差异等。因此,在实际应用中,还需要结合真实的 CAN 总线数据和领域知识,对模型进行优化和验证。
六、 总结
CAN 总线异常检测正处于规则和机器学习并重的时代。随着车载芯片特别是各类 SOC 的逐步强大,车端机器学习越来越强大;而云端的机器学习算力也成比例的扩大。
未来主流模式应该是 “ 简单问题车端解决,复杂问题云端解决 ” 的车云协同的 CAN 线异常检测。
但是,无论机器学习如何强大,完全取消规则判断,这在短期内不会发生。因为规则判断除了资源消耗小速度快的优点外,还有一点是可解释性强,便于监管和回溯。
未来的一种趋势是使用机器学习来机器自动生成庞大的规则集,其覆盖面远超人为设计的规则集。





