


作者 | 不可说
一、引 入
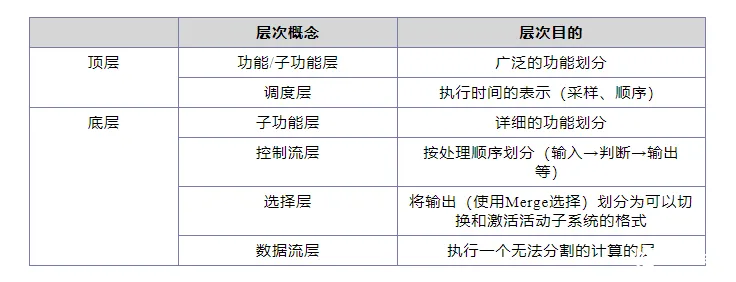
在汽车电子软件开发过程中,使用 Simulink 进行 MBD 建模时,最好是要 理解控制器模型的架构,例如功能 / 子功能层、调度层、控制流层、 选择 层和数据流层。
-
功能 / 子功能层( Function/Subfunction Layers ) :这是模型的核心部分,定义了控制器的主要功能和子功能。每个功能通常对应一个特定的控制任务,而子功能则是这些任务的细分模块。
-
调度层( Schedule Layer ) :这一层负责管理模型中不同功能的执行顺序和时间安排。它确保各个功能按照预定的时间表或条件正确执行。
-
控制流层( Control Flow Layer ) :控制流层定义了模型中控制信号的流向和逻辑关系。它决定了功能之间的交互顺序和条件,确保模型的逻辑正确性。
-
选择 层( Selection Layer ) : 选择 层用于将模型 抉 为不同 执行 的逻辑区域或模块 ,以实现在不同条件下的逻辑执行。
-
数据流层( Data Flow Layer ) :数据流层描述了模型中数据的传输路径和存储方式。它确保数据在不同功能和模块之间正确传递和处理。
下面就会介绍下 MBD 的分层概念与模型架构。
二、控制器模型的分层结构
本节提供了一个基本模型的分层结构的概述,以控制器模型为例。下表定义了层次中的层概念。
当应用层次概念时:
-
应将层次概念分配给层次,并相应地划分子系统。
-
如果不需要某一层的概念,则无需将其分配给层次。
-
可以将多个层次概念分配给一个层次。
在构建层次结构时,应避免为了节省空间而将子系统划分为层次。
顶层
顶层的布局方法包括:
-
简单控制模型: 在同一层中表示功能层和调度层。这里,功能是执行单元。例如,控制模型只有一个采样周期,所有功能按执行顺序排列。
-
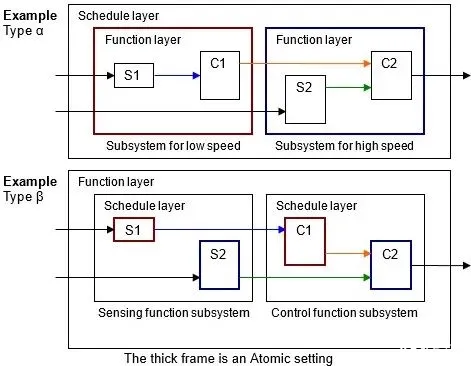
复杂控制模型类型 α: 将调度层置于顶层。这种方法便于与代码集成,但功能被分割,模型的可读性会受到影响。
-
复杂控制模型类型 β: 功能层置于顶层,调度层位于各个功能层之下。
功能层和子功能层
在建模功能和子功能层时:
-
应按功能划分子系统,每个子系统代表一个功能。
-
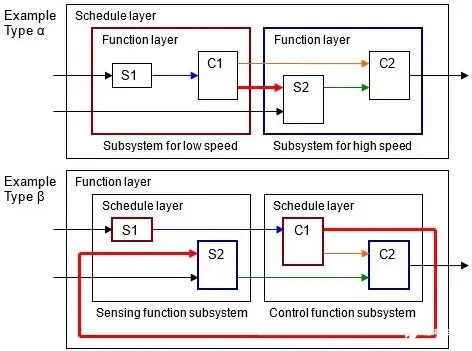
一个功能不一定是执行单元,因此相应的子系统不一定是原子子系统。在类型 β的例子中,将功能层子系统作为虚拟子系统更为合适。如果将这些子系统转换为原子子系统,可能会产生代数环。
-
应描述各个功能单元。
-
如果模型包含多个大型功能,考虑为每个功能使用模型引用以划分模型。
调度层
在调度层:
-
应设置系统采样间隔和执行优先级。在设置多个采样间隔时要小心。在具有不同采样间隔的连接系统中,应确保系统按每个采样间隔进行划分。这可以在处理快速循环和慢速循环的信号值不同时,最小化存储先前值所需的 RAM 。
-
应设置优先级排名。在设计多个独立功能时,这很重要。如果可能,所有子系统的计算顺序应基于子系统连接。
-
应设置两种不同类型的优先级排名,一种用于不同的采样间隔,另一种用于相同的采样率。
-
设置采样间隔和优先级排名的方法有两种:
1) 对于子系统和块,设置块参数采样时间和块属性优先级。
2) 当使用条件子系统时,设置独立的优先级排名以匹配调度器。
存在许多不同条件的模式,例如自定义采样间隔的配置参数、原子子系统设置以及模型引用的使用。使用特定模式与代码实现方法密切相关,并且根据项目的状况而有很大差异。通常受影响的模型包括:
-
具有多个采样间隔的模型
-
具有多个独立功能的模型
-
使用模型引用
对于生成的代码,受影响的因素包括:
-
实时操作系统的适用性
-
可用采样间隔和要实现的计算周期的一致性
-
适用领域(应用领域或基础软件)
-
源代码类型: AUTOSAR 不符合 / 不支持
控制流层
在层次结构中,控制层使用一个函数表达所有输入处理、中间处理和输出处理。在这一层中,块和子系统的排列很重要。应通过将多个混合的小功能划分为输入处理、中间处理和输出处理这三个最大的阶段来对它们进行分组,这构成了控制的概念基础。一般配置接近数据流层,并以水平线表示。数据流层的不同之处在于它由多个子系统和块构成。
在控制流层中,水平方向表示具有不同意义的处理;具有相同意义的块垂直排列。
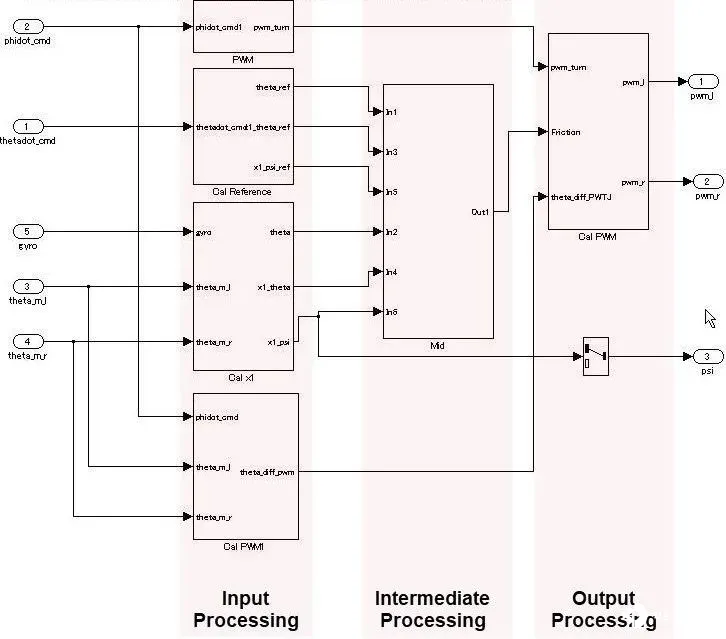
计算 PWM ,以尽量减少参考值和测量值之间的差异
块组水平排列并赋予临时意义。红色边框表示不可见处理的分隔符,对应于称为虚拟对象的对象。
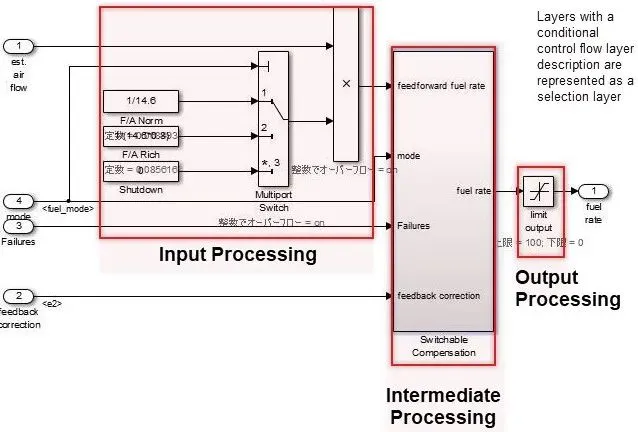
控制流层可以与具有功能的块共存。它们位于子功能层和数据流层之间。当以下情况时使用控制流层:
-
块的数量变得太大
-
所有内容都描述在数据流层中
-
可以被赋予最小部分意义的单元被制成子系统
在层次结构中的放置组织了内部层配置,并通过避免创建不必要的层来提高可理解性和可维护性。
当模型仅由块组成且不包含子系统混合时,如果水平布局可以划分为输入 / 中间 / 输出处理,则被视为控制流层。
选择层
在建模选择层时:
-
选择层应垂直或并排书写。选择哪种方向没有意义。
-
选择层应与控制流层混合。
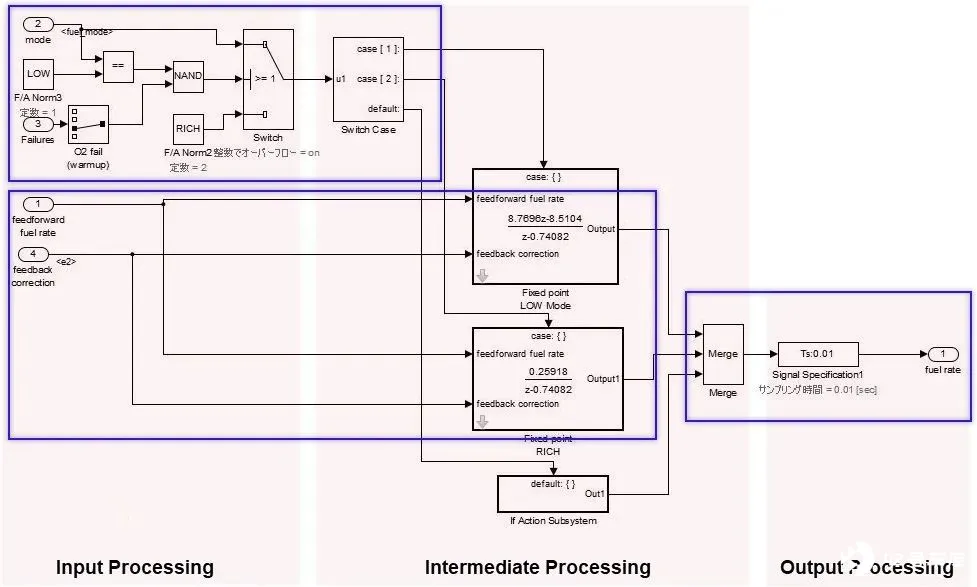
当子系统具有 switch 功能,根据条件控制流内部的红色边框只允许一个子系统运行时,它被称为选择层。它也被描述为控制流层,因为它结构化了输入处理 / 中间处理(条件控制流) / 输出处理。
在控制流层中,水平方向表示具有不同意义的处理。具有相同意义的并行处理则垂直排列。在选择层中,水平方向或垂直方向没有特定的意义,但它们表示的层次结构中,只有一个子系统可以运行。例如:
-
将耦合功能向上或向下切换,改变时间顺序。
-
在首次(重置后立即)和第二次运行时切换计算类型。
-
在目标 A 和目标 B 之间切换。
数据流层
数据流层是控制流层和选择层下面的层。
数据流层将一个函数作为一个整体表示;输入处理、中间处理和输出处理不分割。例如,执行一个连续计算且不能分割的系统。
数据流层不能与除适用排除条件之外的子系统共存。排除条件包括:
-
设置了可重用功能的子系统
-
注册在 Simulink 标准库中的子系统
-
注册在用户库中的子系统
简单数据流层的例子:
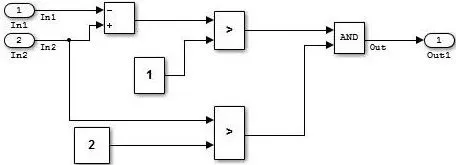
复杂数据流层的例子:
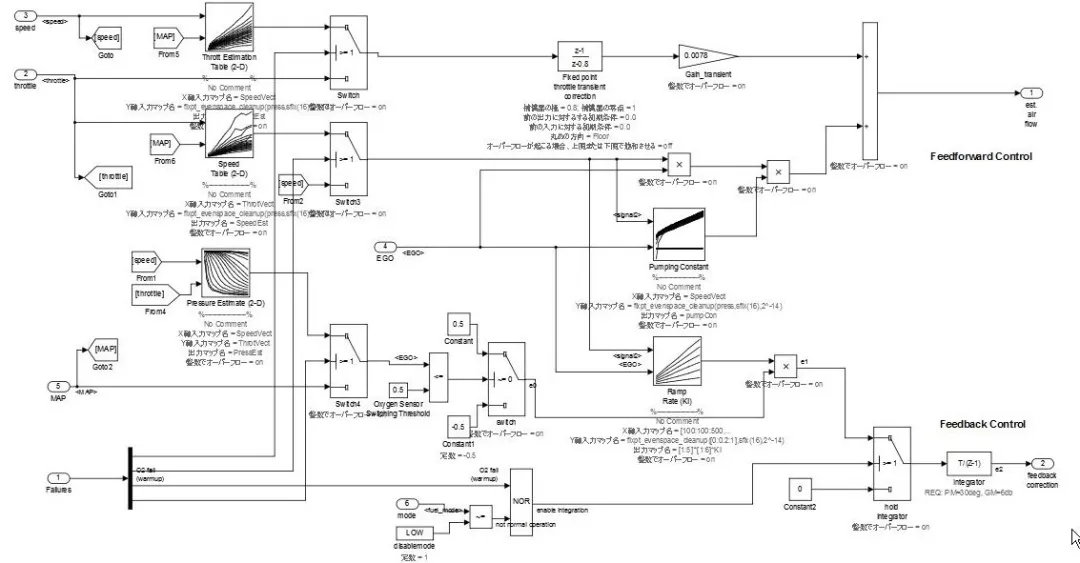
当输入处理和中间处理不能像上面描述的那样清晰分割时,它们被表示为数据流层。
当像上面描述的那样同时计算来自同一信号的前馈响应和反馈响应时,数据流层变得复杂。即使在这种情况下块的数量很大,当功能不能清晰分割时,设计中不应包含子系统。当通过分割赋予意义时,应设计为控制流层。
三、Simulink 模型与嵌入式实现之间的关系
在实际控制器上运行需要将从 Simulink 模型生成的代码嵌入到控制器中。此要求影响 Simulink 模型的配置,并取决于:
-
Simulink 模型将建模的功能程度
-
如何嵌入生成的代码
-
嵌入式控制器上的调度设置
当嵌入式微控制器的任务与 Simulink 建模的任务不同时,配置会受到显著影响。
嵌入式软件中的调度器设置
嵌入式软件中的调度器具有单任务和多任务设置。
单任务调度设置
单任务调度器使用基本采样执行所有处理。因此,当需要更长采样的处理时,函数被分割,以便尽可能均匀地分配 CPU 负载,然后使用基本采样进行处理。然而,由于不能总是进行等分,因此可能无法将函数分配到所有周期。
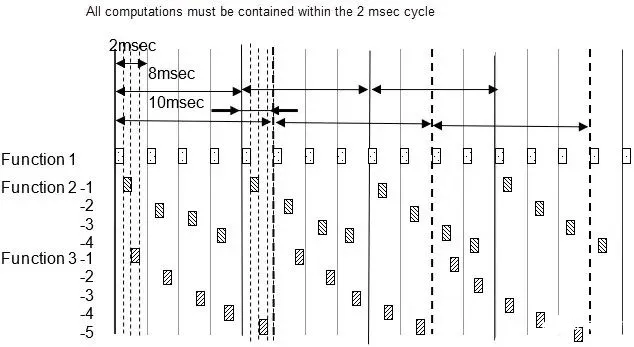
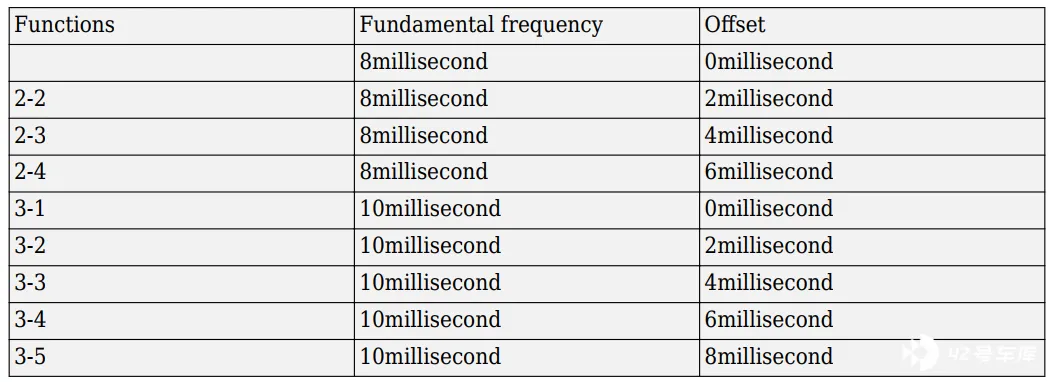
例如,基本采样为 2 毫秒,模型中存在 2 毫秒、 8 毫秒和 10 毫秒的采样率。 8 毫秒的函数每四个 2 毫秒周期执行一次, 10 毫秒的函数每五个周期执行一次。每 2 毫秒计算执行次数,并执行由该频率指定的采样函数。需要注意的是, 2 毫秒、 8 毫秒和 10 毫秒的周期都用相同的 2 毫秒计算。由于所有计算都需要在 2 毫秒内完成,因此 8 毫秒和 10 毫秒的函数被分割成多个,并调整为所有 2 毫秒的计算量几乎相等。
下图显示了 8 毫秒的函数被分成 4 个, 10 毫秒的函数被分成 5 个。
为了设置分频任务:
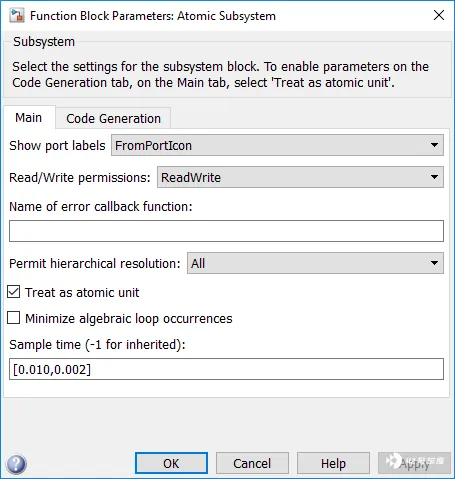
1. 清除配置参数“将每个离散速率视为一个单独的任务”。
2. 对于原子子系统块参数“采样时间”,输入采样周期偏移值。可以指定采样周期的子系统称为原子子系统。
多任务调度器设置
多任务采样通过使用支持多任务采样的实时操作系统来执行。在单任务采样中, CPU 负载的均衡不是自动完成的,而是由人将函数分割并分配给指定的任务。在多任务采样中, CPU 根据当前状态自动执行计算;无需设置详细设置。计算从最高优先级的任务开始执行,并输出结果,但任务优先级由用户指定。通常,快速任务被分配最高优先级。此任务的执行顺序由用户指定。
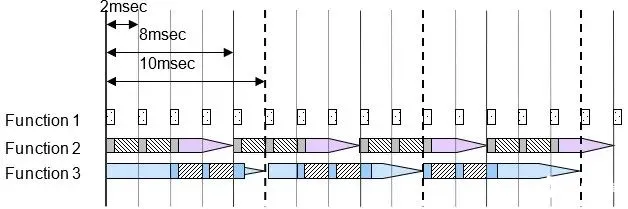
重要的是,包括慢速任务在内的计算应在周期内完成。当高优先级计算过程完成且 CPU 可用时,开始执行具有下一个优先级排名的系统的计算。高优先级计算过程可以中断低优先级计算,后者被终止以便高优先级计算过程首先执行。
连接具有采样差异的子系统的影响
如果具有 20 毫秒采样间隔的子系统 B 使用具有 10 毫秒采样间隔的子系统 A 的输出,则在子系统 B 计算时,子系统 A 的输出结果可能会发生变化。如果在计算过程中值发生变化,则子系统 B 的计算结果可能不如预期。例如,在子系统 B 的第一次计算中与子系统 A 的输出进行比较,并根据此输出进行条件判断并计算结果。此时,比较结果为真。然后在子系统 B 的末尾再次进行比较;如果 A 的输出不同,则比较结果可能为假。通常,在这种类型的函数开发中,可能会出现逻辑从真、真变为真、假,从而产生意外的计算结果。为了避免这种故障,当任务发生变化时,子系统 A 的输出结果应在被子系统 B 使用之前立即固定,因为它们在与子系统 A 输出信号不同的 RAM 中使用。换句话说,即使在过程中子系统 A 的值发生变化,子系统 B 查看的值在不同的 RAM 中,因此没有明显的影响。
当在 Simulink 中创建模型并通过 Simulink 连接具有不同采样间隔的子系统时, Simulink 会自动保留所需的 RAM 。然而,如果通过与手写代码的集成以不同的采样间隔获取输入值,则进行嵌入工作的工程师应设计这些设置。例如,在使用 AUTOSAR 的 RTE 概念中,所有不同的 RAM 都在接收和输出端定义。
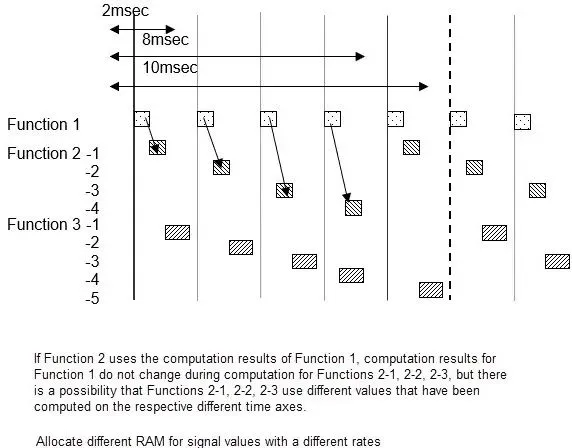
单任务调度器设置:
在相同的 2 毫秒周期内,信号值相同,但在不同的 2 毫秒周期中,计算值与前一个不同。当函数 2-1 和 2-2 使用函数 1 的信号 A 时,要注意 2-1 和 2-2 使用不同时刻的结果。
多任务调度器设置:
对于多任务,无法指定使用计算结果的点。对于多任务,总是为不同任务的信号存储在新的 RAM 中。在任务内进行新的计算之前,复制所有值。
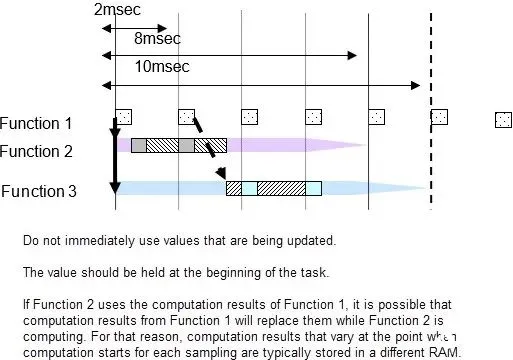
四、小 结
在 做 Simulink 模型 开发 时,理解分层架构至关重要,在建模时应明确每个层次的作用和目的,合理划分功能和数据流,以提高模型的可读性和可维护性。具体到各层设计,在调度层中,要根据系统需求合理设置采样间隔和任务优先级,确保系统的实时性和稳定性;在设计功能层时,则需注意避免因子系统类型选择不当而导致的代数环问题。此外,在连接具有不同采样间隔的子系统时,要注意信号值的变化可能对计算结果的影响,并采取适当的措施(如信号固定)以避免意外行为,即处理好采样差异。同时,在设计 Simulink 模型时,还应考虑最终的嵌入式实现,包括代码生成、调度器设置和内存管理等方面,以确保模型能够顺利转换为实际的嵌入式代码。通过理解和应用这些建模原则,可以提高控制器模型的质量,使其更易于开发、维护和实现。







