


撰文 | 张祥威
编辑|马青竹
2025 年最后一个月,部分车企获得 L3 级自动驾驶路测牌照,为明年的新一轮竞赛埋下伏笔。
另一边,无人驾驶公司也在持续打磨 L4 。
最近, Waymo 的无人驾驶出租车因大规模停电,在十字路口红绿灯全黑时出现大面积 「 趴窝 」 ,引发严重拥堵。
有行业人士分析,深层问题在于其采用 「 规则驱动 」 而非 AI 驱动。
可见智驾仍需进化, 至少 从技术角度看,仍有不少谜题待解。
诸如:
「 端到端 +VLM」 的下一站,是不是 VLA ?
「 一段式端到端 + 强化学习 」 ,是否比 VLA 更先进?
世界行为模型和 VLA 相比究竟有何不同?
VLA 和世界模型,究竟谁才是更优解?
……
当智驾 领域 疑云弥漫,厘清问题,可以更好地辨别孰强孰弱,也许还能照见 「 陷阱 」 。
那么,智驾 进化到 2025 年底 ,究竟有没有 理出 一条清晰的路线图?
大乱斗
12 月下旬,英伟达全球副总裁、汽车事业部负责人吴新宙,在上海浦东测试了多家车企和供应商的智驾方案。据悉,其对文远知行、地平线的方案评价颇高。
但过去一年的经验证明, 单说体验层面, 似乎有点你追我赶,名次波动频繁, 其实难以直接断言不同方案的优劣。
例如, 基于规则驱动的智驾 表现 ,在某个时间段内也许比基于数据驱动更加稳定。不同代际的模型架构,在某个时间点也会出现 「 旧 」 打败 「 新 」 的情况。
即便就技术本身而言,行业有共识,更不缺争议。
去年还被各家一致夸赞的 「 端到端 」 ,如今被理想、小马智行等竞相指出存在技术局限。
行业普遍认为: 「 端到端的本质是模仿学习,存在 overfit (过拟合)和不可解释等问题。 」 面对训练过的场景会表现出色,但遇到从未在训练集中见过的新场景时,就有可能导致决策错误。一句话,学得太死板。
迈入「端到端」时代值得庆祝,但需补充新的能力,各家的技术路线由此分化。
截至目前,据《出行百人会 /AutocarMax 》不完全统计,市面上的核心智驾模型至少有 6 种,分别为 VLA 、 WEWA 、 「 端到端 + 强化学习 」 和世界模型等。
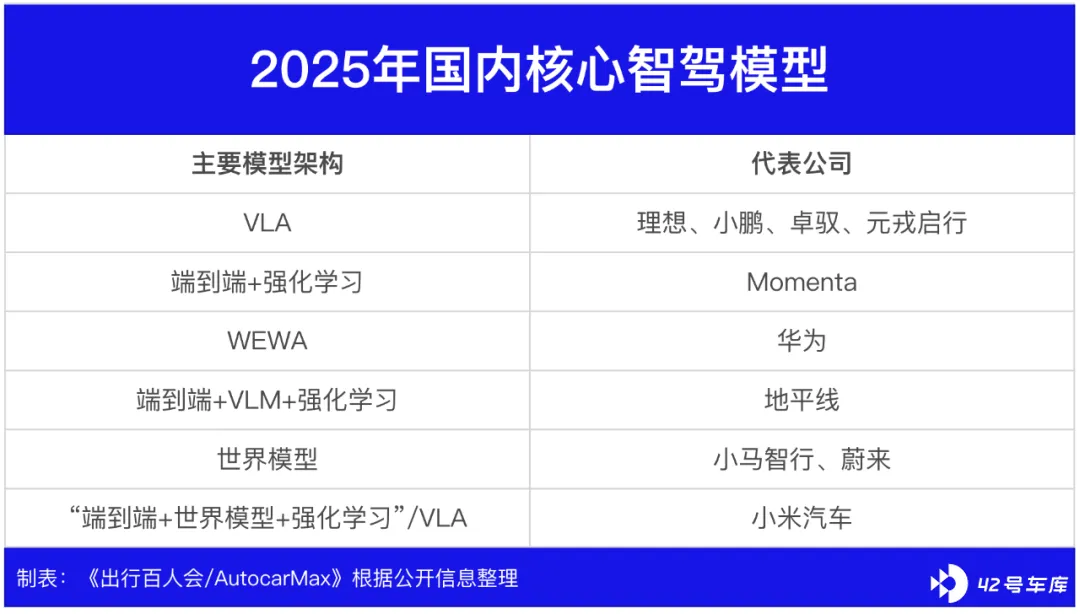
一类采用 「 端到端 +VLM+ 强化学习 」 。如地平线,在一段式端到端的基础上,借助云端的 「VLM+ 强化学习 」 来训练语义模型,从而处理可变车道等需要理解交通规则的场景。
另一类坚信 VLA 。这一技术阵营包括理想、小鹏、卓驭和元戎启行等。其核心观点为, 「 端到端 +VLM」 存在延时和信息损失,可支持实现 L3 ,但要实现 L4 则离不开 VLA 。
值得注意的是,对于 「 端到端 +VLM」 的协作,早期有人将其比喻为教练坐在副驾指挥驾驶员开车,后来也有人将其比作赛车手和领航员的配合关系。无论如何,基本可以认为,端到端的确存在能力的局限性。
据悉,小米汽车正一边布局 「 端到端 + 世界模型 + 强化学习 」 ,同时也在投入 VLA 研发。小米汽车智能驾驶 VLA 负责人陈龙指出,其要做的 VLA 是将端到端和 VLM 的能力融合在一起 ,如果 VLA 在各种场景下都比端到端好,那么将全面切向 VLA 这一新方案。
还有一类采用 「 端到端 + 强化学习 」 ,代表公司是 Momenta 。
其创始人、 CEO 曹旭东认为, 「VLM 、 VLA 是很好的方向,但属于锦上添花。想要提升,要用到强化学习,把端到端大模型放到通过海量真实数据构建起来的仿真环境去做探索。 」
Momenta 这种训练大模型的方法,类似给 ChatGPT 喂大量数据,最终产生类人的通识。
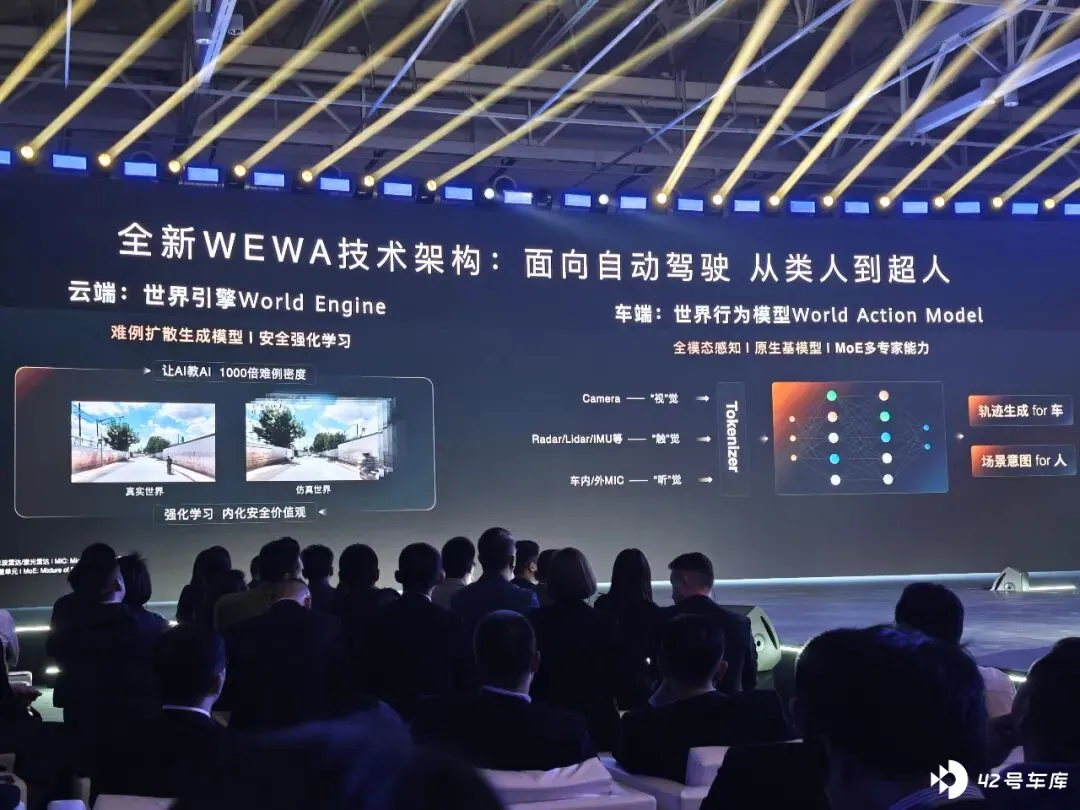
至于采用 WEWA 技术的公司,代表是华为。
其 做法是 ,输入视觉、 「 触觉 」 等 多模态 信息,直接输出控车指令。 这一过程中 , 跳过语言转换环节( VLA 会将视频等信息转化为语言 Token ,然后输出控车指令) ,以避免精度损失和信息转换延迟。
华为智能汽车解决方案 BU CEO 靳玉志曾表态, 「 不会走 VLA 的路径,这样的路径看似取巧,其实并不是走向真正自动驾驶的路径。华为更看重 WA ,也就是 World Action 。 」
最后还有一类选择世界模型的公司,如小马智行和蔚来。
小马智行副总裁、北京研发中心负责人张宁曾告诉我们,公司在 2023 年布局端到端研发,后来发现其不能解决所有问题,便转向世界模型。
从规则驱动,到数据驱动,如今又来到 「 认知驱动 」 ,智驾技术持续进化,背后有没有一些共识?
共识
上述各家方案,虽称谓不一,但均未绕开 「 端到端、 VLM 、 VLA 、世界模型、强化学习 」 等技术范畴。拆解这些技术,可以发现一些共识。
共识一,智驾模型不仅要会模仿,还要能 「 理解 」 。
陈龙在加入小米汽车前,曾在英国自动驾驶初创企业 Wayve 供职,不仅与团队共同提出了 「 视觉 - 语言 - 行为 」 的模型框架,还是 LINGO 系列模型的核心开发者之一。
他认为, 「 端到端就像教动物学开车,但动物并不理解开车背后的行为。而 VLA 是在学习了人类世界的知识、交通规则、价值观的基础上,同时具备推理能力。 」
这一观点与理想类似。
前理想汽车智能驾驶技术负责人贾鹏,曾在拆解算法原型时表示:
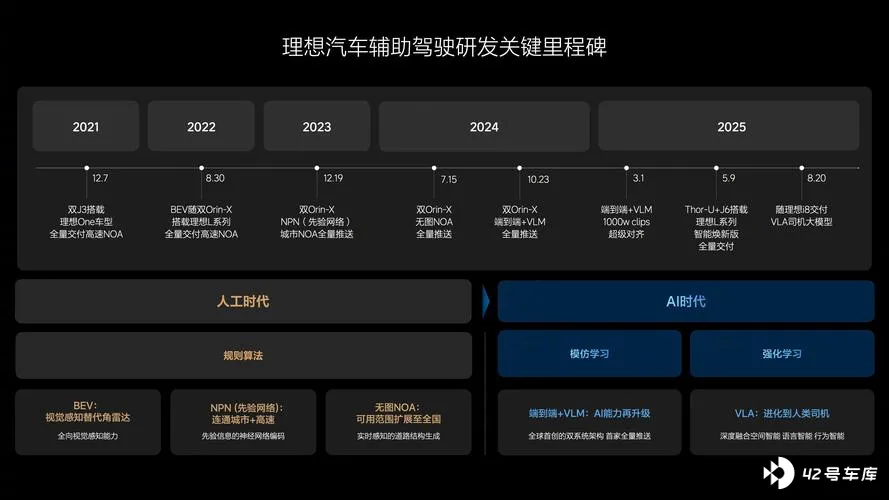
「 端到端模型的目的是学习行驶轨迹,但行驶轨迹是不确定的,即使同一个司机,在不同的场景、不同的时间,驾驶行为也不太一样。如果只是一味地通过模仿学习人,只能模仿对的,不知道什么是错的,会出现很多诡异的驾驶行为。 」
基于此,理想在训练过程中引入强化学习,让系统知道对与错,从而得出一个驾驶技巧、价值观均正确的模型。
共识二,目标逐渐趋同,要打造智能驾驶领域的基础模型。
近日,地平线创始人余凯与元戎启行创始人周光讨论智驾前景时,二人一致认为,如果能迅速构建基础模型, 智驾将从 L2+更快通往 L4, L3 的存在阶段将变得很短暂。
目前,各家的做法可大致分为几项:
通过 去掉人工监督和标注 等做法,减少信息损失和时延,提升模型的效率;
通过更大规模的优质数据,覆盖更多 corner case ,提升模型的泛化能力;
通过预训练、强化学习或世界学习等,提升模型对物理世界规律的理解能力;
通过思维链、 VLA 或世界模型等,提升长时序推理能力。
只不过细节有差别。例如, Momenta 强调的强化学习,主要通过海量真实数据构建起来的仿真环境来训练模型,这是因为其已经搭载在足够多的量产车型上。
而小马智行提出的世界模型,据我们了解更接近强化学习。这意味着,除了采集数据的规模不同,两家的目标存在相似性。
如果跳出智驾,在人形机器人等更广泛的具身智能领域,则在研发 「 通用模型 」 。一种设想是,未来或许会出现由人形机器人 开车 的情况。
未来,究竟是汽车机器人自己行动,还是由人形机器人坐进来开车,又或者是两种可能性都会发生?
结语
智驾从陷入 corner case 的汪洋大海,到受 ChatGPT 启示,借助大语言模型相对轻松地游走在数据海洋,再到现在,正忙于炼出一颗类人的驾驶大脑。
可以看到,模型开车的技巧在提升,已经能在小路上做出博弈等动作。也要看到,智驾领域的 corner case 并未被完全解决。
回看文章开头的那些问题,有的由发展阶段不同导致,也有的更多是技术细节的差别。在游戏没有通关前,或许真的存在多种解法。无论如何,提升模型能力,才是根本。


