作者:温斯罗普
翻看上一篇:外行眼里的特斯拉 AI Day(一)
本文原作者 @cosmacelf 是一位 reddit 技术作者,原文标题及链接:
《Layman's Explanation of Tesla AI Day》
https://www.reddit.com/r/teslamotors/comments/pcgz6d/laymans_explanation_of_tesla_ai_day
正文:
全文 2,100 字
预计阅读 10 分钟
下图展示了一个视觉识别系统的大致架构。但这只是识别的过程,系统只是知道了图像里具体是些什么东西,还不涉及驾驶和控制的架构。
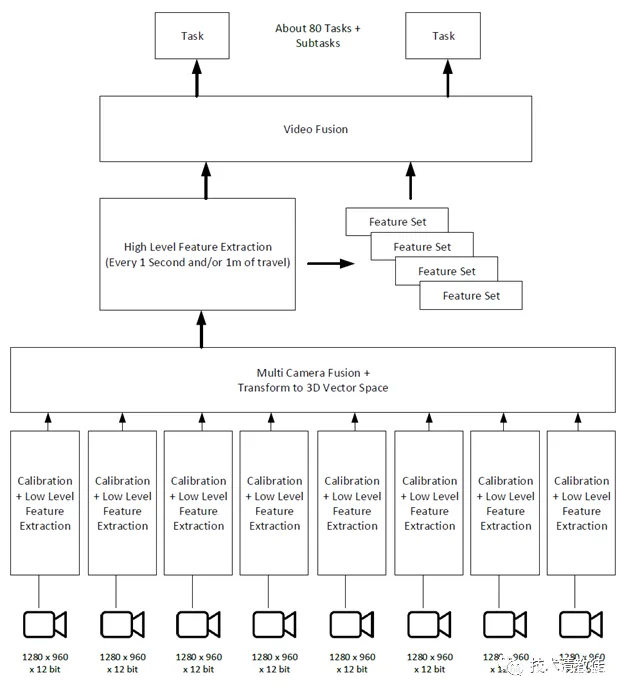
看到这里就会显得有些高深了,但是不用担心,下面我们会一步步解释一下它是如何工作的。所有这些框框都会包含几个到十几个神经网络,而且这些神经网络互相之间有着非常复杂的连接。
车上的 8 个摄像头会通过一个 「重置神经网络」(calibration neural net)将每一个摄像头都调整到能够稳定输出 「标准」 的图像。这个调整后的 「标准」 图像应该跟正在路上行驶的所有特斯拉拍摄出来的图像一致。
当车主购买了一台新的特斯拉,AP 系统会在几天内用重置神经网络调整摄像头的参数,以保证车辆后续能够输出稳定的标准图像。完成了这个程序后,车子就能够准确地知道每一个摄像头跟标准(baseline)之间的差异。每一个摄像头在安装和制造的时候由于公差等原因都有可能稍微有些偏移、角度倾斜等等。但无论如何,车子必须知道这些细微误差才能使得输出给神经网络的图像保持跟其他特斯拉的车子完全一致。只有车子输出给神经网络的图像是标准图像时,才能保证神经网络对图像内容的识别有效率。
完成了重置摄像头这一阶段后,车子的 AP 系统会将图像里那些标准的没有意义的图像内容剔除掉,但把重要的有意义的图像内容保留下来,这样可以减小或者压缩巨大的图像数据量,把数据量保持在一个合适的大小以方便后续处理它们。
下一步是把 8 个摄像头所看到的内容融合成一个全景,同时会生成一个 3D 的矢量空间(vector space)来模拟真实的世界。
对于人类的视觉皮层而言,想基于一张二维的图片生成一个三维的矢量空间,其实是一件再简单不过的事情。我们每天都在这么做,但可能我们根本察觉不到自己是在这么做。
我们看看以下的这张图片:
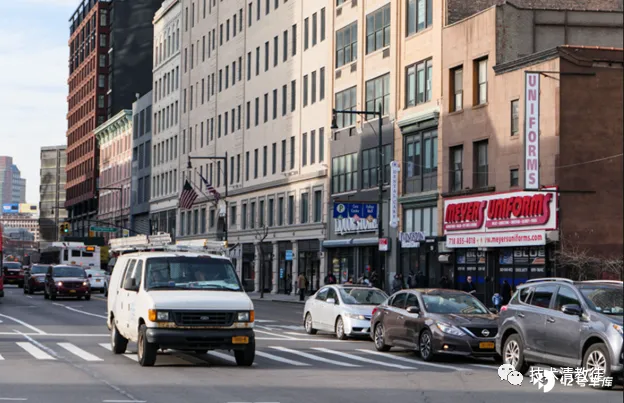
比如,你应该可以非常确定地看出来红灯是在这三辆连着的车子的后方,还有这个美国国旗和那辆带顶灯的车子大致在一样远的位置,而这带顶灯的车子在这辆白色小货车很远的后面。
特斯拉的神经网络也需要像这样把相对的位置关系运算出来,然后输出一个三维的带矢量坐标信息的世界,并对里面每个物体打上相应的标签。
特斯拉输出的三维矢量空间模型是一个具有一定密度的光栅(raster),每个光栅都带有距离数据。这跟激光雷达生成的点云数据很像。
另外,特斯拉的三维矢量空间还对移动的物体加入了速度的数据,定位了马路牙子和可以行驶的路面数据。这些都被标注成了不同的颜色,也有更高的分辨率。这套视觉系统比带激光雷达的系统要更加复杂一些,它输出的模型里还有一些被遮挡的物体。比如:一个行人在一辆车的后面,车子的摄像头当前看不到这个行人,但这套视觉系统却可以使用一套视频记忆模块来跟踪这些被遮挡的目标。
我们知道特斯拉的神经网络系统非常复杂。就像人类的视觉皮层一样,这些神经网络从高阶往低阶寻找有用的信息。
下面我们来看一个例子:我们想下面这个图片的框框里到底是个什么?
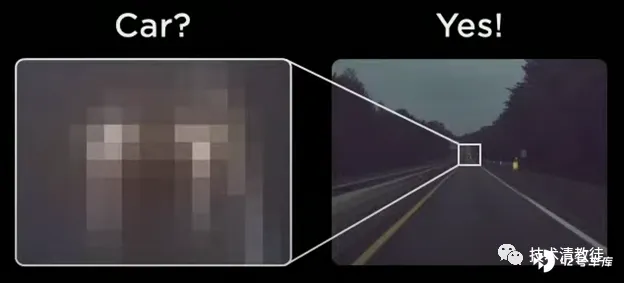
你的大脑知道这个 10x10 模糊不清的像素点大概率是在道路上,并位于图像即将消失之处,意味着这很可能是车子的尾灯。
当摄像头融合和三维矢量空间创建好了,特斯拉基于视频记忆模块再加入了时间和地点。
加入后者的好处是可以变得跟人的驾驶方式一样,因为这个世界的环境是为人类驾驶而设计和建设的。人类是有记忆的。
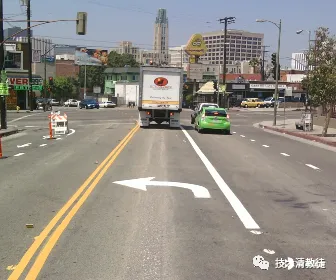
拿上图举一个例子:当我们在准备左转的时候会把车向左边车道变道过去,但当车子到达路口的时候,离看到左转箭头的时刻往往已经过去了好几秒。那么这时候就需要唤起记忆来确保自己记得车子是在左转的车道上。
特斯拉的视觉系统会创建一连串关键信息的快照(snapshot)列表来记住这些图形标识。这非常像我们自己驾驶,虽然我们可能不记得这个列表,但我们的潜意识确实是在用类似的方法在引导我们的驾驶。
这个视频记忆模块也用来跟踪前面说到的那些遮挡目标。比如,当特斯拉的车子在一条多车道上行驶,离车子左边两条车道上有一台车在行驶,但 3 秒之后被左边紧挨着我们车子的一台车挡住了。那么,这套视频记忆模块可以让神经网络记住那里有一台车被挡住了,然后推算出大致的位置。拥有这些信息对于某些情况下的路径规划非常关键。
特斯拉这套带有一连串关键信息快照的视频记忆模块很强大,不清楚其他自动驾驶公司是不是也有类似的功能模块(主流自动驾驶公司使用的都是预制好的高精度地图应该信息更全面,但高精度地图的制作和更新都非常艰巨,至于遮挡目标的跟踪功能就不清楚其他公司有没有了)。
特斯拉的视觉系统会输出一套三维的矢量空间数据,其中包含了现在的图像和一连串关键信息快照。这套三维矢量空间数据会输入到大约 80 个神经网络,特斯拉称之为 「任务」(task)。每一个任务都做一件非常具体的事情,像定位和识别交通灯的指示,或者识别交通桩桶、或者识别 「Stop」 标志、又或者识别车辆和车辆速度,等等。
这些输出的数据最后汇总成一个有意义的信息(semantic information),比如像:在距离现在 30 米的位置有一个红灯,又或者是前面 30 米那辆车子很可能会想要停车。
接下来的章节,我们会具体地讲一讲特斯拉的路径规划和控制部分。
(且听下回分解)