作者 | 张萌宇
在刚刚过去的 CVPR 会议上,作为国内唯一一家被邀请登台演讲的造车新势力,小鹏汽车向参会者介绍了小鹏汽车在国内量产辅助驾驶系统的经验。
作为小鹏汽车最新一代的感知架构,XNet 在量产中发挥的作用不容小觑。
笔者有幸采访到小鹏汽车自动驾驶中心感知首席工程师 Patrick,更进一步得了解 XNet 的性能、架构,以及小鹏的自驾团队为搭建 XNet 所做的努力。
XNet 实现的性能提升
XNet 实现了感知结构的升级,拥有更好的性能,主要包括 3 个方面。
1.1 超强环境感知能力,实时生成「高精地图」
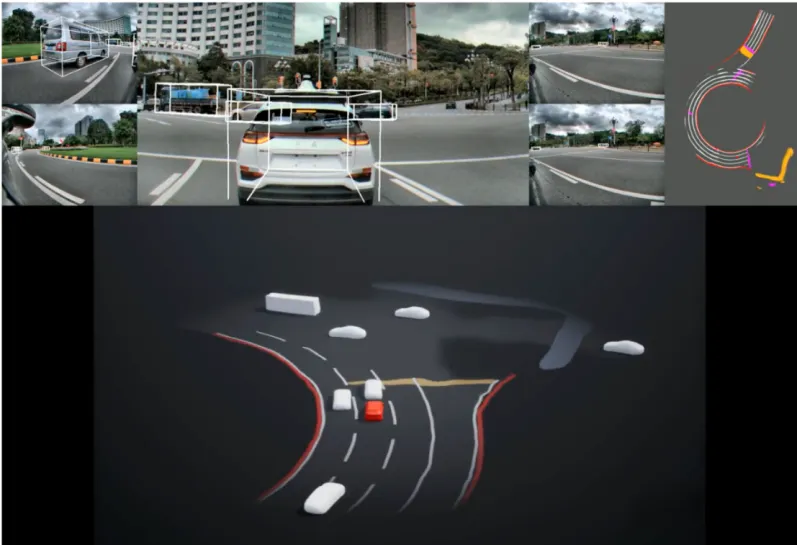
XNet 可以根据周围环境实时构建「高精地图」。从上图我们可以看到,车辆正在经过一个环岛,图中显示的车道线不是来自于高精地图,而是来自于 XNet 的感知输出。XNet 不光可以输出车道线,还有停止线、人行道、可行驶区域等。这是将来小鹏汽车应对无图场景,做高级别城市辅助驾驶的最核心的能力之一。
1.2 更强的 360 度感知,博弈更强、变道成功率更高
在上一代感知架构中,盲区问题很难解决。在最靠近本车的地方,尤其是车辆的下边界,感知系统的检测效果往往不好。XNet 采用多相机多帧、前融合的感知方案,可以根据图像内的车身信息推测车辆在 BEV 视角下的 3D 位置信息,解决了相机上下视野受限的问题;还可以更加有效地同时融合多相机的信息,尤其是分节到两个相机视野中的物体,从而避免盲人摸象式的物体感知。
另外,输入包含时序信息的视频流后,XNet 对近车物体的识别能力有大幅提升,可以更加稳定地检测到近车物体。那么,自动驾驶系统的博弈能力就更强,汽车变道的成功率更高。
1.3 更精准识别动态物体速度和意图,博弈能力大幅提升;运动感知冗余,在城市场景安全性更高
XNet 不仅能够检测物体的位置,还能够检测物体的速度甚至是完成对物体未来运动轨迹的预测。毫米波雷达通常很难检测在本车前横跨车道的车辆的速度,而 XNet 可以很容易地检测到这个速度,对毫米波雷达有明显的增强作用。在毫米波雷达比较擅长的场景,XNet 也可以提供冗余,从而提高城市场景整体的安全度。
XNet 的架构
XNet 为什么可以实现更好的性能呢?Patrick 介绍了 XNet 的具体架构和工作流程。
XNet 采用多相机多帧的方式,把来自每一个相机的视频流,直接注入到一个大模型的深度学习网络里, 进行多帧时序前融合,输出 BEV 视角下的动态目标物的 4D 信息(如车辆,二轮车等的大小、距离、位置及速度、行为预测等),以及静态目标物的 3D 信息(如车道线和马路边缘的位置)。
如下图所示。
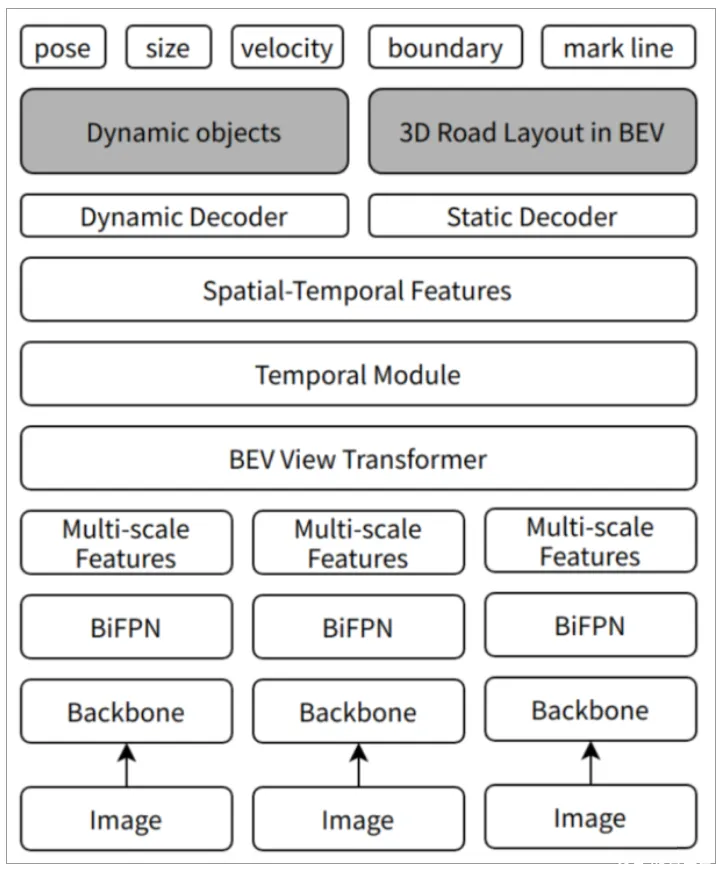
每张输入的摄像头图像经过网络骨干(backbone)和网络颈部(neck,具体来讲是 BiFPN 网络)后生成图像空间的多尺度特征图。
这些特征图经过 XNet 最关键的部分—BEV 视图转换器(BEV view transformer)后,形成 BEV 下的单帧特征图。
不同时刻的单帧特征图在 BEV 视角下,根据自车的位姿进行时空融合,形成 BEV 下的时空特征图。
这些时空特征图是进行 BEV 解码推理的基础,在时空特征图后接两个解码器,完成动态 XNet 和静态 XNet 的结果解码和输出。动态结果包括 pose、size、velocity 等,静态结果包括 boundary、mark line 等。
至此,感知部分基本就完成了。
团队为搭建 XNet 所做的努力
要实现上述架构并不容易,在采集、标注、训练、部署四个方面,小鹏的自驾团队都做了大量的工作来优化整个流程。
3.1 采集
实车数据和仿真数据是数据的两大来源。
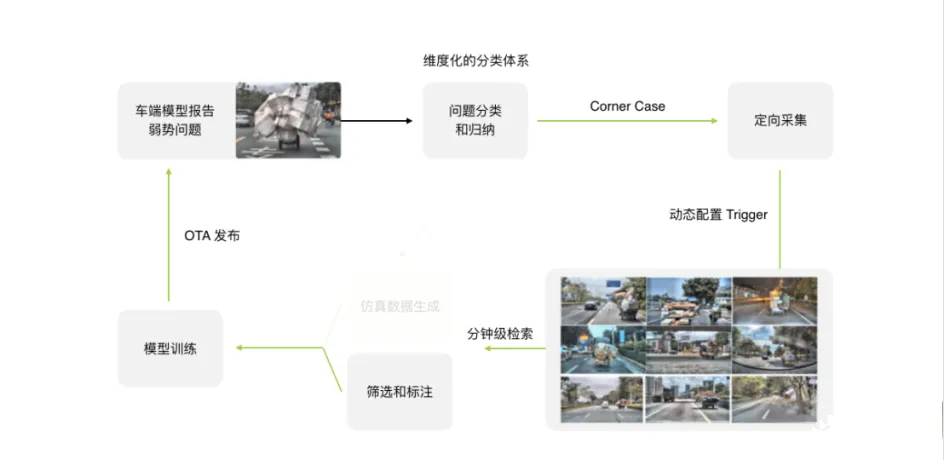
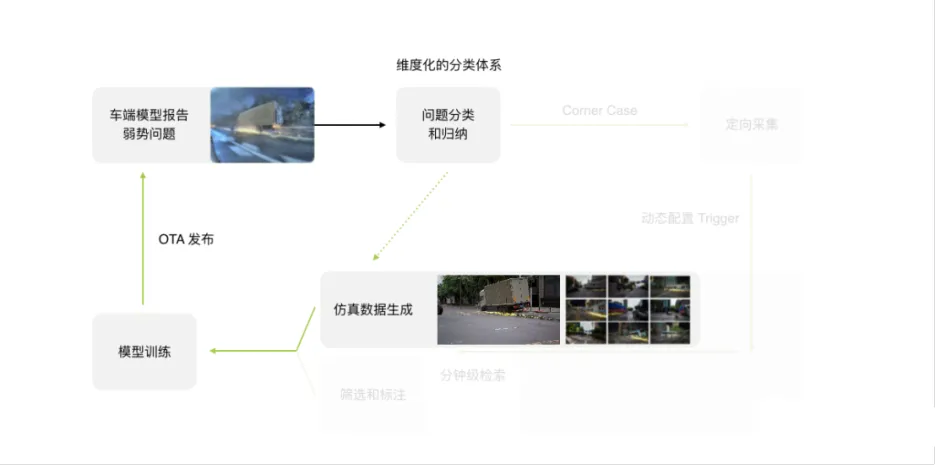
小鹏有接近十万辆用户车,这些车都可以用来完成数据采集的任务。如下图所示,车端模型会报告自动驾驶系统目前处理得不够好的问题,针对这些问题,小鹏的自驾团队会在车端设置相应的触发器来定向采集相应的数据。然后,这些数据会被上传到云端,经过筛选和标注后用于模型训练和后续的 OTA 升级。
此外,仿真数据也是数据的重要来源。吴新宙在 1024 科技日上举了一个例子—行车过程中,前面一辆大卡车因为轮胎脱落与地面摩擦起火,这种情形在实际生活中是极为罕见的。对于这样出现频率极低的情形,实车采集很困难,即使小鹏已经有了近十万辆量产车,收集到足够多的数据可能也需要数年时间。
对于这样的情形,仿真数据可以起到很好的辅助作用。如下图所示,小鹏的自驾团队可以根据实车数据,采用 unreal5 引擎产生成千上万个类似的 case ,模拟各种各样车轮脱落的情形。
当然,仿真数据不能滥用,需要尽可能地贴近现实。小鹏的自驾团队主要从光影真实和场景真实两方面来尽量保证仿真数据的真实性。
小鹏的自驾团队采用了技术上领先的 unreal5 作为渲染引擎,这样通过仿真生成的图片看起来比较真实,没有卡通感,保证了「光影真实」。
此外,生成仿真数据时,是先找到模型的弱势场景,然后对这些场景做数字孪生(digital twin),再在此基础上进行定向修改。具体来说,可以先用 4D 自动标注从真实场景里提取 4D 结构化信息—包括动态物体的 4D 轨迹、和静态场景的 3D 布局等,然后用渲染引擎对结构化信息进行渲染填充,形成仿真图片。这样,生成的场景就是在模拟真实世界可能发生的场景,保证了「场景真实」。
3.2 标注
要训练 XNet,需要 50 万到 100 万个短视频,其中的动态目标的数量可能是数亿级甚至十亿级的。按照当前人工标注的效率,需要 1000 人的团队花两年时间才能完成训练 XNet 所需数据的标注。
小鹏汽车打造了全自动标注系统,此系统的标注效率是人工的近 45000 倍,全自动标注系统仅需 16.7 天就可以完成标注工作。此外,全自动标注系统质量更高,信息更全(包含 3D 位置、尺寸、速度、轨迹等信息),产量更大(峰值日产 30000 clips,相当于 15 个 NuScene 数据集 )。
全自动标注系统是如何做到高效的呢?
首先,从人工标注到自动标注,人的角色发生了很大的变化。人工标注场景下,人是标注员;在自动标注场景下,人是质检员,只是去判别和纠正自动标注系统做的不好的地方,人效会有数量级的提升。
其次,在自动标注场景下,占数据集大多数的训练数据是自动化质检的,只有评测数据集是人工质检,需要人工操作的数据量有数量级的减少。
最后,自动标注让产出瓶颈从人力资源转到了计算资源。在云端,计算资源可以很方便地拓展,可以灵活地按需部署大量资源进行生产。
3.3 训练
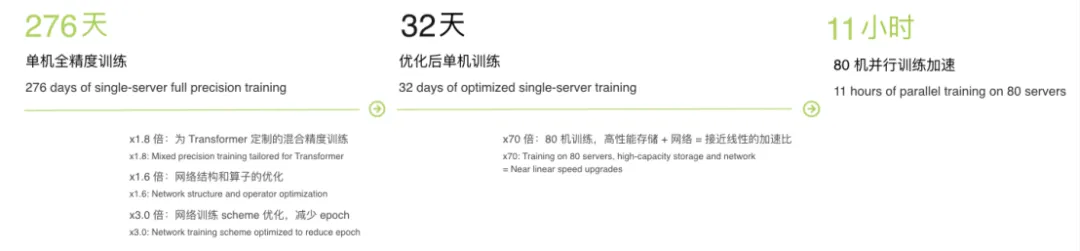
小鹏与阿里云合作打造了中国最大的自动驾驶计算中心—「扶摇」,「扶摇」的算力可达 600PFLOPS,相当于成千上万个 Orin 组成的训练平台。借助扶摇的强大算力,小鹏的自驾团队采用云端大规模多机训练的方式,把 XNet 的训练时间从 276 天缩短到了 11 个小时,实现了 602 倍的训练效率的提升。
如下图所示,假如采用单机全精度方式,训练整个 XNet 需要 276 天。小鹏的自驾团队通过优化训练 scheme 从而减少 epoch、优化网络结构和算子、为 Transformer 定制混合精度训练的方式,将单机训练时间从 276 天缩短到了 32 天。然后,团队充分利用云端算力,将单机训练改为 80 机并行训练,训练时间从 32 天缩短到了 11 小时。
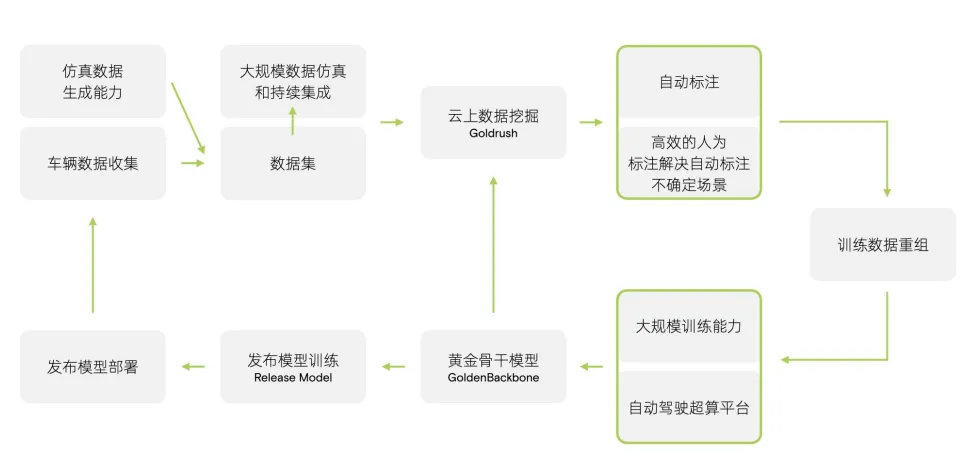
此外,团队引入了 G olden Backbone 模型,将基础网络能力的提升和模型的发布解耦,实现了训练效率的提升。具体来说,如下图所示,Golden Backbone 可以和数据挖掘、自动标注、自动驾驶超算平台等形成一个闭环。在这个环里,只要有持续的数据输入,Golden Backbone 的能力就可以持续地得到优化。需要发布模型的时候,只需在 Golden Backbone 的基础上做一些优化,而无需从头开始训练。
3.4 部署
在部署层面,小鹏的自驾团队有很多积累。经过团队优化后,Transformer 的运算时间减少到了原来的 5%。此外,原本需要 122%的 Orin-X 算力才能运行的模型,现在只需 9%的 Orin-X 算力就能运行。
在部署上,小鹏的自驾团队有哪些亮点呢?根据 Patrick 的介绍,主要是分三步走。
「首先是 Transformers 层的重写。经过对模型板端运行时间的分析,我们发现原版的 Transformers 层占用时长是大头。于是,我们尝试了很多种 Transformers 的变种构建方法,找到了一个模型效果好,在板端运行快的版本。」
「然后是网络骨干的剪枝。我们重写了 Transformers 以后发现,网络骨干(backbone)是我们的性能瓶颈。于是我们对网络骨干进行了剪枝,降低了骨干部分的运行时间。」
「最后是多硬件的协同调度。在我们的基于 Orin-X 的计算平台上,有三种计算单元—GPU、DLA 还有 CPU。这三种硬件对网络的不同算子的支持度各有不同。我们把网络的不同构件放到最适合它运行的地方,然后统一调度三种计算硬件,让三者协同完成网络推理。」