3.1 智驾 SoC 芯片应用趋势
3.1.1 基于中小算力 SoC 芯片的前视一体机市场需求前景依然可观
据相关统计数据显示:2022 年,泊车功能中,360 环视在国内乘用车市场的装配率已经达到 30.87%。然而,行泊一体域控制器的装配率还未达到 10%。从车型价位区间的分布来看,10-15 万价格区间的车型是 360 环视或 APA 功能交付占比最高的市场区间。
对于这样价位区间的车型,如果在改款换代车型上再加装一个前视一体机,便可快速增加行车场景下的智驾功能体验。不少车企把标配前视 ADAS 功能作为中低端车型提升销量的一个重要宣传卖点。
前视一体机方案通常采用软硬件捆绑销售交付的方式,比如 Mobileye ,提供 EyeQ4 芯片+底软+上层感知算法等在内的一体化的「交钥匙」解决方案。 在功能实现上,它 主要用于实现 L0~L1 级别行车场景下的辅助驾驶功能 , 比如 FCW、AEB、ACC、LKA 等。 与前视一体机搭配的解决方案通常有以下几种:1V、1V1R、1V3R 、1V5R 等。
现阶段,2MP 前视一体机价位大概在 500~600 元左右,8MP 前视一体机价位大概在 800 元左右。对于轻量级的行泊一体域控方案,即便成本控制的再好,单域控硬件成本的价格也在千元级别,再加上外围感知传感器,总硬件成本会更高。
虽然,当前基于单 J3、单 TDA4VM、单 A1000L/A1000、J3+TDA4VM,以及双 TDA4VM 等各种方案的轻量级行泊一体域控系统在不断地落地应用,但短时间内他们在成本上依然不具备优势。对于一些车企来讲,对于中低端车型,通过前视一体机搭配不同数量的毫米波雷达,依然是灵活且高性价比的方案选择。
那么,前视一体机对内部集成的主控芯片有哪些要求呢?
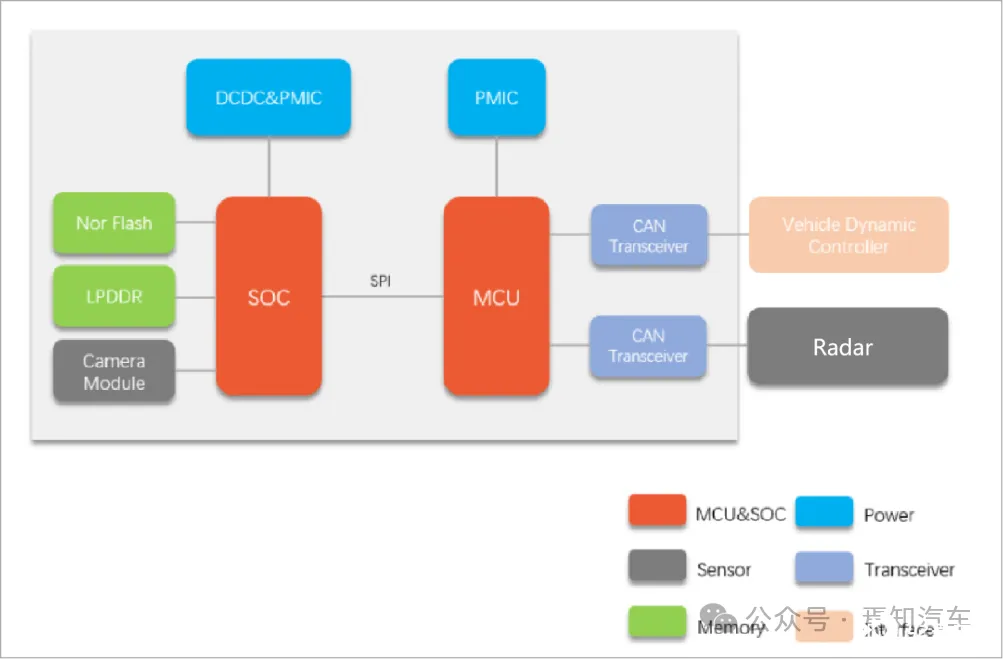
前视一体机即摄像头模组+控制单元 ECU+算法被整合在一起。控制单元 ECU 主板上一般配置 2 颗主控芯片,分别被称之为「安全核」和「性能核」——「安全核」一般选用控制类的 MCU 芯片,负责车辆控制任务,对安全性要求高,需要达到 ASIL-D 等级,但对计算性能要求不高;「性能核」 一般选用计算类的 SoC 芯片,需要承担大量计算任务,但对功能安全要求相对没有那么高。
通常,车企或者 Tier1 在选择「性能核」(SoC 芯片)时会重点考虑的因素:低成本和低功耗。
- 低成本: 通常情况下,ADAS 前视一体机的硬件和软件深度耦合。对于主机厂而言,他们比较关注产品整体的性能和成本。因此其市场定位决定了内部所选用的「性能核」会对成本比较敏感。
- 低功耗: 前视一体机的摄像头模组和主板 ECU 集成在一起,布置在内后视镜的背面。考虑到车内的美观以及安装位置,一体机的外形尺寸也不能太大。这些因素便决定了它对芯片低功耗的强烈需求。低功耗的特性不仅可以避免其长时间工作过程中由热量累积所带来的种种安全隐患,还可以简化散热设计,有效降低电源成本,进而节约整个 BOM 成本。
3.1.2 轻量级行泊一体 域控 - 全时运行 单 SoC 芯片 方案 将成为主流
轻量级行泊一体域控方案主要应用在售价相对较低(15~25 万)的中低端车型,对成本的敏感度较高,比较注重性价比。在功能实现上,它主要用于实现 L1~L2 级别的驾驶辅助功能,即基础行车 ADAS 功能+基础泊车功能(AVM+APA)。功能应用场景相对简单,功能安全要求也相对较低。
目前,该方案所使用的算法模型比较成熟,传感器配置也比较固定,一般采用纯视觉 7V 方案或者带毫米波雷达的 5V3R/5R、6V5R 的多传感器方案。对于域控制器中所选用的主控 SoC 芯片,市场上常见芯片方案有:
- 单 SoC 芯片方案: 单 TDA4VM/TDA4VH 、单 A1000L/A1000、单 Orin-N、单 CV72AQ 等。
- 多 SoC 芯片方案: 双 TDA4VM、双 J3、3*J3、J2/J3+TDA4VM 等。
对于多 SoC 芯片方案,每个 SoC 芯片需要适配独立的 DDR 存储器、PMIC 电源管理模块等配套部件,并且 SoC 芯片之间还需要通过以太网或者 PCIE 等方式进行数据交互,这在一定程度上增加了功耗和系统复杂度。并且,后期的维护成本以及整个系统的 BOM 成本也会随之增加。
正因为上述的一些问题,多 SoC 芯片的域控方案正在逐渐被单 SoC 芯片方案替代。然而,目前单 SoC 芯片轻量级行泊一体方案也存在分时复用单 SoC 和全时运行单 SoC 的区别。
由于某些 SoC 芯片本身的性能局限,比如 CPU 算力或者 AI 算力不足,无法同时调用和处理行车传感器和泊车传感器的全部数据,便会采用分时复用的方式。但是,分时复用的方案可能会导致功能体验不佳,甚至功能无法实现。
比如,要实现 HPA 或 AVP 泊车功能,在进入停车场寻找车位的过程中,仅依靠泊车的环视摄像头和超声波雷达的感知是不够的,需要使用行车的前视摄像头或毫米波雷达来探测远距离目标或微小物体,进行提前避让或绕行,以解决紧急避障的问题。
同样,行车下的某些场景也需要利用泊车的传感器数据进行辅助支持。比如,相邻车道车辆 Cut in 场景,在没有侧视摄像头的情况下,需要利用环视摄像头探测近距离切入车辆,来提高对后车切入预判的准确性。
在上述的这些场景下,需要能够支持行车和泊车传感器同时工作的全时行泊一体方案。分时复用的方案无法胜任上述工作任务。
据业内专业人士测算,如果用单 SoC 芯片去做全时运行的行泊一体方案,并且支持 5V5R 或 6VR 的传感器配置,CPU 的算力大概需要 20KDMIPS 左右,如果带有硬件加速,CPU 算力需求可相应降低;AI 有效算力大约需要十几个 TOPS。
对于全时运行的行泊一体方案,用单 SoC 芯片替代多 SoC 芯片,所需要的不仅是更大的 CPU 算力和 AI 算力。在 SoC 芯片的架构设计方面,还需要:
- 预留足够多的传感器接口,支持足够数量和类型的传感器接入。
- 配置足够容量的各类存储器和内存带宽,保证数据传输和计算效率。
- 预留 PCIE、USB 等用于扩充算力和存储的一些接口,确保整个域控方案的可扩展性。
3.1.3 BEV+Transformer+OCC 驱动智驾 SoC 芯片向新架构方向演进
目前,国内车企在智能驾驶算法领域的技术路径已经逐渐趋于收敛,基于 BEV+ Transformer+ OCC 去实现城市 NOA 已经成为主流的感知算法框架,下一步基本上会朝着感知、预测、规控、决策等一体化的端到端大模型的方向发展。智驾算法不断地迭代升级必将驱动智驾 SoC 芯片的技术架构不断地向前演进。
但是,新的算法模型与传统的芯片架构之间存在着一定的「隔阂」,比如,不少业内人士反映,Transformer 网络在一些智驾 SoC 芯片上很难部署,主要原因在于过去传统端侧的 AI 芯片主要是针对 CNN 网络去设计开发,通用性比较差,对于 Transformer 等较新的算法模型适应性较弱。
Transformer 和 CNN 两者计算类型完全不同。CNN 属于计算密集型网络,整个网络是非常规整的、一层层的卷积操作,每层里若干通道的卷积核作为权重是可以被输入特征共享的存储数据。Transformer 属于访存密集型网络,特点是算法模型里不规则形状的张量多,需要大量矩阵操作的 Transpose/Permute/Reshape 等算子,体现在硬件上就是对片上内存的容量和访存带宽的要求会比以 CNN 为目标的加速芯片高很多。
那么,适应 Transformer 网络模型的芯片的新架构具有哪些特点呢?
1)具有匹配 Transformer 算法模型的专用引擎
传统 AI 推理专用芯片大多针对 CNN/RNN 网络设计, 普遍针对 INT8 精度,几乎不考虑浮点运算,并行计算效果不佳。如果将 Transformer 网络简单量化为 INT8 精度后,整体的性能会显著下降,主要是由于普通的激活函数量化策略无法覆盖全部的取值区间。
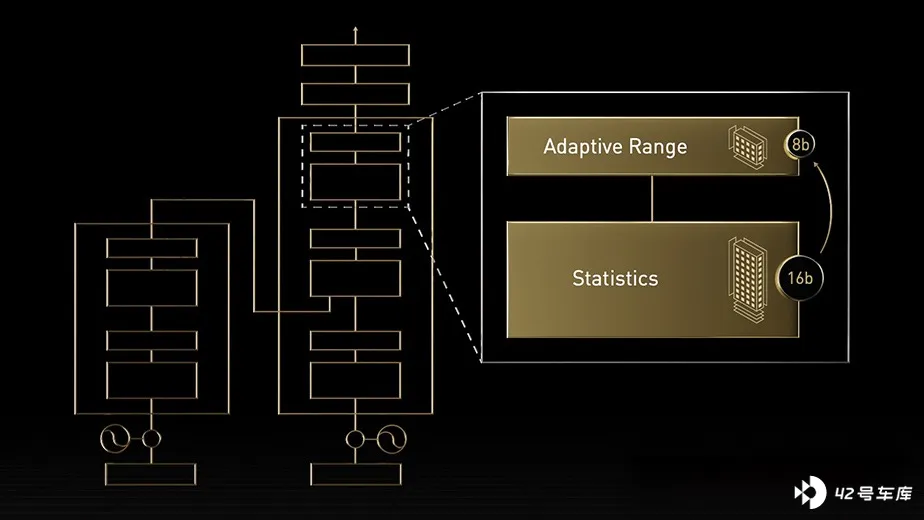
英伟达在设计 GPU 新架构 Hopper 时,专门增加了 Transformer 引擎,即专门为 Transformer 算法做了硬件优化,它集合了新的 Tensor Core、FP8 和 FP16 精度计算,以及 Transformer 神经网络动态处理能力,旨在加速 AI 计算的效率。Transformer 引擎能够在训练神经网络的每个步骤中动态选择神经网络中每一层所需的精度,可以协调动态范围和准确度,比如,可以根据工作负载在 FP8 和 FP16 格式之间进行自动切换,使其在训练模型时,跑的每一步都只用最低精度需求,但又不损失精度的效果,从而达到芯片最高的效率。下一代车载 AI 芯片 Thor 便是采用这样的 GPU 架构。
2)针对特定算子进行优化
设计一款什么算法模型都支持的芯片也不太现实,即便有,成本一定高,研发周期一定长。那么,怎样才能让芯片尽可能多地去支持不同类型的网络呢?某芯片技术专家指出,Transformer 模型的核心算子是 Self-Attention 和 Cross-Attention ,中间包含了一些计算类型,比如矩阵乘法、Softmax 等。首先,要从原理上支持他们中间的各种计算;其次,芯片以及工具链要具备足够的灵活性,后期便可以通过修改调整工具链,使得芯片在计算效率不下降的情况下去支持新的算法。
另外,网络模型的核心计算的地方集中在一些反反复复进行特定计算的操作上。正因为如此,才可以通过设计专门的芯片去提高效率。如果整个网络都是乱序的,那么,专用处理器就没法设计,只能做通用处理器了。
比如针对 J6 芯片,地平线在硬件上了做了大量的超越函数的优化工作,比如支持 Layer-norm&Softmax 算子的硬件加速;支持 Transpose&Reshape 算子的硬件加速。Transformer 模型中有一些非常关键的算子,虽然计算量不大,但很复杂。也就是说,计算量可能只占 3%的算子,运行时间可能要占到 10%~30%。因此,地平线通过对硬件进行优化,使得 J6 在运行这些超越函数算子的时候,计算效率得到大幅度提升。
3)优化内存系统设计,打破「存储墙」,避免带宽成为计算瓶颈
目前,主流车载 SoC 芯片的架构仍然沿用了传统的冯·诺依曼模型。 在冯·诺依曼架构中,数据存储单元与数据处理单元两者相互分离。数据在处理过程将会 在 处理器与存储器之间不断地进行「搬运」。
据相关数据显示,处理器性能以每 2 年 3.1 倍的速度增长,而内存性能以每 2 年 1.4 倍的速度提升。 计算能力与带宽能力之间的差距将会越拉越大, 这就导致芯片的 内存容量和数据传输速度难以跟上芯片的计算速度。 因此,车载 SoC 的性能与效率的发挥将受到严重制约,进而出现「存储墙」问题。
以 Transformer 架构为基础的 AI 大模型导致了模型参数量激增,短短两年间模型大小扩大了惊人的 410 倍,运算量更是激增了高达 750 倍。虽然现阶段基于 Transformer 架构的真正大模型还很难「上车」,但是,相比 CNN 模型,已经上车的 Transformer 模型参数也要更多,算子复杂度更高,需要的运算量更大。因此,Transformer 网络对于车载 SoC 芯片内部 SRAM 的利用率,以及内部总线突发大带宽访问等方面提出了更高的要求。
那么,头部的芯片企业又是如何应对这些问题的呢?
- 地平线 J6 内部采用全新的存储系统设计,片上包括 L0M、L1M、L2M,共三级存储系统,用于数据缓冲和交换。同时,先进的总线架构配合高带宽的 DDR,可有效缓解内存墙的问题。
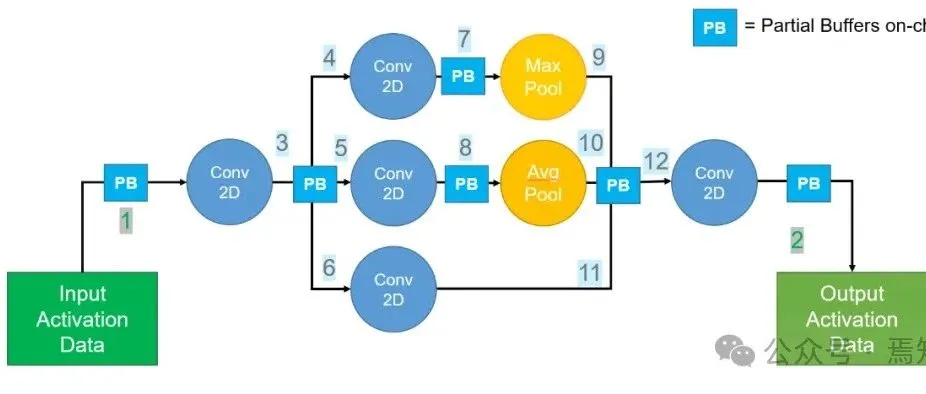
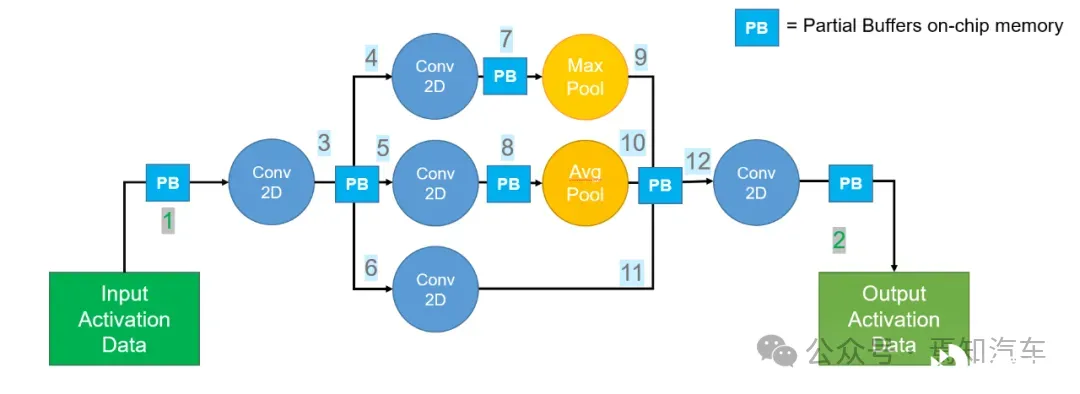
- 在 AI 加速器的架构设计上,安霸的 CV3 系列芯片推出了第三代 CVflow 架构。与传统的缓存系统不同,CVflow 架构采取了一种创新的策略,将片上内存(On-chip Memory)分割成多个不同大小的内存块,这些内存块被称为 Partial Buffers(PB)。这些 PB 的主要用途是存储计算过程中的中间结果,从而显著减少对外部 DRAM 的访问次数。
3.2 座舱 SoC 芯片应用趋势
智能座舱是车企打造差异化亮点、实现千人千面驾乘体验的重点领域。「一芯多屏」、「多模态交互」、「舱驾融合」已经成为座舱主流应用发展趋势。然而,在智能座舱中,主控 SoC 芯片是实现车载中控娱乐系统、液晶仪表系统、AUD 抬头显示系统、流媒体显示系统、空调面板显示系统、车联网系统、语音交互、手势识别、DMS/OMS、AVM 等一些列功能的「基石」。
3.2.1 舱内显示:一芯多屏
在传统座舱解决方案中,中控导航、仪表、HUD 等系统相互独立,分别由独立的 ECU 来控制,即单 ECU 驱动单个功能/系统。随着座舱集成化程度越来越高,原先跟座舱相关的分布式 ECU 整合成为 1 个座舱域控制器。最直观的表现是「一芯多屏」,即由座舱域控制器中的单个高性能 SoC 芯片来驱动中控导航屏、液晶仪表屏、HUD、空调显示面板、副驾娱乐屏以及后排娱乐屏等多个屏幕。
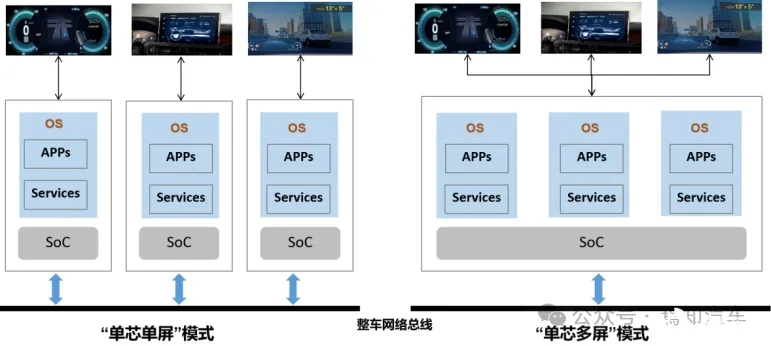
「一芯多屏」方案对 SoC 芯片的要求在于:具备足够多的 DP 或 DSI 接口,能够同时驱动若干个不同的显示设备;CPU 能力要求比较强,保障不同设备上多个 APP 同时运行时的流畅度;GPU 的图形处理能力,视频的编解码能力要求高,它们决定了屏幕显示的清晰度以及动画效果的流畅度;另外,硬件层面需要能较好的支持 Hypervisor 或硬件隔离,从而更好地支持多系统运行。
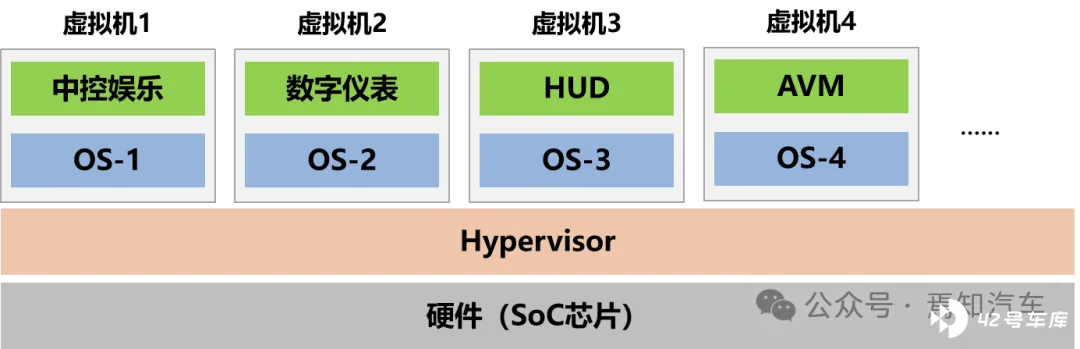
目前,在同一的硬件平台上运行多个操作方式,通常有两种解决方案:Hypervisor 和 硬隔离。采用 Hypervisor 的技术方案,在理论上是可以让上层的应用灵活调用底层的硬件资源,可以使得硬件资源得到充分的利用。而硬隔离的方式给每个模块划分出自己固有的硬件资源,虽然灵活性不足,但优势在于资源使用环节不会产生「纠纷」,并且各个系统运行的安全性也更有保障。
3.2.2 舱内交互:多模态交互
在智能化座舱阶段,舱内的感知交互手段更加智能化和多样化。不再局限于传统座舱内物理按键类的触觉交互,增加了语音交互、手势控制以及视觉交互(DMS/OMS)等交互方式,通过融合多模态的信息来增强感知能力,进而保障交互反馈的准确性,以及带来更人性化的交互体验。
对于驾驶员侧,采用 DMS、语音交互以及手势控制等多种感知交互方式,来监测驾驶员的状态和降低驾驶员手眼负担,有助于防止疲劳驾驶,以及在驾驶员疲劳时能够及时进行危险提醒。
对于副驾及后排乘客,主要是通过 OMS、语音交互及手势控制等感知交互方式,来满足乘客在座舱内的休闲、娱乐需求。
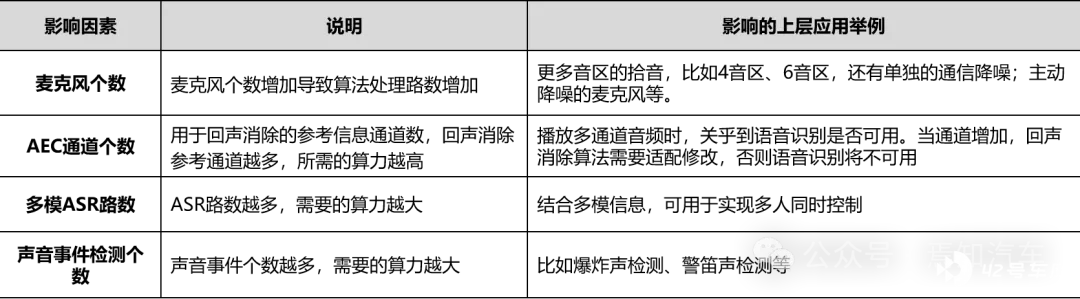
1) 语音交互: 从技术维度来讲,语音交互分为语音前端处理技术和语音后端处理技术。前端处理技术包括 VAD(语音活动检测)、回声消除、噪声抑制、声源定位、增益控制等;后端处理技术则包括语音识别、语义理解、对话管理、语音合成等。另外,在智能座舱中,语音交互主要应用在车身相关模块(空调、座椅、车窗)的控制以及中控娱乐相关模块(影音娱乐、导航、通讯等应用)的控制。
2) 视觉交互: 目前座舱内基于摄像头实现的视觉交互功能有:DMS、OMS 和手势控制等。最开始,DMS/OMS 通常使用独立的 ECU 控制单元,但是随着整车 EE 架构的演进以及 AI 芯片集成化发展,座舱域控制器中的主控 SoC 芯片中一般都配置有丰富的异构资源,并且能够支持多通道的视频输入和处理能力。因此,DMS/OMS 功能开始逐渐被整合到智能座舱域控制器中去实现。这样不但可以节省一定的硬件 BOM 成本,也便于 DMS/OMS 系统与座舱内其它关联模块更好地进行信息交互,从而更好地进行功能融合创新。
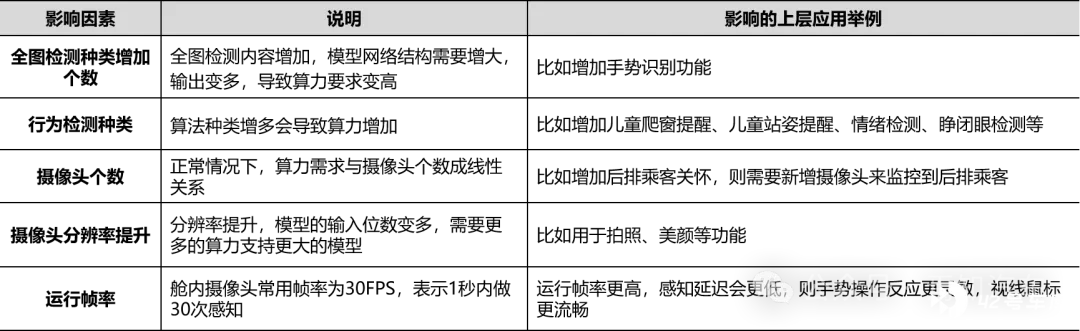
当前,人们对于汽车的「价值理解」也正在从单纯的出行工具向「第三生活空间」转变,而智能座舱是实现此「第三空间」塑造的核心载体。伴随着 5G、AI 大模型、大数据等技术的发展,座舱内的人机交互方式变得更加的多样化和智能化。对于主控 SoC 芯片而言,座舱内每增加一种人机交互的方式,对芯片算力和性能的需求都会进一步提升。
3.2.3 舱驾融合:舱驾一体
在座舱相关功能不断地被整合的过程中,座舱与 ADAS 功能也开始逐渐融合。最开始是环视摄像头接入到车机系统来实现 AVM 功能;然后,环视摄像头和超声波雷达同时接入到座舱域控制器,由座舱来实现 AVM 以及 APA 等泊车功能的控制,即所谓的「舱泊一体」。
智能座舱整合基础的泊车功能有以下几点好处:一是,可以降本,至少可以把原来泊车的控制器省掉,节省一定的物料成本;二是,有利于更好地做泊车场景下的人机交互设计;三是,座舱主控 SoC 芯片上的算力也能得到最大程度的有效利用。
再往后发展,智能座舱将进一步整合 L2 级别的行车 ADAS 功能,甚至是更高阶的自动驾驶功能,即所谓的「舱驾一体」。从「舱驾一体」的实现形式上来看,主要有三种:One Box、One Board 和 One Chip。特斯拉采用了 One Box 的方案,并在 2019 年实现量产。One Board 和 One Chip 的方案也有相关企业正在规划,据透露,One Chip 的方案可能将会在 2025 年左右量产。
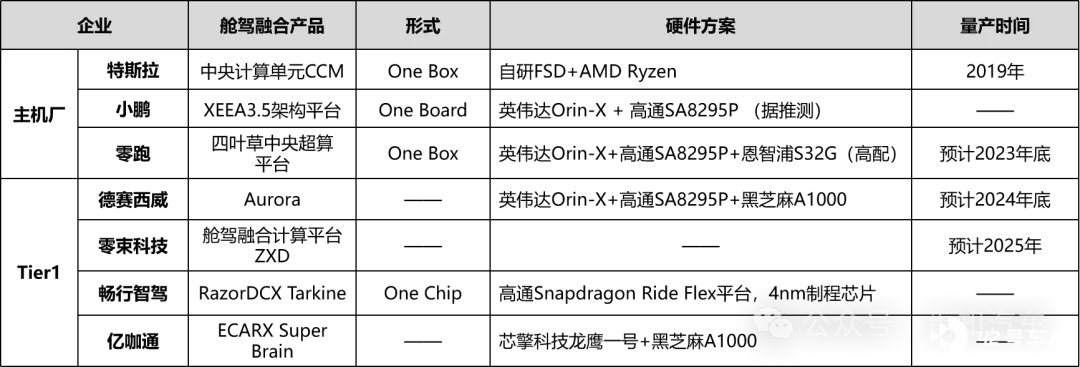
多数业内人士一致认为,One Chip 方案才是真正的「舱驾一体」,能够帮助企业实现降本增效。整体来看, 舱驾一体的主要优势表现在:
- 系统成本更优: 在硬件层面,相比于多 SoC 方案,单 SoC 芯片方案集成度更高,使用物料更少,在一定程度上节省了 BOM 成本;在软件层面,所有软件都在统一的软件架构下,能够节约开发验证和功能扩展成本。
- 系统响应更快: 相比板间的 Switch 通讯或芯片间的 PCIE 互联,在芯片内部直接使用内存共享的片内通讯方式,通讯时延会更短,系统响应更快。
- OTA 升级更容易: 舱驾融合后,平台的集成度更高,软件合理分层分区,有利于新功能的部署和更新。
3.3 车载 SoC 芯片选型
芯片的选型与感知硬件、软件算法架构等因素强相关,它决定了选择芯片时所需要考虑的客观要素,比如性能,成本等。除此之外,一些「主观要素」也很重要,它在一定程度上决定了这颗芯片在量产上车后能够带来多少「隐性」价值,比如,芯片平台的延续性、芯片的适配性、芯片的平台化设计、芯片的软件生态、芯片厂商的本土化服务等。
1) 芯片 平台的延续性
选择使用一家芯片厂商的芯片,车企不但会看它的现在,还要看它的未来。如果芯片企业只做一两代的芯片,而没有连续的 Roadmap,那就意味 着如果车企围绕该芯片来做域控制器,那么,他们后续产品的迭代和升级会存在很大的不确定性。
一款芯片产品从定义到研发再到量产,至少需要 3 年左右的时间。一旦进入 车企的供应链体系,车企基本会稳定在 3~4 年的订单需求。对于 车企来讲,一旦选定一家芯片厂商,中间再切换芯片厂商,代价会比较大,除非出现重大问题,否则不会轻易去切换。
因此,车企在进行芯片选型的时候,还会关注芯片公司整个产品的迭代周期和产品的设计思路 —— 是否符合产品的应用趋势方向,以及是否匹配自身的产品线需求,这样才能够尽量规避后期因切换芯片平台而导致成本大幅增加的风险。
2) 芯片的适配性
整体来讲,车载 SoC 芯片的适配性可以从硬件、软件以及通讯三个层面去考察。在硬件层面,芯片的适配性包括传感器的适配,配套外围电路的适配,例如存储芯片(如 LPDDR、NOR Flash)、通信芯片(如以太网交换芯片)、音视频数据接口以及相关处理芯片(如解串行芯片)等等;软件层面,芯片的适配性包括与底软、中间件以及上层算法层面的适配;通讯层面,主要是芯片与总线的适配,涉及到 CAN、以太网等总线,即芯片和其它组件之间的通信和数据交换是否 匹配。
总之,芯片的适配性的好坏,最终的判断依据是芯片与其它系统组件是否能够很好地协作并达到预设的目标效果。
3)芯片的平台化设计
芯片厂商发展到一定阶段,在充分了解主机厂的需求后,为了降本增效以进一步提升产品的核心竞争力,必然会去打造出自己的平台化方案,用平台化的方案去适配和兼容客户的差异化需求。
某域控制器 Tier1 硬件平台专家曾对外透露,他们最开始是用不同的 SoC 和 MCU 芯片去为各家主机厂服务。但经过一两个项目,他们发现每家主机厂的需求都不一样,用不同的芯片去匹配,研发成本太高。后来,他们干脆就深入研究一个系列的 SoC 芯片,用他们去灵活匹配不同主机厂的项目,即使个别项目拿不下或者不赚钱,但整体来看,他们收益 却大大增加,成本也趋向最小化,并且在行业内还形成了自己的口碑。
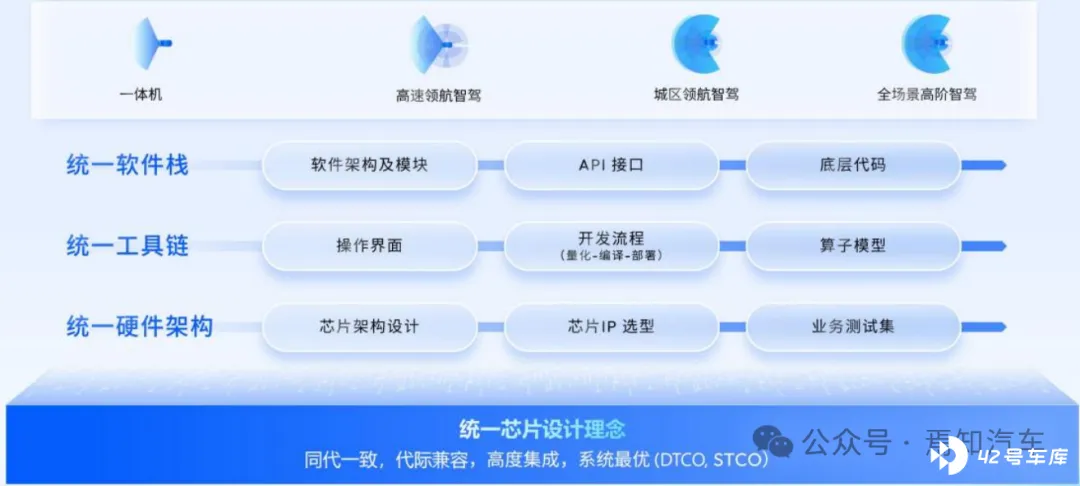
这个案例间接说明,是否具备较好的平台化设计方案,在后期也将是芯片厂商的核心竞争力之一。比如,地平线的最新一代征程 6 系列芯片,便是采用了平台化的设计 —— 面向从低到高的全阶智能驾驶场景,征程 6 基于平台化设计 理念,秉持同代一致、代际兼容、高度集成、系统最优( DTCO,STCO)等理念,使其具备统一的软硬件技术特性,包括统一硬件架构、统一工具链和统一软件栈 。平台化系列的计算平台方案,有助于缩短智驾系统开发周期,打造系统成本更优的智能驾驶方案。
4)芯片的软件生态
「软件生态决定芯片价值大小」,已经成为了芯片行业的共识。因为构建在芯片之上的软件生态对芯片的「可用性」具有较大的影响。如果一家 AI 芯片企业具备软件生态优势,意味着客户在其芯片上面做开发,周期会更短,成本会更低。
AI 开发套件是软件生态里比较重要的一部分,通常包括算子库、AI 工具链等。一家芯片厂商的算子库丰富,并且工具链好用,这家企业的芯片才有可能「好用」。 例如,英伟达是公认的具有强大软件生态的企业,它的软件生态包含了软件开发者、上层应用软件、丰富的工具和库等 。良好的芯片软件生态通常具备如下特点:
- 易用性 ——软件生态要能支撑好合作伙伴和客户的开发所需,应用文档要充分完善,参考设计和代码丰富准确,有相应的社区或者足够详细的指导文档能帮助用户自行快速上手。最大限度的降低用户的学习成本和业务的迁徙代价。
- 兼容性 ——需要一个长期稳定的软件框架和接口,能够尽可能的做到向下兼容,帮助用户的存量代码的价值在后续芯片的升级时也能得到继承。
5)芯片厂商的 本土化服务
在软件定义汽车背景下,外加「内卷」严重的竞争环境,汽车的研发周期一再压缩,以前 3~4 年的开发周期,甚至已经被压缩到 2 年。在较短的开发周期下, 车企在芯片上车量产的过程中,必将会遇到很多跟芯片底层相关的问题,无论是硬件设计,还是软件开发、图像优化,亦或者是算法移植等方面的问题。此时,芯片公司是否具备足够大的团队以及足够强的工程化能力,去帮助客户在本地快速地解决问题就显得尤为重要。
芯片厂商需要密切加强与车企之间的合作和交流,增强对下游客户的服务支持力度,帮助其客户在相对较短的研发周期内做好高质量的产品交付工作。
往期推荐:
车载 SoC 芯片产业分析报告(一):车载 SoC 芯片基本介绍
车载 SoC 芯片产业分析报告(二):车载 SoC 芯片产业链分析
下一篇: 4。车载 SoC 芯片行业竞争格局,欢迎关注。