作者: 山丘
随着智能驾驶系统逐步从辅助驾驶向高级自动驾驶演进,原有基于 OrinX/OrinN 等中低算力芯片的域控制器方案逐渐难以满足更高阶功能对算力、实时性和系统集成度的要求。随着 Thor 等高阶 SoC 平台的引入,为舱驾一体的系统架构提供了强大的算力基础和融合能力。当前根据最新公开信息,包括理想、极氪、比亚迪、小鹏、广汽埃安几家主机厂已明确宣布将在其下一代车型中采用 NVIDIA DRIVE Thor 平台。
然而,直接将原有低阶域控的智能驾驶算法无缝移植到新平台并不可行,面临着硬件架构差异、计算资源调度模型不同、软件底层驱动兼容性、算子库适配等诸多挑战。本文综述了算法迁移面临的关键技术难点,并从算法解耦、算子优化、计算调度、资源复用、系统联调等多个方面给出相应的适配与优化策略,为工程实践提供参考。
当前,汽车行业正在加速从传统分布式 ECU 架构向中央集中式计算平台演进。OrinX/OrinN 芯片在过去几年中支撑了大量 L2-L2+智能驾驶功能,但随着主机厂向 L2++乃至 L3、L4 能力迈进,系统对算力的需求指数级提升。Thor 平台作为 NVIDIA 推出的新一代高阶自动驾驶芯片,不仅在算力层面提供 8 倍以上提升,同时具备更强的异构多核调度能力、支持更多传感器接入、更强的舱驾协同处理能力。
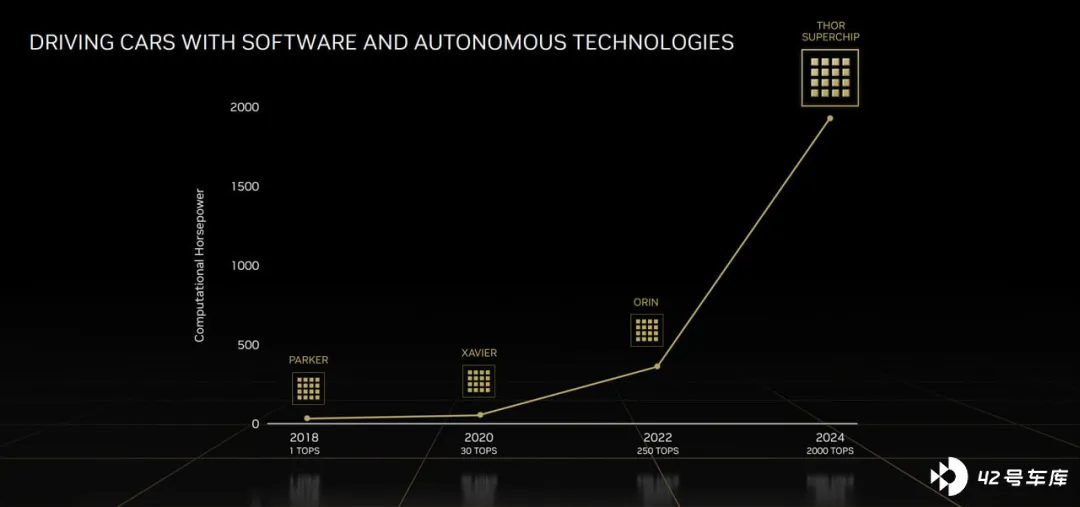
但与此同时,Thor 内部的计算核心布局(如 CPU/GPU/DLA/加速器)和底层驱动接口与 Orin 平台存在显著差异,导致原先在 Orin 上高度优化的算法链路在 Thor 上无法有效运行,甚至存在推理效率下降、内存带宽瓶颈、接口不兼容等问题。
因此,本文围绕这一迁移过程中的关键挑战与对策展开综述分析。
1、Thor 平台硬件架构简析
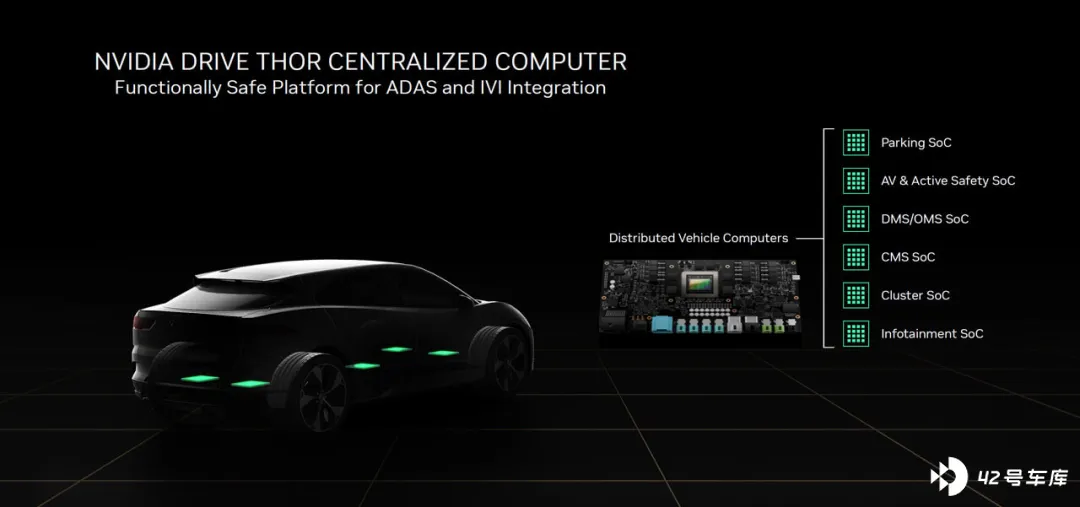
Thor 平台相比 Orin 系列具备更强的异构计算资源,通过集成更多高性能 CPU 内核(如 Arm Neoverse)、新一代 GPU 架构、DLA 升级模块,具备对 AI 推理与通用计算任务更高并发处理能力。同时,Thor 还具备统一存储访问架构,这种更高带宽的共享内存总线设计,对缓存一致性要求更高,影响调度策略。此外,Thor 还具备很强的扩展性与多域融合,更强的舱驾一体调度能力,支持多操作系统并行运行,适配多个功能域(感知/决策/娱乐/人机交互等)。
2、算法迁移的关键挑战
如上所属,基于不同芯片平台的算法迁移并非简单的软件系统由 Orin 向 Thor 迁移并非简单的重编译与部署过程。他涉及如下一些算法迁移的关键挑战。
2.1、算子不兼容
在深度学习中,“算子”(Operator)是指构成神经网络的基本运算单元,比如卷积(Convolution)、池化(Pooling)、激活函数(ReLU、Sigmoid)、批归一化(BatchNorm) 等。在部署阶段,这些算子会由推理引擎(比如 NVIDIA TensorRT)转换为适合特定硬件执行的形式。
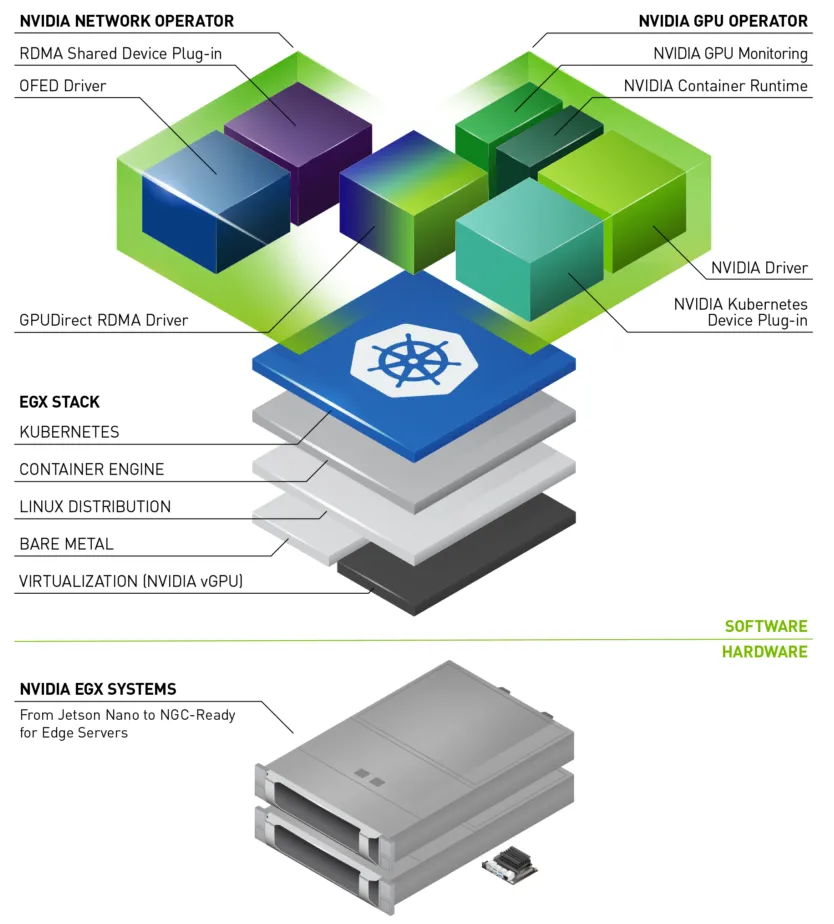
那么,这里的“算子不兼容”具体指什么呢?
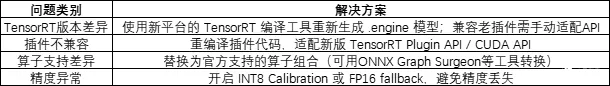
首先, TensorRT 版本差异 。 Orin 平台上部署的算法可能使用的是 TensorRT 8.x 版本,而 Thor 平台可能默认采用 TensorRT 9.x 或更新的版本,新版本可能废弃了部分老旧算子或修改了算子的参数定义、行为模式,结果是相同模型在新平台上可能加载失败、输出不同或运行效率下降。
其次, 自定义插件算子(Plugin)失效 。 在 Orin 上开发者常会使用自定义的插件(C++ 实现的特殊算子,如 Deformable Convolution、NMS 变种等),这些插件往往依赖底层 CUDA API、cuDNN API 或 TensorRT PluginRegistry,在 Thor 平台上,这些 API 版本和注册机制可能变动,导致原插件不能被加载或执行异常。
这里举个例子,比如你在 Orin 上用的 YOLOv5 模型中用了 custom grid plugin 和 sigmoid fused plugin ,在 Thor 上这些插件无法被识别,模型构建就会失败。这时就需要重新适配插件代码,甚至更换为新版结构。
同时 , 不同硬件单元的算子支持差异 。 Orin 上某些算子可以很好地在 DLA 或 GPU 上运行,但 Thor 平台可能调整了 DLA 支持的算子集(比如新增 FP8 支持,但减少某些 INT8 或自定义 ops 支持)。导致算子调度路径不同,从 DLA 切换到了 GPU,反而性能下降。
因此,从原 Orin 平台上依赖特定 TensorRT 版本或自定义插件的算子,在 Thor 平台上可能缺失或行为不一致。具体的表现为模型无法加载,报错 Unsupported Layer type: xyz 。推理结果数值异常或精度下降,导致整体性能下降,比如推理延迟上升、DLA 无法利用。Plugin 注册失败,报错 plugin not found 或 Segmentation fault 。
为了解决以上算子不兼容的问题,我们可以采用如下一些措施进行:
2.2、内存访问瓶颈
Thor 平台的内存系统特点主要是指 Thor 作为高阶 SoC,其硬件架构相比 Orin 有明显不同,尤其在内存访问方面具有如下特征。
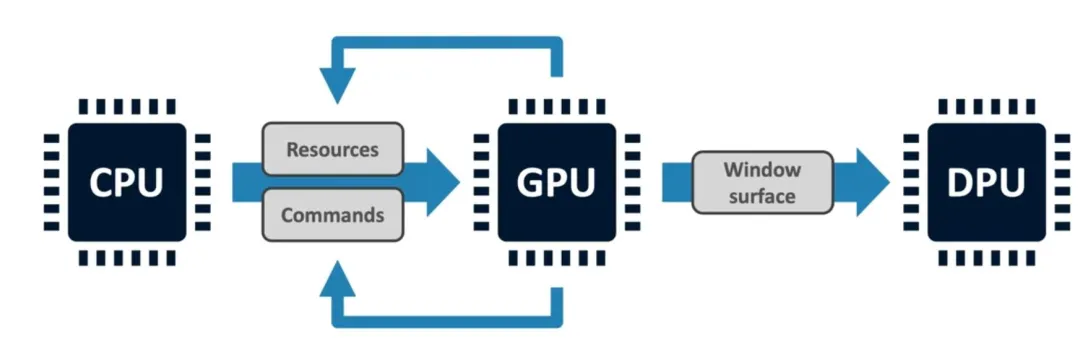
首先是 高带宽共享内存架构 。Thor 提供统一内存架构(Unified Memory Architecture),GPU、CPU、DLA、ISP 等模块共享内存池。内存总线支持更高并发,但共享访问本身存在冲突风险。
其次是 多核异构并行执行 。Thor 支持多个异构计算单元(如多个 CPU 核 + GPU SM + DLA 核)并发运行算法模块。不同模块可能并行访问同一数据块或带宽通路,容易造成带宽抢占(Bandwidth Contention)。
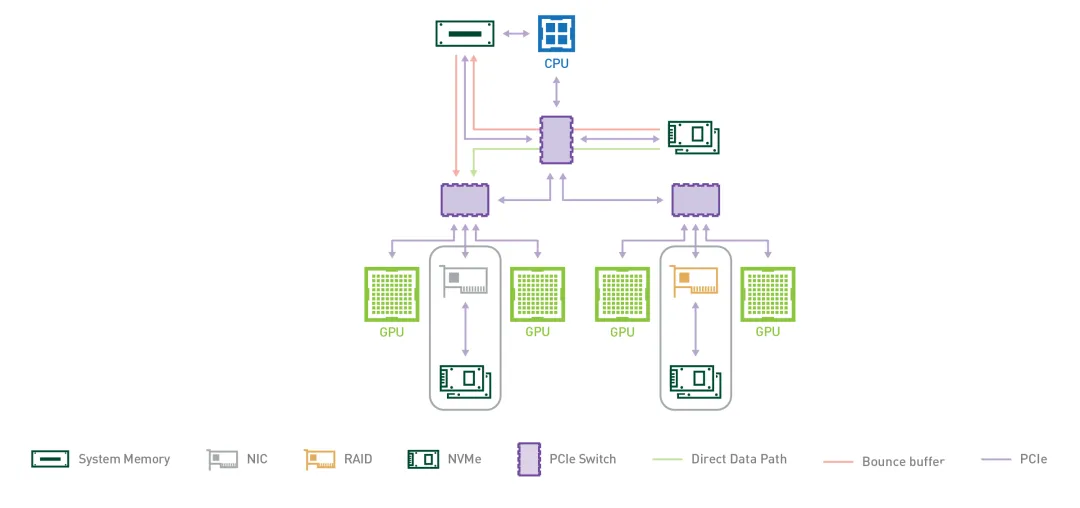
那么,“带宽争用”有哪些实际表现呢?
首先,推理时延抖动明显。特别是在多路模型同时运行(如感知+舱内语音识别)时,原本稳定的推理延时波动明显。其次,内存访问异常导致缓存失效率高。原来依赖 L2/L3 缓存的模块,在新平台上缓存命中率下降,导致频繁访问主存(dram),加剧延时。其次,上下游模块管线不同步。比如感知模型输出大尺寸特征图,同时 Fusion 模块尝试读取,造成内存阻塞。
因此,十分有必要“重新评估内存访问模式”。
在 Orin 上,很多开发者可能已经针对单核 GPU + 较少核 CPU/DLA 进行了优化,比如使用 TensorRT 时默认将中间张量常驻 GPU 显存,手动固定了某些任务的 NUMA 节点或预加载到了 L2 cache,控制了 batch size 与中间 feature map 的内存 footprint。
然而,Thor 上的内存使用格局不同主要体现在,并行计算单元异构资源大幅增加(多个 DLA/GPU 子核等)。相较于 Orin 平台在内存访问方式上通常采用分层访问不同,thor 平台的多模块可能同时抢占同一内存总线。其通信机制也与 Orin 平台的单一 pipeline 为主不同,而是多任务并发协同,如感知/舱内/娱乐共享 DDR。
这里举个例子进行说明,假设你有一个多分支 YOLO 感知网络在 Orin 上运行良好。输入 → Backbone → Neck → 多头 → NMS。在 Thor 上你同时运行:感知 YOLO + 舱内 gaze detection + 多线程 logging。此时,YOLO 的 Neck 和 NMS 阶段频繁访问主存张量,与其他任务抢占 DDR 带宽,导致帧处理从 35ms 上升到 60ms,模型失速。
解决策略是可以进行数据访问局部性优化。调整模型内部数据布局,使得中间张量连续存储,提升缓存命中率。可以采用任务绑定(Affinity)与带宽隔离,为 DLA/GPU/CPU 不同任务绑定核心与分区内存块,采用 NUMA-aware 内存管理。也可以使用共享内存与内存池管理器,针对频繁访问的数据,尽量使用共享内存(如 TensorRT 中的显式 memory binding),使用内存池复用中间张量,避免重复分配/释放。借助一定的分析工具辅助调优,比如使用 NVIDIA Nsight Systems、nvprof、perfetto 等工具监控 memory bandwidth 和 L2 hit rate。
因此,Thor 平台的多核调度与高带宽内存架构需要算法重新评估内存访问模式,避免带宽争用。
2.3、推理性能可能不升反降
有人肯定非常疑惑,为什么“原有模型”在 Thor 上未必更快?
原有模型参数在 Thor 架构下的缓存命中率、线程并行度未调优,导致性能下降。尽管 Thor 平台提供更高的理论算力,但原有模型在新平台上未必获得线性性能提升,甚至出现推理延迟上升的情况。其主要原因包括:
2.3.1、缓存访问模式未优化
原模型在 Thor 架构下的缓存访问模式未优化,导致 L1/L2/L3 缓存命中率下降。Thor 的硬件资源虽强,但并不意味着无需调整模型配置就能获得更高推理速度,因为缓存层级结构不同,Thor 的 L1/L2/L3 缓存架构和大小与 Orin 有显著差异,且其共享缓存更依赖合理的数据布局。原始模型若未针对 Thor 的数据流特性(如连续访问、按通道展开等)做适配,中间张量反而更容易导致 cache miss。
2.3.2、并行策略不匹配
Thor 的多核调度机制与原有线程并行策略不匹配,存在计算资源空转或任务竞争现象。Thor 线程调度并发策略可能未匹配。Thor 平台具有更多 CPU 核心和并发执行单元,若模型运行时仍使用默认的线程绑定策略(例如 TensorRT 默认线程数),则无法充分利用硬件能力,甚至会发生线程调度冲突或资源空转。
2.3.3、共享显存结构未对齐
Orin 这些就平台中间张量的内存布局与新平台的共享显存结构未对齐,会造成频繁访存和带宽瓶颈。还有,Thor 平台的张量分布和显存带宽未调优。如果原模型的参数分布、batch size 或中间 feature map 大小未根据新平台的显存访问结构优化,可能导致显存访问效率下降,进而影响整体推理吞吐。比如,有时候同一模型在 Orin 上可跑到 40 FPS,在 Thor 上只有 30 FPS。使用 nvprof 或 Nsight 查看,发现 GPU 的 SM 利用率反而下降,memory throughput 未提升。此时,在 Thor 上的多线程 CPU 任务调度出现阻塞或核使用率不均匀。
基于如上分析,算法迁移过程中需重视模型的并行度配置、缓存感知调度策略与数据访问连续性优化,否则即便平台算力提升,实际系统性能仍可能下降。
2.4、多任务调度干扰
在舱驾一体的架构下,一个 SoC 平台(如 Thor)不仅需要承担**智能驾驶(智驾)任务,还要同时处理座舱域(IVI/HMI)**的显示渲染、语音识别、娱乐系统、多屏交互等大量并发任务。这些任务都在共享的计算资源(CPU/GPU/内存总线等)上运行,如果没有有效的调度机制或资源隔离策略,就可能发生如下情况:
- 显示渲染任务高峰时占满 GPU,导致感知模型无法按时完成推理;
- 非实时的座舱任务误占高优先级核资源,引起自动驾驶控制延迟;
- 总线带宽冲突,造成高频访问的数据无法及时加载,影响系统稳定性。
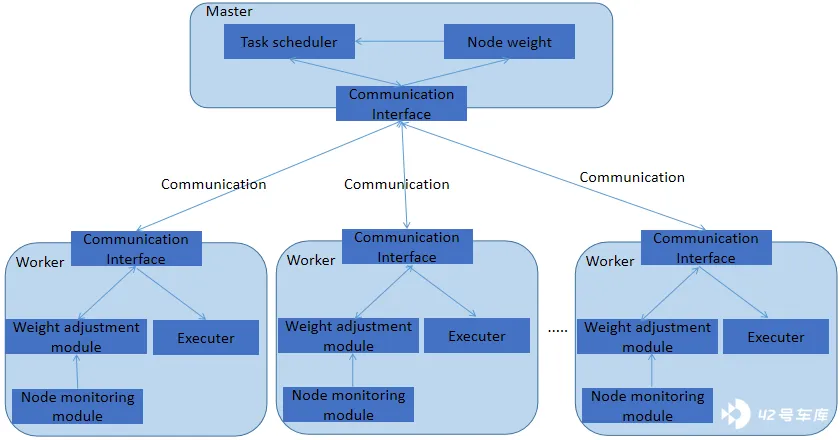
因此,舱驾一体架构下多任务系统干扰较大,算法调度不当可能导致关键实时任务响应延迟,导致实时性下降。
比如,Thor 支持异构多核(如实时核与通用核),若关键任务未绑定到实时核或低优先级任务无控制地抢占资源,会引发延迟抖动。Thor 中的感知模型可能与舱内图像渲染、视频播放任务共享 GPU 资源,即造成 GPU/加速器任务堆积。若没有合理调度机制(如 CUDA stream 优先级、TensorRT QoS),关键路径延迟显著升高。系统若运行多个容器或进程,每个都有独立线程池,会发生线程抢占和上下文切换频繁,严重影响延迟敏感任务的响应时间。
例如,GPU 资源被中控 UI 渲染占用,或总线带宽被非关键数据传输抢占,均可能导致智驾算法响应超时,影响行车安全。
3、Thor 中算法部署的适配与优化策略
基于前序说明的算法移植部署策略短板,我们可以整合一个从低阶 Orin 平台向高阶 Thor 做算法迁移的完整方案。

首先,可以通过将原有强耦合的感知/融合/控制模块重构为更松耦合的异步处理模块,便于分派至不同核资源。结合 Thor 平台支持的最新 TensorRT 版本与 DLA 指令集,重新生成高效的推理引擎,并根据计算强度决定任务分配到 GPU、DLA 或 CPU。构建基于任务优先级的调度器,在 Thor 多核系统中为关键路径算法提供实时保障,减少低优先级任务干扰。根据模型推理数据流向设计缓存预取机制,合理利用 L2/L3 缓存和共享内存,提升缓存命中率。引入支持 Thor 平台的性能分析与调试工具(如 Nsight Systems),构建端到端性能剖析能力,发现并定位瓶颈。
这里以某主机厂在 L2++场景中部署的中高阶自动驾驶功能(包含前向多模态感知、变道决策、融合路径规划)为例,原方案基于 OrinX 平台运行,模型推理周期约为 38ms,主要部署于 GPU 上;控制与规划链路部署于 CPU。
在迁移至 Thor 平台后,若未进行任何调优,系统推理时延反而上升至 45ms,主要原因为 GPU 核心与舱内 UI 渲染任务资源冲突,缓存命中率下降明显。
通过以下优化措施:
- 将部分轻量感知模块迁移至 DLA 运行,降低 GPU 压力;
- 引入调度优先级机制,确保感知链路优先获取 GPU 资源;
- 重构部分 Batch 处理逻辑,减小模型中间张量内存带宽消耗;
- 利用 Nsight 分析缓存 Miss 点并优化推理算子排布;
例如,在以下分析结果中:
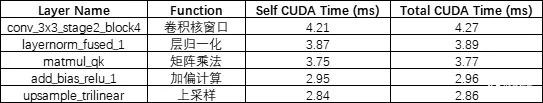
轻量层 layernorm_fused_1 和 add_bias_relu_1 占用了比原则上较多 CUDA 时间但计算密度低,因此被优先考虑迁移到 DLA 或 CPU;而 conv_3x3_stage2_block4 则为高计算密度主干层,保留在 GPU 上更为合理。
最终模型整体推理周期优化至 29ms,控制链路提前 10ms 输出,系统稳定性显著提升,满足舱驾一体高实时性的协同需求。
4、案例分析与实验数据
以某主机厂在 L2++场景中部署的中高阶自动驾驶功能(包含前向多模态感知、变道决策、融合路径规划)为例,原方案基于 OrinX 平台运行,模型推理周期约为 38ms,主要部署于 GPU 上,控制与规划链路部署于 CPU。在迁移至 Thor 平台后,若未进行任何调优,系统推理时延反而上升至 45ms,主要原因为 GPU 核心与舱内 UI 渲染任务资源冲突,缓存命中率下降明显。
通过将部分轻量感知模块迁移至 DLA 运行,降低 GPU 压力,同时引入调度优先级机制,确保感知链路优先获取 GPU 资源,并重构部分 Batch 处理逻辑,减小模型中间张量内存带宽消耗,利用 Nsight 分析缓存 Miss 点并优化推理算子排布。最终模型整体推理周期优化至 29ms,控制链路提前 10ms 输出,系统稳定性显著提升,满足舱驾一体高实时性的协同需求。
5、总结
随着高阶芯片平台的快速更迭,智能驾驶软件系统必须具备良好的跨平台适配能力。单纯依赖硬件算力提升并不能自动带来系统性能提升,必须通过算法重构、资源调度优化、调试工具辅助等手段实现算法的高效迁移。在迁移过程中,研发团队需要:
- 强化系统架构认知 : 深入理解目标平台的硬件资源拓扑、计算核特点与内存结构,避免“黑盒式”部署策略。
- 推进工具链适配与自动化调优 : 建设适配新平台的编译、部署、调试与分析工具集群,推动端到端的性能闭环分析。
- 构建迁移知识体系 : 系统沉淀迁移过程中的通用问题与优化策略,形成工程模板与知识资产,提升多车型/多平台并行开发效率。
- 关注舱驾协同机制设计 : 在多域融合架构下,需从系统层面建立舱驾任务的协同调度机制,包括任务调度 QoS、资源隔离与跨域通信策略,以保障各域关键任务的实时性与稳定性。
未来,随着多传感器融合、端云协同推理、异构计算等技术趋势不断演进,智能驾驶系统对平台适配能力与系统协同性的要求将持续提升。面向更高阶的自动驾驶系统,需要在架构设计阶段即引入可迁移性与协同机制的考量,为后续系统演进提供良好的可扩展性基础。