

作者 |
Shawn Ouyang,复睿微英国研发中心系统架构师;
Dr. Andrew,复睿微英国研究中心 Fellow
介绍
FPGA 是实现可编程数字逻辑的器件。和 CPU、GPU/NPU 和专用 ASIC 等电路架构一样,FPGA 如今也开始被广泛用于神经网络(NN)的实现。
今天,赛灵思和英特尔是全球领先的两家 FPGA 制造商。除此之外,还有几家较小的制造商,包括 Microchip,Lattice Semiconductor 和 GOWIN Semiconductors。
FPGA 的可编程配置的部分包括可编程逻辑块和可编程互连。 除了可编程配置电路之外,FPGA 还可以包括不可配置的 “硬” 块,例如 CPU、I/O 外设和 AI 张量块等等。
那么,FPGA 有什么特别之处可以使它成为比其他平台更适用于神经网络实现吗?我们先不考虑通用但相对较慢的 CPU,将 NN 的 FPGA 实现与 GPU / NPU 和 ASIC 的实现进行一下对比。
事实证明,FPGA 的独特优势在于其可重新配置能力。 这也解释了为什么目前很多学术资源研究如何将 FPGA 高效地用于 NN 实现:由于其可编程性,FPGA 是唯一允许研究人员试用和演示(除了仿真之外) 其新神经网络硬件实现的平台。
如果运行的算法和模型确定,且商用的发货规模足够大,足够可以摊薄一次性研发和投片的成本,那么 ASIC 将是首选,因为相比之下,FPGA 价格昂贵,速度较慢且功耗相对更高。但是目前很多应用场景例如自动驾驶,使用的神经网络算法并不确定,而且制造工艺往往要求非常高,所以一次性研发和投片成本很高,使用 ASIC 便不是最经济实惠的方式。
而在 FPGA 上在针对于相同的 NN 进行优化后,在速度方面可以接近高端 GPU,但它需要更多工程化的工作量。因此,在早期 NN 模型探索阶段,为了快速周转地试验 NN 模型,使用高端最先进的 FPGA 相对通用 GPU 或 NPU 会更有效率。
这使得以下应用 FPGA 比 ASIC 和 GPU 具有独特的优势:
-
用于 ASIC 开发的数字逻辑的原型设计和测试
-
一些最新研究的算法通过 FPGA 搭建自研的数字集成电路并进行演示
-
在没有等效的 ASIC 可用, 或者需要重新配置硬件的情况下,使用 FPGA 进行中小批量和高价值商业应用
与有线或无线通信等应用中为确保互操作性所需的实时处理不同,图像处理 NN 的 FPGA 实现通常不需要满足不灵活的时钟速度要求。每秒可以处理的最大帧数受到逻辑综合后实现的最快时钟频率所限制,通常其频率要慢于 GPU 或者 AISC,但即使时钟频率,但是在功能上仍然能保持一致性,可以用于验证电路逻辑的有效性。
本文下面会对 FPGA 与 ASIC/GPU NN 实现进行定性的比较。 通常在不同的硬件之间进行同等的比较比较困难,因为最终表现的性能不仅取决于算法实现方法,还取决于所使用的特定设备。 此外,GPU 和 FPGA 技术的快速发展以及新一代设备的不断出现也时刻改变着竞争格局。
为什么选择 FPGA?
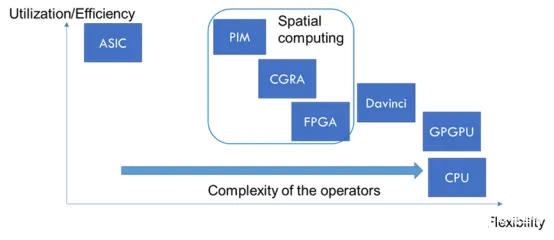
如图所示神经网络实现的硬件架构范例。GPU 是具有高灵活性的通用硬件;但是其利用率 / 效率相对较低,ASIC 专用集成电路可以实现极高的效率和特定算法的集成化,但是不具备灵活性,可以支持的算法范围较少。
而 FPGA 介于 GPU 和 ASIC 之间。FPGA 不会在实现神经网络的所有指标上都 “击败” GPU 和 ASIC,但在某些方面,FPGA 具有独特的优势,例如高能效和高灵活性,这些特点可以使 FPGA 支持大量的加速方法,如量化、稀疏性和数据管道优化等。
总之,对于快速发展的神经网络算法,FPGA 将是 ASIC 数字逻辑原型设计以及测试和技术演示的最佳平台。
2.1 用于神经网络实现的 FPGA 与 ASIC 的对比
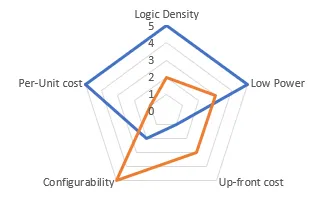
与 ASIC 相比,在同一工艺节点上具有相同逻辑功能特性的 FPGA 速度更慢,更耗电,单位成本更高:但是这是必要付出的代价,以换取 FPGA 可配置性。
对比 ASIC 设计和制造需要很长时间并且价格昂贵,而 FPGA 是可以直接获取的。因此,在中小批量和高价值应用中,FPGA 比 ASIC 更可取,因为它们可以满足所需的容量和 I/O 功能,尤其是在需要硬件需要灵活可重新配置的情况下。
此类应用的一个例子是 SmartNIC,Xilinx 和英特尔都为 AI 场景下其提供了专用产品。
由于 ASIC 硬件不能像 FPGA 那样重新配置,因此在 ASIC 上,最好使用灵活可以执行不同模型的 NPU,而不是硬编码和只支持优化特定模型的 NPU。
在 ASIC 中,加速特定 NN 算子的数字硬件模块可以与通用 NPU 一起使用。尽管这些模块的架构是固定的,但它们还是可以在一定程度上进行配置:例如,接受不同的权重,或在任何给定时间执行一组可支持的算子当中的某一个。
2.2 用于 NN 实现的 FPGA 与 GPU/NPU 的对比
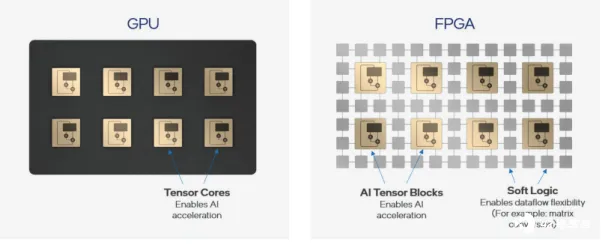
GPU 和 NPU 通常具有一组通用处理单元(张量核),并且 NN 由专用编译器映射在 PE 上部署执行。
对于运行专门针对 FPGA 优化的模型,FPGA 可能比 GPU 更节能。这是因为 可以为 FPGA 设计专用逻辑块,以使用细粒度的量化来缩小特定模型的计算量而保持精度不变,而 GPU/NPU 则仅支持有限的量化的手段。
现代 GPU 卡具有大量非常快的内存(例如安装了 GDDR),相比来说,FPGA 则具有相对较少的片上内存(例如 Xilinx 器件中的 “BlockRAM”)。为了存储模型权重,FPGA 实现通常使用外部 DDR SDRAM。一般来说, FPGA 实现中使用的外部存储器比 GPU 中使用的内存的访问速率要慢。
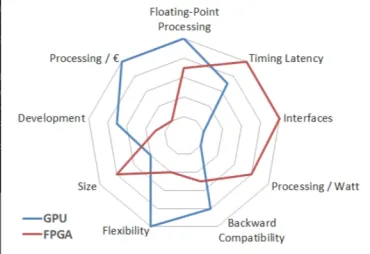
甚至英特尔和赛灵思也承认,FPGA 在所有性能指标上都不比 GPU 好。但是英特尔也指出,与 GPU 相比,FPGA 在低延迟,硬件定制,接口灵活性和功耗方面具有优势。由 Berten DSP 进行客观评估也给出了相似的结论如下图所示。
面向 FPGA 的 NN 模型优化技术
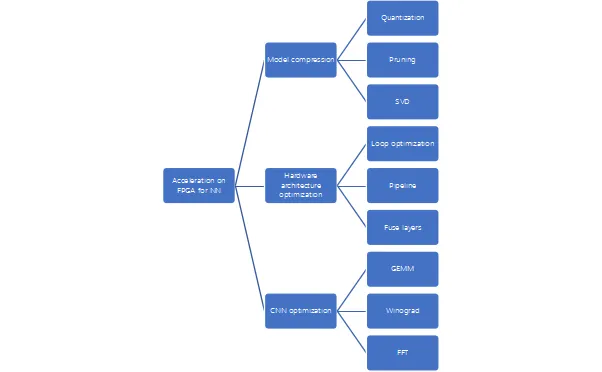
文献 [3] 分析了可用于为 FPGA(或 ASIC)实现准备神经网络的优化技术:
- 模型压缩
1、权重量化
- 可以量化低至 1-2 位,精度损失有限
2、权重裁剪
- 如果在训练时考虑修剪,则由于修剪而导致的准确性损失会减少
3、矩阵分解 SVD
在使用矩阵乘法的情况下,通过使用奇异值分解(SVD) 降低矩阵秩来减少权重和乘法的数量
- 硬件架构优化
1、循环优化
2、数据流
3、层间融合
- 降低复杂性的卷积实现,例如 FFT 和 Winograd 等方法
3.1 FPGA 用于 CNN 网络加速
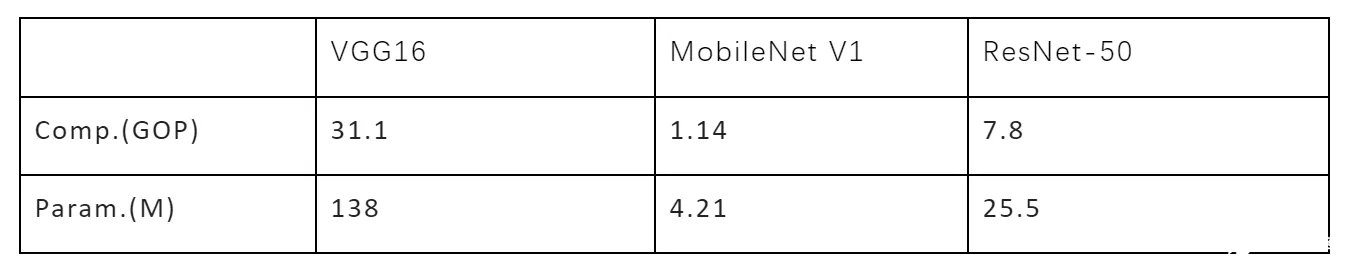
如表 1 所示列举了几种典型的基于 CNN 的神经网络的参数规模和计算量 。
针对于表 1 列举的几种典型的神经网络,收集了多种针对于 CNN 网络的 FPGA 实现方案。
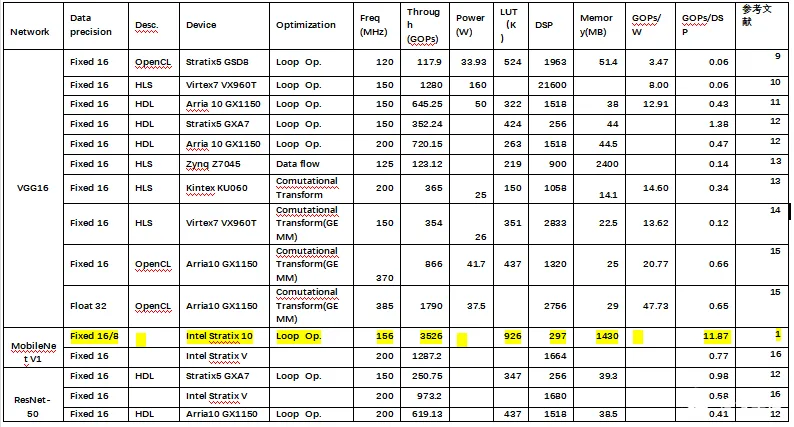
从上表中我们可以看出文献【1】实现所有已知针对 CNN 的论文中最高的计算效率,比起其他最接近的 FPGA 实现方案提升了 2-4 倍的吞吐率和时延,并且在 ImageNet 的数据集上实现了 3000FPS 的推理速度。其主要的原因是通过在 FPGA 上的偏平数据流 flatten streaming 硬件架构加上多精度混合量化等软硬件协同设计,极大地降低了模型的尺寸以及计算复杂度。
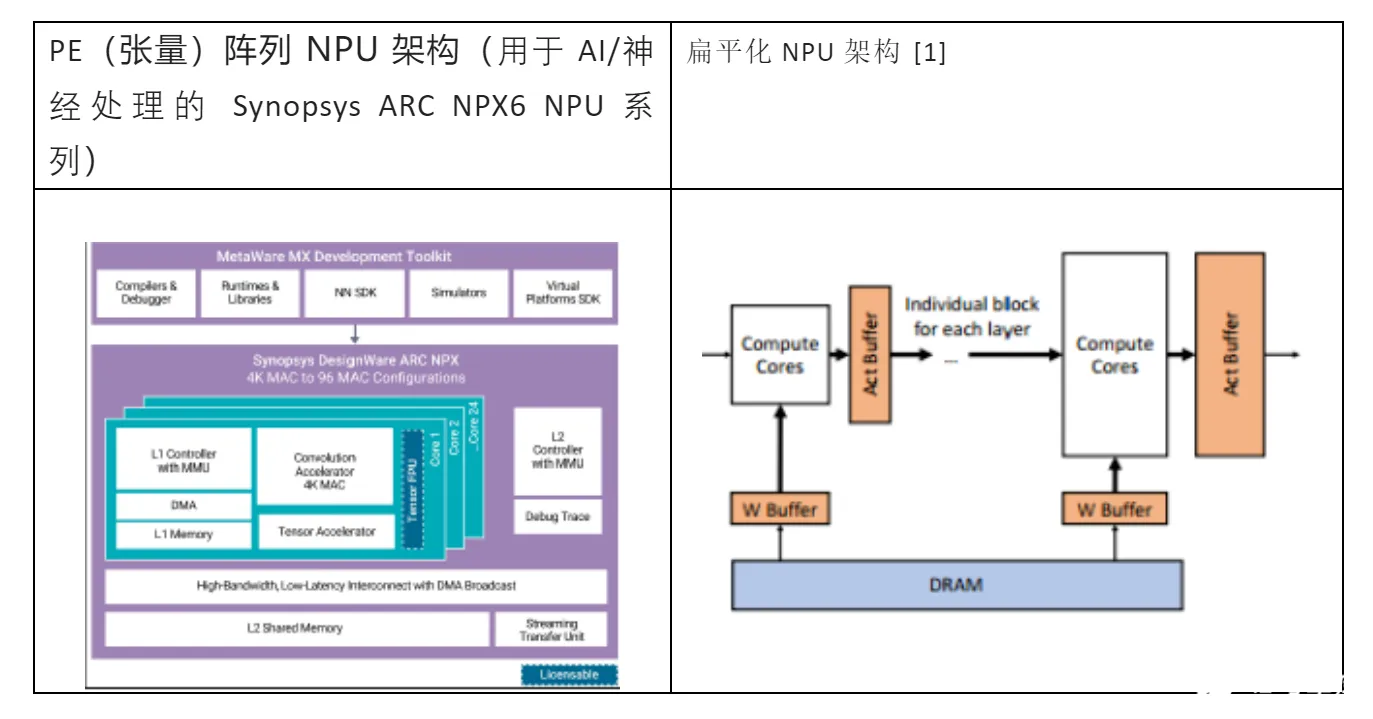
当前大部分的 CNN 的加速器包括 NPU 都是采用同构的大规模脉动阵列。使用此体系结构,可以在不同的 PE 或 PE 集上并行处理多个映像的批处理。NN 层可以通过重复使用相同的硬件来按顺序处理,每层具有不同的配置 / 权重。例如,NVIDIA GPU 包括 “张量核心”。此外,赛灵思和英特尔都提供带有专用硬 AI 模块的 FPGA,可用于实现 PE 阵列。每个 PE 的复杂度可以调整:低复杂度的 PE 可以 只包含一组乘法 / 累加器,而较高复杂度的 PE 可以是一个小型指令集可编程处理器。因为许多不同的卷积层重复使用相同的硬件计算单元,所以脉动 PE 阵列的是分时复用的。然而,不同的卷积层输入数据大小、通道数、卷积核大小以及不断出现例如 depthwise 等新兴的卷积结构都使得在单个大型计算核心上实现高效越来越困难。
因此,在文献【1】中采用了另外一种硬件架构方式,将 CNN 网络按照各层进行拆解并且在按照流水线的方式 stream 到不同的计算单元中。每一个计算单元都是激活值输入驱动的,为了
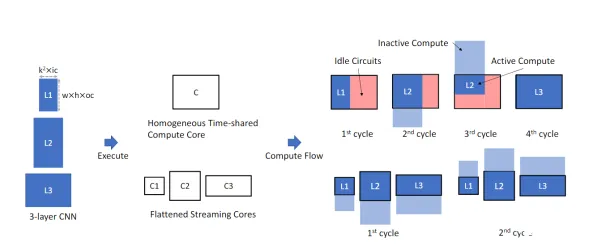
如下图所示 3 个不同的卷积层 (L1,L2,L3)分别在同构脉动阵列以及扁平化架构上的实现方式。在同构脉动阵列架构下采用一个大型的 PE 阵列的计算单元 C,而扁平化架构则采用了 3 个较小的计算单元 C1,C2 和 C3。由于 3 层卷积的大小尺寸各不相同,采用单个大型同构阵列架构会使得计算单元出现空闲的部分,从而硬件利用率低下。而扁平架构的下有多个不同大小的计算单元适配各个卷积层尺寸,因此充分利用硬件资源。如下图所示,同构阵列架构需要 4 个 cycle 才能完成 3 个卷积层的计算,而扁平架构只需要 2 个 cycle。
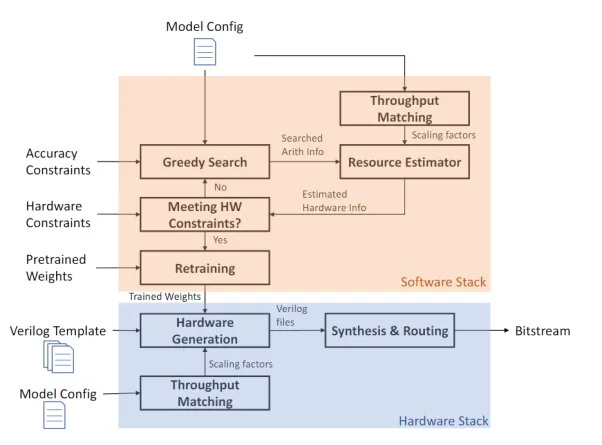
在扁平架构设计的基础上,结合混合多精度的量化以及更多逻辑单元的 FPGA 甚至多块 FPGA 级联,作者提出一种自动化的工具框架可以将完整的 CNN 网络映射到 FPGA 当中。该框架首先使用自研的算法对预训练好的 CNN 模型进行多种精度下的定点化和偏移搜索,由此产生出量化后并能满足精度要求的优化后模型。也正是因为该扁平架构中由多个计算单元组成,所以可以每个计算单元可以使用不同的带宽精度进行量化,以确保精度损失最低同时也能压缩模型计算量。在上述阶段中,该框架同时也会对硬件资源进行精准的估计,包括时延,LUT 以及 BRAM 的使用率等等。在根据产生的优化模型和资源估算后,该框架会根据事先准备好的 verilog 库产生 systemVerilog 并最终经过综合后生成 FPGA 硬件文件。
3.2 FPGA 用于 Transformer 网络加速
如表 3 所示列举了几种典型的基于 tansformer 的神经网络的参数规模和计算量。
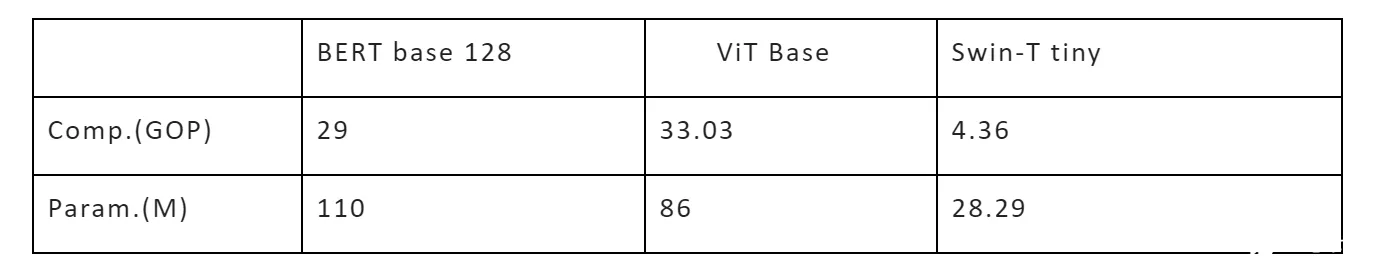
针对于表 3 列举的几种典型的神经网络,收集了多种针对于 transformer 网络的 FPGA 实现方案。
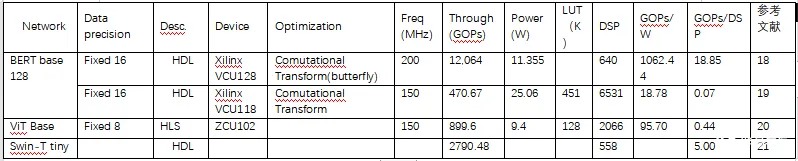
在上表中的实现方案中,文献【18】达到的功耗和硬件效率最高,其主要是针对 transformer 网络中 attention 模块以及前向传播网络(FFN)也叫多层感知机 (MLP) 进行优化。
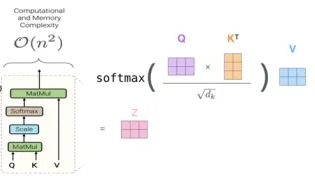
在 transformer 网络中的典型 self-attention 公式表达如下图所示,self-attention 模块中对于矩阵乘,如果有序列长度为 n,那么时间复杂度就为 O(n^2),同时也会消耗 N^2 的时间和存储。
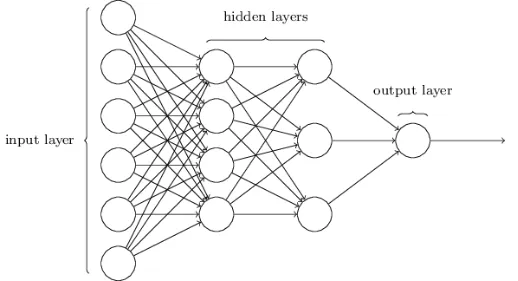
前向传播网络(FFN)的结构图如下所示,分为输入层,隐藏层和输出层。其中每一层有若干个神经元,因此每层都会定义权重矩阵,具体计算细节在此不展开,重点是每层之间的计算本质也是矩阵向量乘。
针对于 attention 以及 FFN 模块当中都存在矩阵矩阵乘以及矩阵向量乘的计算,而对于矩阵进行稀疏分解是减少矩阵计算复杂度和存储空间的有效方法,即每个矩阵特定的结构都有一个压缩的表示,并相应地可以实现一个较小复杂度的乘法算法,而不是消耗 O(n^2)计算复杂度的大小的矩阵向量乘法算法。
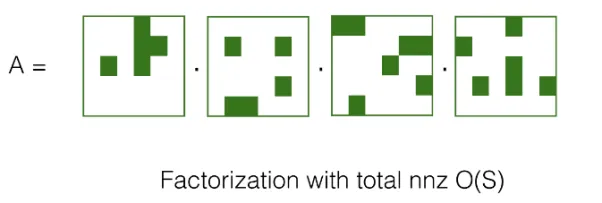
如下图所示目前学术界有多种不同的方式稀疏方案近似矩阵乘,包括有低秩 (low Rank)、滑窗(Sliding Window)、蝶式 (Butterfly)、随机(Randon)以及分块(Block-Wise)。
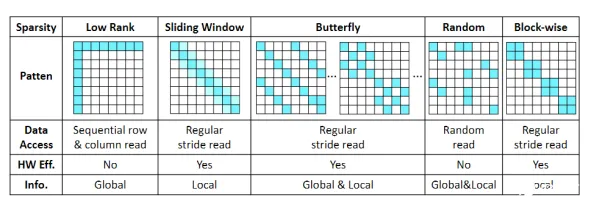
选择采用何种矩阵压缩的方式主要考虑几点因素,首先,能否在单一稀疏模式下同时捕获局部和全局信息;其次,稀疏或者压缩模型能够对于硬件设计足够友好;最后,稀疏或者压缩模式能否同时支持 attention 机制以及前向传输网络 FFN 两者需求。
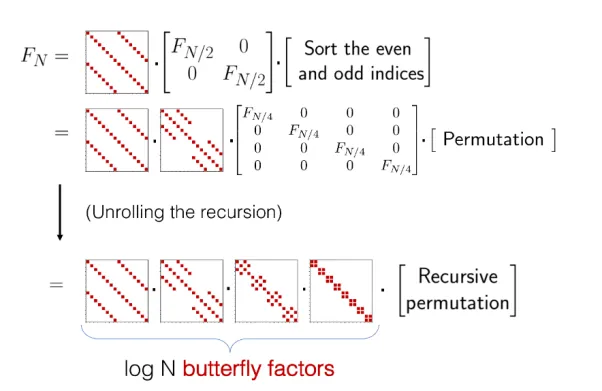
对比几种矩阵压缩和稀疏方式,蝶式矩阵分解模型能够满足以上几点要求,即矩阵可以通过 log (N) 个稀疏的蝴蝶因子矩阵乘积来表示,可以将计算复杂度和内存复杂度从 O (N2) 降低到 O (N log N)。
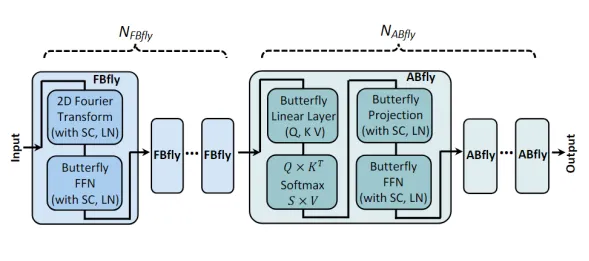
文献【17】提出了一种名叫 FABNet 的基于 betterfly 的网络架构,该架构由 ABfly 和 FBfly 两种块混合而成。其中 ABfly 模块主要是通过蝶式变换来实现,保留了 attention 模块的主干,并使用蝶式分解压缩了所有的线性层。ABfly 块从三个蝶式线性层开始,生成 Q, K 和 V 矩阵后被输入到一个 vanilla multi-head attention 层和获得不同 token 之间的关系的另一个蝴蝶线性层中,最后由两个蝶式线性层组成的蝴蝶前向传输网络(FFN)进行额外的处理。而为了进一步提升硬件的效率,除了 ABfly 之外,网络中还有 FBfly 模块,该模块中首先有通过快速傅里叶变换(FFT)实现了 2D 傅里叶变换,将不同的输入 token 进行了有效地缓和,这使得 FBfly 模块后续的蝶式前向传输网络(FFN)可以处理更长的序列,尽管傅里叶变换可能使得精度受损,但是比起蝶式变换使用了较少的计算和存储消耗。FBfly 和 ABfly 在网络中的数量可以作为超参进行配置,以寻求达到精度和效率的最佳平衡。
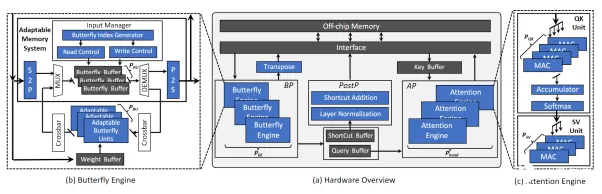
针对于 transformer based 的可适应蝶式硬件加速器架构如下图所示,主要由 Butterfly Processor (BP), Attention Processor (AP),Post-Processing Processor (PostP) 以及 on-chip buffer 等等组成。BP 又包含了多个 Butterfly Engine(BE),主要用来针对蝶式变换以及快速傅里叶变化进行加速。AP 包含了多个 Attention Engien (AE),而每个 AE 又由一个 QK 单元和 SV 单元组成。QK 单元是用来计算 query 和 key 之间的矩阵乘以及 softmax,而 SV 则接受来自 QK 单元的输出并且乘以 Value 向量产生 attention 最终的结果。
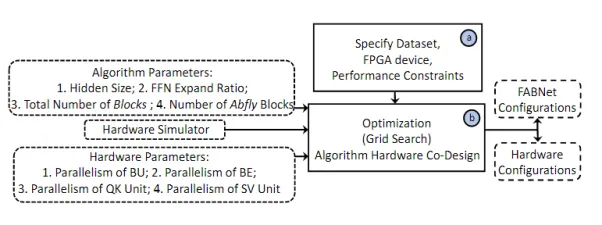
如上文提到的 FABfly 网络当中的 ABfly 模块和 FBfly 模块的数量可以作为超参进行配置。基于这两个参数,开发了一种软硬件协同设计方法如下图所示,实现了神经架构和硬件设计的设计空间探索。
结论
本文分析了 FPGA 和 GPU 以及 ASIC 的对比,FPGA 不会在所有指标上 “击败” GPU 和 ASIC 来实现 NN。通过列出多种 FPGA 实现神经网络加速器的方案,以及针对于 CNN based 和 transformer based 两个具体实例分析,FPGA 在软硬件协同设计实现模型量化和稀疏化具有有独特的优势,即使最终产品商业化可能会采用 ASIC 形态,FPGA 仍然是 ASIC 数字逻辑原型设计以及测试和技术演示的最佳平台。
参考引用
[1] Y. Zhao et al., ‘Automatic Generation of Multi-precision Multi-arithmetic CNN Accelerators for FPGAs’, 2019, doi: 10.48550/ARXIV.1910.10075.
[2] ‘Real Performance of FPGAs Tops GPUs in the Race to Accelerate AI’, Intel. https://w (Naveen Suda, 2016) ww.intel.com/content/www/us/en/products/docs/programmable/fpga-performance-tops-gpus-white-paper.html (accessed Nov. 13, 2022).
[3] M. Lebedev and P. Belecky, ‘A Survey of Open-source Tools for FPGA-based Inference of Artificial Neural Networks’, in 2021 Ivannikov Memorial Workshop (IVMEM), Nizhny Novgorod, Russian Federation, Sep. 2021, pp. 50–56. doi: 10.1109/IVMEM53963.2021.00015.
[4] Y. Ma, N. Suda, Y. Cao, S. Vrudhula, and J. Seo, ‘ALAMO: FPGA acceleration of deep learning algorithms with a modularized RTL compiler’, Integration, vol. 62, pp. 14–23, Jun. 2018, doi: 10.1016/j.vlsi.2017.12.009.
[5] J. Shen, Y. Huang, Z. Wang, Y. Qiao, M. Wen, and C. Zhang, ‘Towards a Uniform Template-based Architecture for Accelerating 2D and 3D CNNs on FPGA’, in Proceedings of the 2018 ACM/SIGDA International Symposium on Field-Programmable Gate Arrays, Monterey CALIFORNIA USA, Feb. 2018, pp. 97–106. doi: 10.1145/3174243.3174257.
[6] K. Guo, S. Zeng, J. Yu, Y. Wang, and H. Yang, ‘[DL] A Survey of FPGA-based Neural Network Inference Accelerators’, ACM Trans. Reconfigurable Technol. Syst., vol. 12, no. 1, pp. 1–26, Mar. 2019, doi: 10.1145/3289185.
[7] H. Mujtaba, ‘NVIDIA GeForce RTX 3090, GeForce RTX 3080, GeForce RTX 3070 Graphics Cards Custom Model Roundup’, Wccftech, Sep. 01, 2020. https://wccftech.com/nvidia-geforce-rtx-3090-geforce-rtx-3080-geforce-rtx-3070-graphics-cards-custom-model-roundup/ (accessed Nov. 19, 2022).
[8] A. Shawahna, S. M. Sait, and A. El-Maleh, ‘FPGA-Based Accelerators of Deep Learning Networks for Learning and Classification: A Review’, IEEE Access, vol. 7, pp. 7823–7859, 2019, doi: 10.1109/ACCESS.2018.2890150.
[9] Naveen Suda, Vikas Chandra, Ganesh Dasika, Abinash Mohanty, Yufei Ma, Sarma Vrudhula, Jae-sun Seo, and Yu Cao. Throughput-Optimized OpenCL-based FPGA Accelerator for Large-Scale Convolutional Neural Networks. In Proceedings of the ACM/SIGDA International Symposium on Field-Programmable Gate Arrays - FPGA '16, pages 16–25, 2016.
[10] Chen Zhang, Zhenman Fang, Peipei Zhou, Peichen Pan, and Jason Cong. Caffeine: Caffeine: Towards uniformed representation and acceleration for deep convolutional neural networks. In Proceedings of the International Conference on Computer-Aided Design - ICCAD '16, pages 1–8, New York, New York, USA, 2016. ACM
[11] Yufei Ma, Yu Cao, Sarma Vrudhula, and Jae-sun Seo. Optimizing Loop Operation and Dataow in FPGA Acceleration of Deep Convolutional Neural Networks. In Proceedings of the ACM/SIGDA International Symposium on Field-Programmable Gate Arrays - FPGA '17, pages 45–54, 2017.
[12] Yufei Ma, Yu Cao, Sarma Vrudhula, and Jae-sun Seo. An automatic RTL compiler for high-throughput FPGA implementation of diverse deep convolutional neural networks. In Proceedings of the International Conference on Field Programmable Logic and Applications - FPL '17, pages 1–8. IEEE, 9 2017.
[13] Stylianos I Venieris and Christos Savvas Bouganis. Latency-Driven Design for FPGA-based Convolutional Neural Networks. In Proceedings of the International Conference on Field Programmable Logic and Applications - FPL '17, 2017.
[14] Chen Zhang, Zhenman Fang, Peipei Zhou, Peichen Pan, and Jason Cong. Caffeine: Caffeine: Towards uniformed representation and acceleration for deep convolutional neural networks. In Proceedings of the International Conference on Computer-Aided Design - ICCAD '16, pages 1–8, New York, New York, USA, 2016. ACM.
[15] Jialiang Zhang and Jing Li. Improving the Performance of OpenCL-based FPGA Accelerator for Convolutional Neural Network. In Proceedings of the ACM/SIGDA International Symposium on Field-Programmable Gate Arrays - FPGA '17, pages 25–34, 2017.
[16] R. Zhao, H.-C. Ng, W. Luk, and X. Niu. Towards efficient convolutional neural network for domain-specific applications on FPGA. arXiv preprint, 2018.
[17] Yufei Ma, Yu Cao, Sarma Vrudhula, and Jae-sun Seo. An automatic RTL compiler for high-throughput FPGA implementation of diverse deep convolutional neural networks. In Proceedings of the International Conference on Field Programmable Logic and Applications - FPL '17, pages 1–8. IEEE, 9 2017
[18] Fan, H., Chau, T., Venieris, S. I., Lee, R., Kouris, A., Luk, W., Lane, N. D., & Abdelfattah, M. S. (2022). Adaptable Butterfly Accelerator for Attention-based NNs via Hardware and Algorithm Co-design. arXiv. https://doi.org/10.48550/arXiv.2209.09570
[19] B. Li, S. Pandey, H. Fang, Y. Lyv, J. Li, J. Chen, M. Xie, L. Wan, H. Liu, and C. Ding, "FTRANS: Energy-Efficient Acceleration of Transformers using FPGA," in ACM/IEEE International Symposium on Low Power Electronics and Design (ISLPED), 2020, pp. 175–180.
[20] Li, Z., Sun, M., Lu, A., Ma, H., Yuan, G., Xie, Y., Tang, H., Li, Y., Leeser, M., Wang, Z., Lin, X., & Fang, Z. (2022). Auto-ViT-Acc: An FPGA-Aware Automatic Acceleration Framework for Vision Transformer with Mixed-Scheme Quantization. arXiv. https://doi.org/10.48550/arXiv.2208.05163
[21] W. Hu et al., "Vis-top: Visual transformer overlay processor," arXiv preprint arXiv:2110.10957, 2021.







